
自分の知識を「3層」で資産に変える。KarpathyのLLM Wikiという設計
- RAGが質問ごとに検索して答えを組み立てるのに対し、LLM Wikiは整理した知識をMarkdownとして残し、次の回答へ生かします。
- 原本・Wiki・ルールの3層で、AIが知識を更新し続け、人は書き方と判断基準を定めます。
- まずは何度も探し直す個人の1領域から始め、組織へは権限の境界ごとに小さく広げるのが現実的です。
AIに同じことを、何度も聞き直していませんか。
先週いい答えをもらったはずなのに、記録が残っていないので、また一から質問する。便利に使っているのに、手元には何も積み上がっていない。
この記事では、その違和感に名前を付けた「LLM Wiki」という設計を、RAGとの違い、3層の仕組み、そして個人がまず何から始めればいいのかという順で整理します。
目次
RAGは毎回捨てている。LLM Wikiは残していく
2026年4月、Andrej Karpathy氏が「LLM Wiki」と題した設計メモを公開しました。OpenAIの創業メンバーで、Teslaのくるま向けAI開発を率いた人物です。
内容は製品の発表ではありません。「LLMに、自分専用のWikiを書かせ続ける」という、使い方そのものの提案です。
比較の相手はRAGです。
※ RAG(Retrieval-Augmented Generation)とは、社内文書などをAIに検索させて読ませ、その場で回答させる仕組みのこと。いま多くの企業が入れているのは、だいたいこの形です。
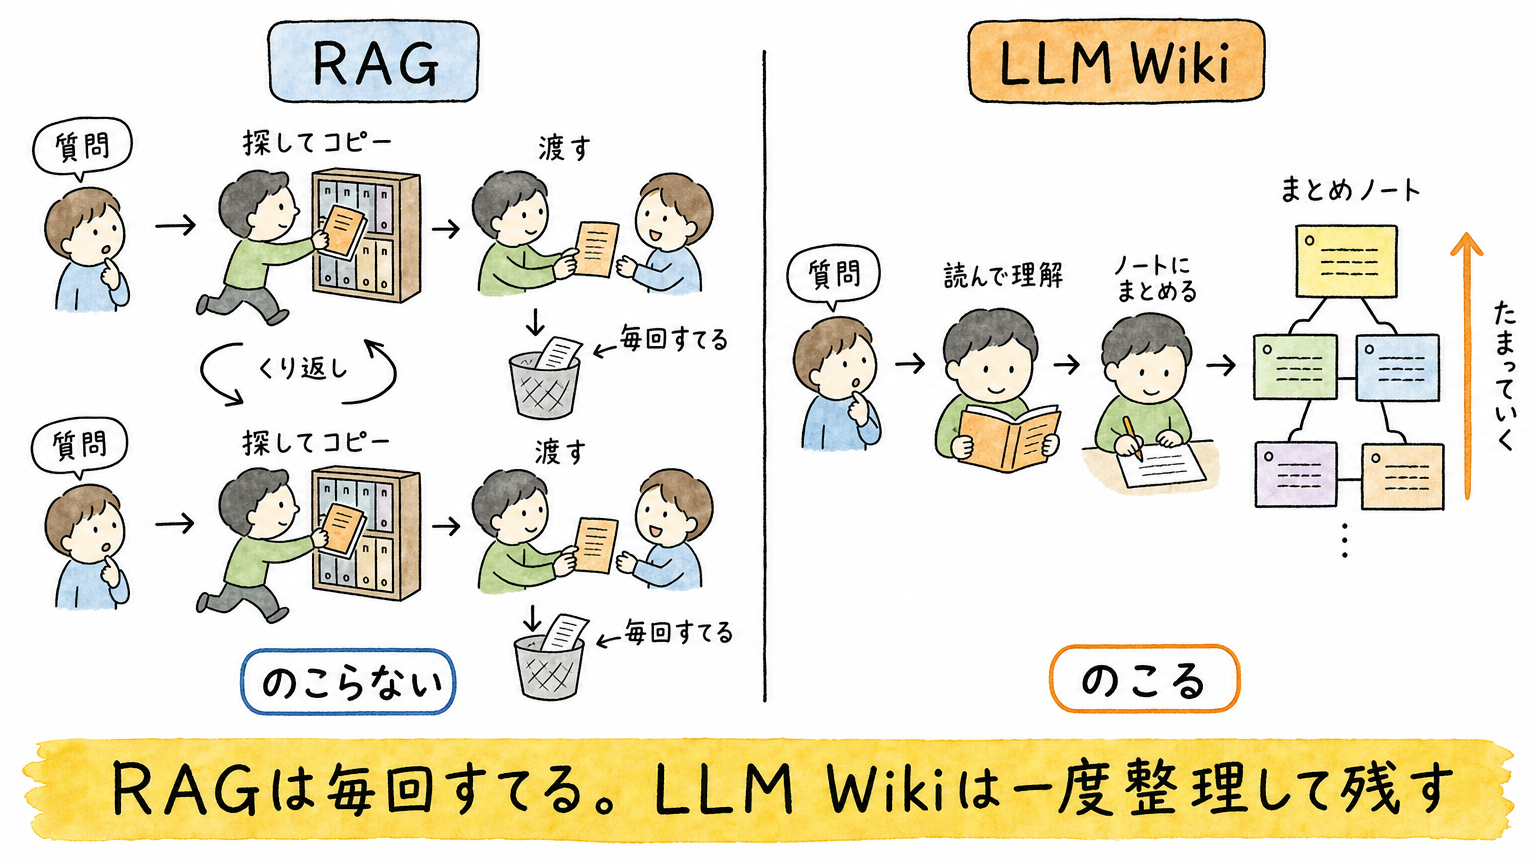
RAGは、質問が来るたびに資料を探し、答えを組み立て、そして捨てます。次に同じことを聞かれたら、また一から探す。
便利ですが、何も積み上がりません。
LLM Wikiは、そこを変えます。資料を読んだ時点で要点を抜き出し、Markdownのページとして書き残す。次の質問には、その整理済みのページを見て答える。
Karpathy氏はこれを「持続的で、複利で積み上がる成果物(a persistent, compounding artifact)」と表現しています。
図書館でたとえるなら、RAGは司書に該当ページのコピーを取ってきてもらう仕組みです。LLM Wikiは、司書が調べるたびに館内の「まとめノート」を書き足していく仕組みになります。
「原本・Wiki・ルール」の3層で動く
仕組みは3つの層でできています。ここが記事の中心なので、少しだけ丁寧に見ます。
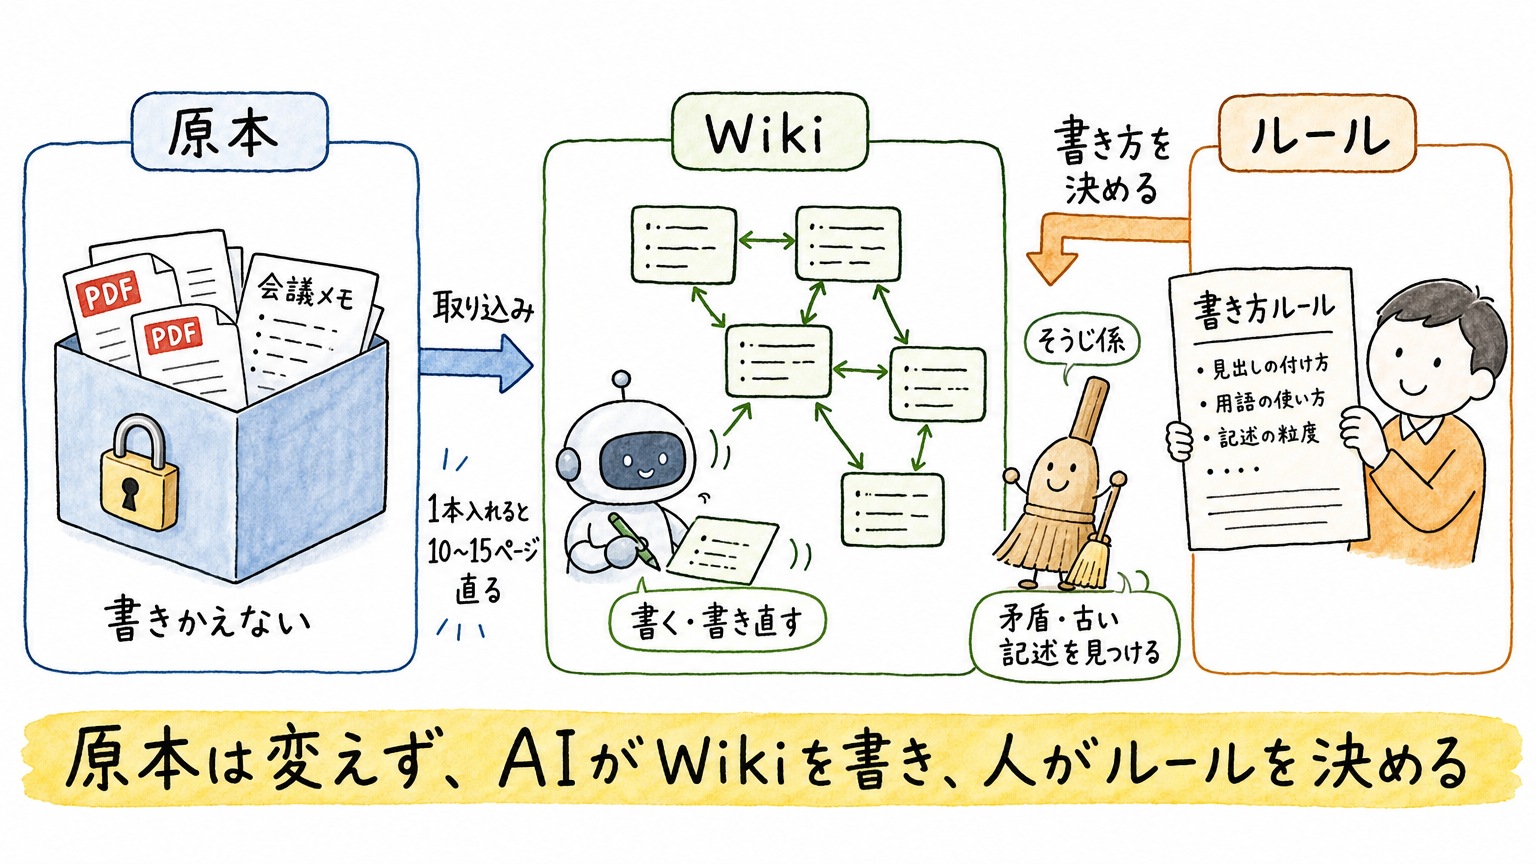
1つめが原本の層です。PDF、記事、論文、議事録。もとの資料をそのまま置き、絶対に書き換えません。あとから「この記述の出どころは?」と辿れるようにするためです。
2つめがWikiの層。AIが生成・更新するMarkdownのページ群で、相互にリンクされています。
3つめが、ルールの層。ページの種類、命名のしかた、リンクの張り方、出典の書き方を定義した設定文書です。原文では「schema」と呼ばれます。
そして、この3層の上で3つの操作が回ります。
取り込み(ingest)では、新しい資料を1本入れると、AIが既存ページを読みにいき、関係するページをまとめて書き換えます。ITmediaの解説でも触れられているとおり、1本の資料が10〜15ページに影響することもあります。
照会(query)は、質問に答える操作です。ただし普通のチャットと違うのは、いい回答が出たらそれ自体を新しいページとして保存し、知識ベースへ組み込むところにあります。
健全性チェック(lint)は、掃除係です。ページ同士の矛盾、古くなった記述、どこからもリンクされていない孤立ページを定期的に洗い出します。
地味ですが、この掃除係が一番効いています。 書きっぱなしの社内Wikiが数年で誰も見なくなるのは、まさにこの役割が不在だったからです。
ここまで読むと、AIの賢さが成否を決めそうに見えます。ところが違います。決めるのは3つめのルール層、つまり人間が書く編集方針のほうです。AIは与えられたルールどおりに、疲れず何千ページでも書き続けます。型の歪んだたい焼き機で、たい焼きを1万個焼くようなことが起きうる、ということです。
まずは自分ひとりの領域から始める
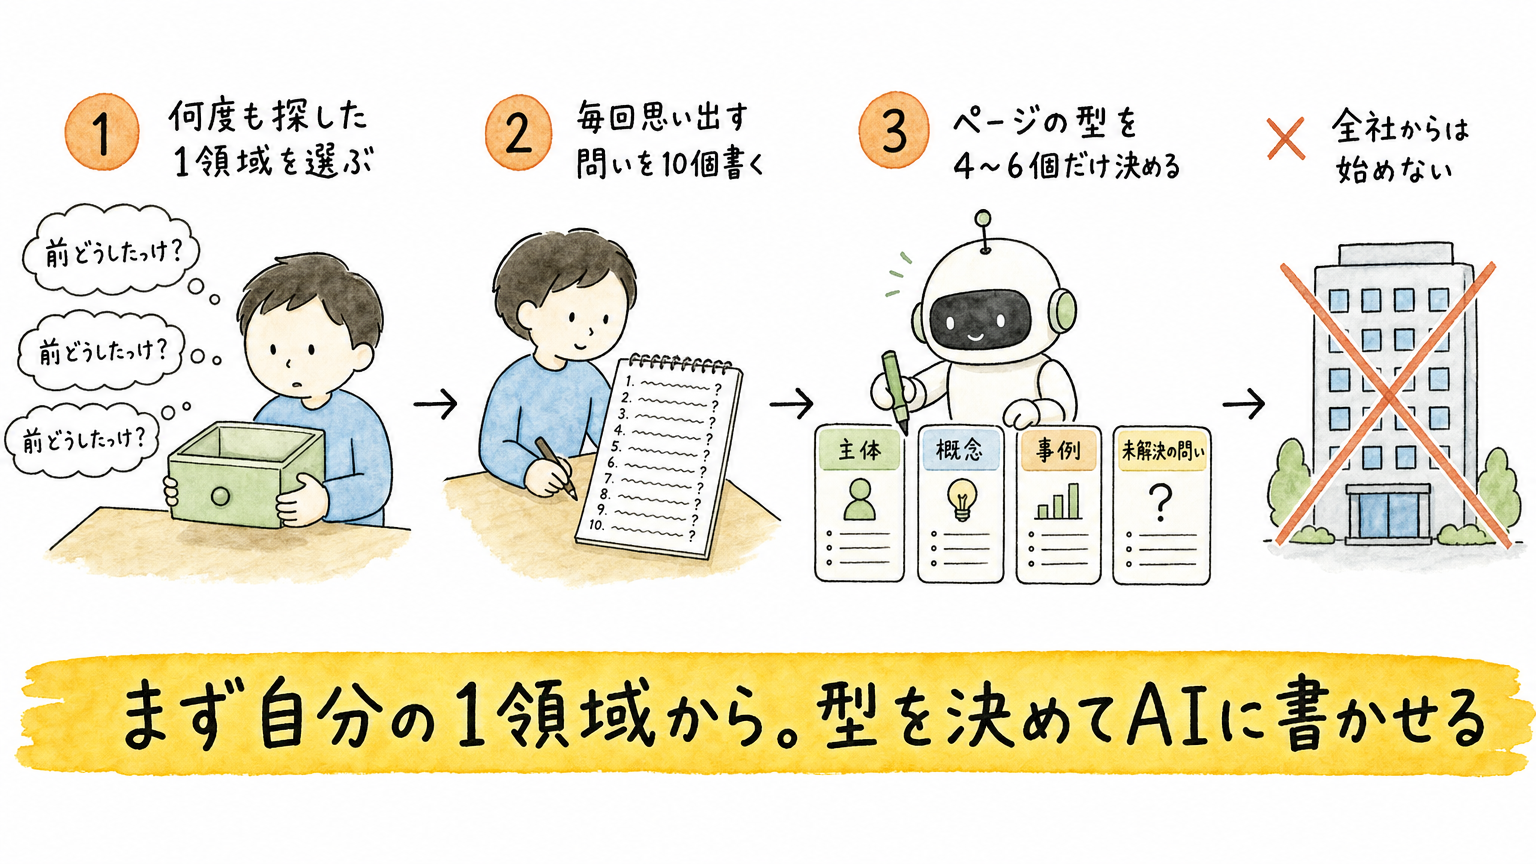
この仕組みを、いきなり全社のナレッジ共有に持ち込むと、たいてい失敗します。誰の資産でもないものに、誰も真面目なルールを書かないからです。共用の冷蔵庫が必ず荒れるのと同じ構造だと思ってください。
実際、Karpathy氏自身も個人利用から入っています。彼はXの投稿で、最近のトークン消費の大部分が「コードを操作することより、知識を操作すること(less into manipulating code, and more into manipulating knowledge)」に向かっていると書いています。
研究テーマごとに個人用の知識ベースを育て、閲覧はObsidianを「IDEのフロントエンド」として使う。ある研究テーマ1つ分のWikiは、約100本の記事、約40万語まで育っているそうです。文庫本にすると数冊分の厚みになります。
人がやるのは資料を選ぶことと、いい問いを立てること。残りの退屈な整理は全部AIに渡す。原文の言い方では「LLMは退屈しない」からです。
では、あなたは何から始めればいいか。おすすめは、この1年で3回以上「前どうしたっけ」と探した領域を1つ選ぶことです。
担当している顧客、扱っている製品、追いかけているテーマ。そこには、あなたの頭の中にしかない整理が必ずあります。
具体的な手順としては、まず毎回思い出している問いを10個書き出します。次に、それに答えるためのページの種類を4〜6個だけ決めます。たとえば「主体」「概念」「事例」「判断基準」「未解決の問い」。
最後の「未解決の問い」は、ぜひ入れてみてください。分かっていないことを置く場所がないと、AIは空白を推測で埋めにいきます。宿題ノートを別に持っておくイメージです。
ツールは、専用アプリも出始めています。nashsuのllm_wikiは、PDFやWord、スライドや画像を取り込んで知識グラフまで作るデスクトップアプリです。ほかにも、Karpathy氏の設計をそのまま実装したWeb版や、Obsidian用のプラグインが公開されています。
ただ、選ぶ基準は機能より「中身がMarkdownのフォルダとして残るか」です。サービスが終わっても、フォルダごとコピーすれば資産は残る。ここだけは譲らないほうがいいと思います。
組織へ広げられるか——ここから先は未開拓
個人で回り始めると、当然「これ、チームでも使えるのでは」という発想が出てきます。
引き継ぎの問題を考えると、期待は大きい。退職や異動のたびに失われていた数年分の文脈が、Wikiとして残る。専門性が高く、人の入れ替わりで知見が消えている会社ほど、効きそうに見えます。
ただ、正直に言えば、組織展開はまだ未開拓の領域です。少なくとも2つ、大きな壁があります。
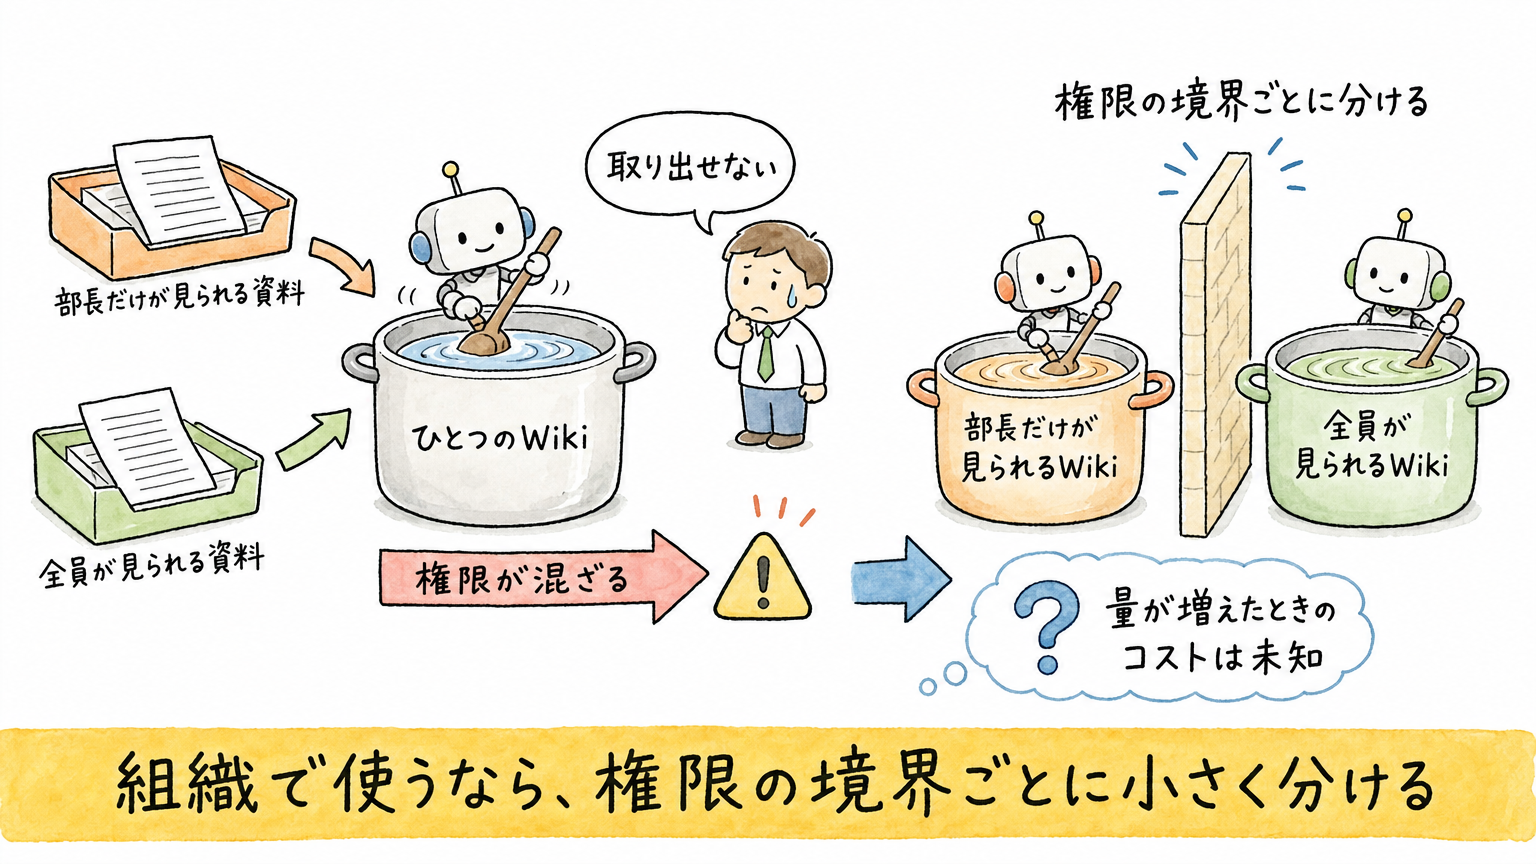
1つは、アクセス権限です。LLM Wikiは複数の資料を統合してページを作ります。つまり、部長しか見られない資料の要点が、全員が読めるページに溶け込む。味噌汁に入れた具は、もう取り出せません。内部統制や監査の観点では、これは無視できない話になります。
もう1つは、量の問題です。資料が数万本になったとき、取り込みのたびに関連ページを書き換えるコストがどこまで現実的なのか。ここは実装やモデルによって大きく変わり、確かな相場観はまだありません。分からない、というのが今の正確な答えです。
だからこそ、順番が大事だと思っています。個人で1領域を回し、ルールを書く感覚を掴む。そのうえで、権限の境界ごとに小さく区切って広げていく。いきなり全社の巨大Wikiを設計しようとすると、たぶん何も残りません。
知識を残す仕組みは、まず自分の机の引き出しから作る。 フロア全体を片付けようとした人は、だいたい途中で力尽きます。
今週、1つだけ決めてみてください。あなたが何度も探し直している領域は、どこですか。
よくある質問(FAQ)
Q1. LLM WikiとRAGの一番大きな違いは何ですか?
RAGは質問のたびに資料を探して回答を組み立てます。一方のLLM Wikiは、資料を読んだ時点で要点をMarkdownへ書き残し、整理済みのページを次の照会や更新に使います。
Q2. 3層のうち、成否を左右するのはどこですか?
原本を変えずに残し、AIがWikiを更新する前提では、ページの種類、命名、リンク、出典の書き方を定めるルール層が重要です。記事では、AIの性能だけでなく人が書く編集方針が成否を決めると整理しています。
Q3. 最初はどの範囲から始めるとよいですか?
この1年で3回以上「前どうしたっけ」と探した個人の1領域から始めます。毎回思い出す問いを10個書き出し、「主体」「概念」「事例」「判断基準」「未解決の問い」など4〜6個のページの型を決めるのが具体的な第一歩です。
AIに知識を整理させる話の先には、AIに仕事そのものを渡す話が待っています。YouTubeでは毎週日曜15時に、その週のAIニュースをまとめて解説しています:https://www.youtube.com/@iketomoch
Wikiを育てる作業をClaudeに任せていくと、自然とエージェント的な使い方に近づいていきます。その具体的な仕事術は書籍にまとめました:https://amzn.to/4eTUVG1
読んで理解する段階から、2時間手を動かして自分専用の道具を1つ残す段階へ。AI活用ハンズオンのアーカイブはこちらです:https://handson.workstyle-evolution.co.jp/
■合わせて読みたい
■関連記事

公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ