Mercury 2.5リリース、拡散型LLMはいま何ができるのか
- Mercury 2.5は毎秒1,107トークンを掲げる拡散型LLMで、生成を数回のステップで整えるため計算回数を抑えられる。
- 強みは要約や判定など、AIエージェントの裏方工程を速く安くすることにある。一方で、同時に確定するトークンが噛み合わず出力が荒れる弱点もある。
- 発表値は自社報告が中心のため、回数の多い1工程だけを実際の自社タスクで測るのが現実的な試し方になる。
Inceptionが拡散型LLM「Mercury 2.5」を発表した。掲げている数字は毎秒1,107トークン。いま主流のモデルの、およそ10倍の速さにあたる。
拡散型LLM(dLLM)は、私たちが使っているChatGPTやClaudeとは、文章の作り方そのものが違う。確かに速いのだが、速い理由があり、その代わりに失っているものもある。
この記事では、拡散型LLMがどういう仕組みなのか、Mercury以外にどんなプレイヤーがいるのか、そして「速さ」が実際にどこで効くのかを整理する。
目次
拡散型LLMとは何か
いまの主流は自己回帰型と呼ばれる方式だ。文章を左から1トークンずつ、次の1個を予測しては置く、を繰り返す。しりとりを高速でやっているようなもので、100トークン出すには100回の計算がいる。
拡散型はここを変える。最初に全部が空欄の原稿用紙を用意して、そこを数回のステップで埋めていく。1回目でざっくり、2回目で修正、3回目で仕上げ。写真の現像で、ぼんやりした像が数回で鮮明になっていく感じに近い。
計算の回数そのものが減るから速い。ELYZAも自社の日本語拡散モデルについて、生成ステップを絞れば推論の回数を大きく減らせると説明している。
代表格がInceptionのMercuryシリーズだ。Mercury 2.5は、推論の深さを調整できるtunable reasoning、複数ツールの並列呼び出し、スキーマに沿ったJSON出力に対応する。自社API、OpenRouter、Basetenから使える。
ただ、Inceptionだけの話ではない。Googleは実験モデルのGemini Diffusionを公開し、今年にはDiffusionGemmaをオープンソースで出した。日本でも今年、ELYZAが日本語特化の拡散言語モデルを商用利用可能な形で公開している。研究の実験段階から、選べる道具の段階に入りつつある。
弱点も構造から来る。同じステップで同時に確定したトークンは、お互いを見ずに独立に決まっている。研究でも、これが品質低下の主因だと指摘されている。5人が相談せずに一言ずつ書いて、それをつなげて1つの文にするようなものだ。実際に触ってみると、文法は通っているのに文脈が微妙にズレる、という感触がある。
もちろんステップを増やせば直る。ただし増やした分だけ遅くなる。速さと質は、ここで正面からぶつかる。
なぜ「速さ」がここまで効くのか
人が読む用途なら、いまの速度でもう十分だ。効いてくるのは、AIがAIを呼ぶ使い方が増えたときである。
エージェントに1つ頼むと、その裏では計画・検索・並べ替え・要約・検証と、何十回もモデルが走っている。客席からは注文1つに見えても、厨房では何工程も動いている。1回あたりの待ちが数秒でも、何十回も積み上がれば体感はまるで変わる。
Augment Codeの事例がわかりやすい。AIコーディング支援の会社で、長い会話履歴を要約する工程だけをMercuryに置き換えた。結果、150秒ほどかかっていたその処理が27秒になり、コストも大きく下がった。全部を入れ替えたわけではなく、1工程だけを差し替えている点が重要だ。
音声はもっと直接的だ。OpenCallの音声エージェントは、応答時間の中央値が0.4秒から0.2秒未満になったと報告されている。電話で0.5秒黙られると「切れた?」と思う。会話では、速度が品質そのものだ。
なおこれらの数字は、いずれもInceptionのブログとプレスリリース内の顧客報告であり、第三者が検証したものではない。看板の「Mercury 2比で知能40%向上」も、どのベンチマークの話なのか指標名が公開されていない。ここは割り引いて読むところだ。
こんな使い方があり得るのでは
向いているのは、型の決まった裏方作業だと思う。要約、分類、タグ付け、どのツールを呼ぶかの判定、構造化JSONの生成。多少ぎこちなくても、下流の処理が受け取れれば成立する。議事録の下書きと、社長名義の挨拶文とで、求められる品質が違うのと同じだ。
逆に、自分で調べて考え抜く仕事は苦手そうに見える。公開されているスコアでも、決められた手順でツールを叩く種類のベンチマークは高い一方、深い調査を要するものは大きく落ちている。
現実的な入り口は、社内で動いているAI処理を工程に割ってみることではないか。入力の整形、検索、要約、判定、生成、チェック。それぞれ何秒かかって、いくらかかっているか。たいていは「呼び出し回数の大半が要約と判定で、そこに最上位モデルを使っている」という絵が出てくる。回数の多い1工程だけ差し替えて測ってみる、くらいで十分だ。
試すときの注意が2つある。いま出ている価格はローンチ割引なので、社内の試算は割引前の通常価格でやったほうがいい。もう1つ、Mercuryの日本語性能は公表されておらず、第三者検証も見当たらない。日本語で拡散型を試したいなら、ELYZAの公開モデルのほうが検証は早いはずだ。
「賢さ」の競争はこれからも続く。ただ、そこに「速さ・安さ」という別の軸が立ち上がってきた。しかも後者は、応答時間とコストという形で今日から測れる。測れる軸が増えたこと自体が、けっこう大きな変化だと思っている。
よくある質問(FAQ)
Q1. 拡散型LLMはなぜ速いのですか?
自己回帰型のように1トークンずつ順番に生成せず、全体を数回のステップで埋めていくため、生成に必要な計算回数を減らせるからです。
Q2. Mercury 2.5の速度や性能の数字はそのまま信頼できますか?
記事で紹介した速度や顧客事例はInceptionのブログ・プレスリリース内の報告が中心です。ベンチマークの指標名が公開されていない数字もあるため、第三者検証済みとは区別して読む必要があります。
Q3. 最初にどの業務で試すとよいですか?
要約、分類、タグ付け、ツール呼び出しの判定、構造化JSONの生成など、型が決まった裏方工程が候補です。まずは呼び出し回数の多い1工程だけを差し替え、速度・コスト・出力品質を測ります。
拡散型のように新しい設計のモデルは、これからも次々出てくる。YouTubeでは毎週日曜15時に、その週のAIニュースをまとめて動画で徹底解説しているので、流れを追いたい方はこちらをどうぞ。
https://www.youtube.com/@iketomoch
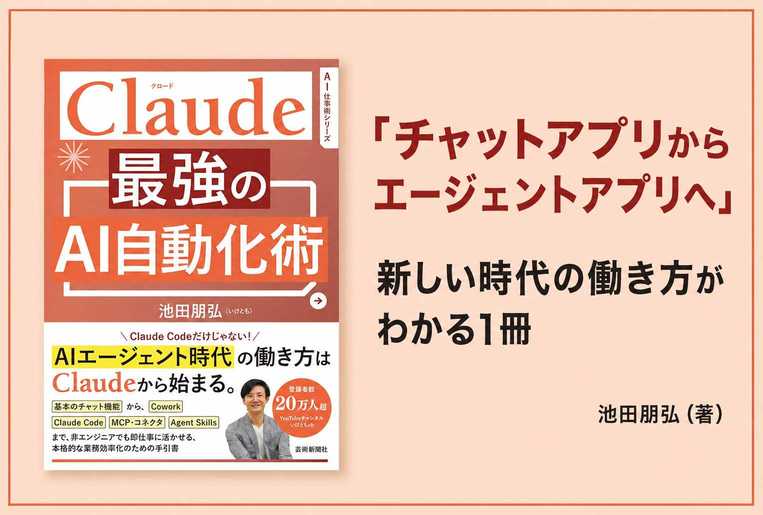
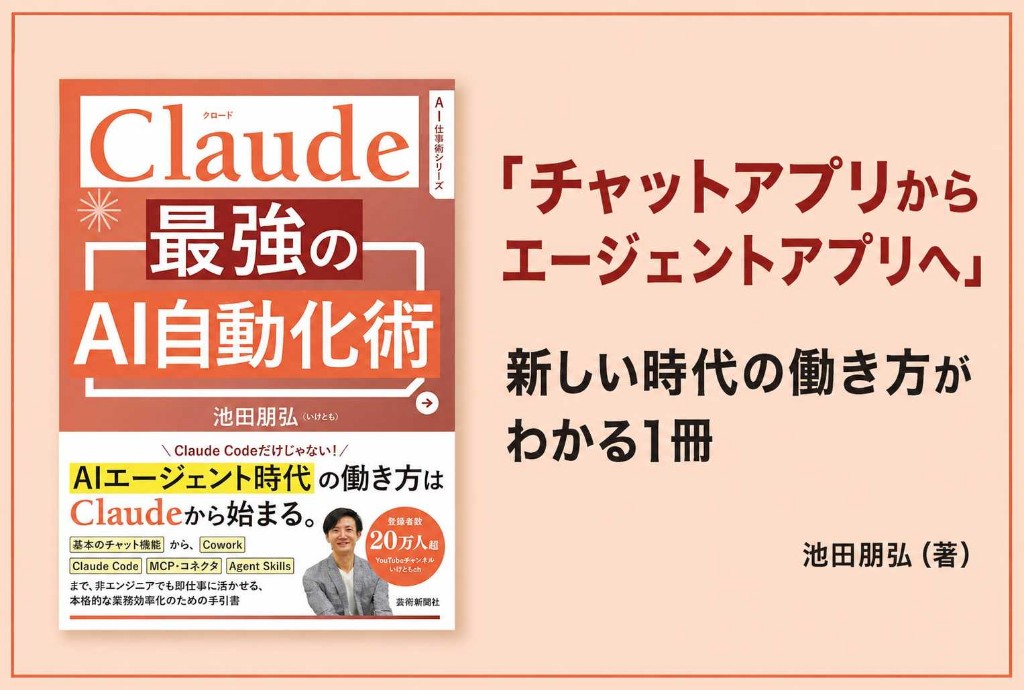
この記事の話を「自分の仕事のどの工程を差し替えるか」まで落とし込みたい方には、拙著『Claude 最強のAI自動化術』が役に立つはずだ。エージェントと自動化を、具体的な仕事の形にするところを扱っている。
https://amzn.to/4eTUVG1
読んで理解する段階から、2時間手を動かして自分の道具を1つ残す段階へ進みたい方は、いけともハンズオンへ。Claude Codeの自動化術やエージェントDB構築など、工程を仕組みに変える回を揃えている。
https://handson.workstyle-evolution.co.jp/
■合わせて読みたい
■関連記事


公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ