
検証できない仕事に、AIの量は効かない——OpenAIのナビエ–ストークス発表が示したこと
- 大量のAIエージェントが効くのは、成果物を機械が自動で速く安く検証できる仕事に限られます。
- OpenAIのナビエ–ストークス発表は、AIの物量より先に「答え合わせの仕組み」を設計すべきだと示しました。
- 営業ではリスト作成や見積、提案書の事故防止のように、工程ごとに検証器を作れる領域から始められます。
2026年9月8日、OpenAIが流体の難問である「ナビエ–ストークス方程式」について、有限時間で解が破綻する例を構成したと発表しました。投入したのは約1万体のAIエージェントです。起動から88時間。エージェント同士がやりとりしたメッセージは270万件、出力トークンは約1,300億に達しています。
数字は圧倒的ですが、ナビエ–ストークス方程式を解かなければならないビジネスパーソンは、まずいません。専門的すぎて自分には関係ない、と思われたかもしれません。ですが、この難問をAIエージェントにどう解かせたのかを知ると、自分の仕事へそのまま持ち帰れるヒントが出てきます。「AIがすごい」で終わらせると、いちばん使える部分を取り逃がすんです。
この記事では、なぜ1万体という物量が今回だけ機能したのか、そしてどんな仕事なら量を投じて勝てるのかという条件を整理します。最後に、その条件を営業の現場に当てはめて、検証の仕組みが作れる工程と作れない工程まで具体的に落とします。
目次
1万体をぶつけて、88時間で出した答え
今回いちばん面白いのは、結果よりもやり方です。
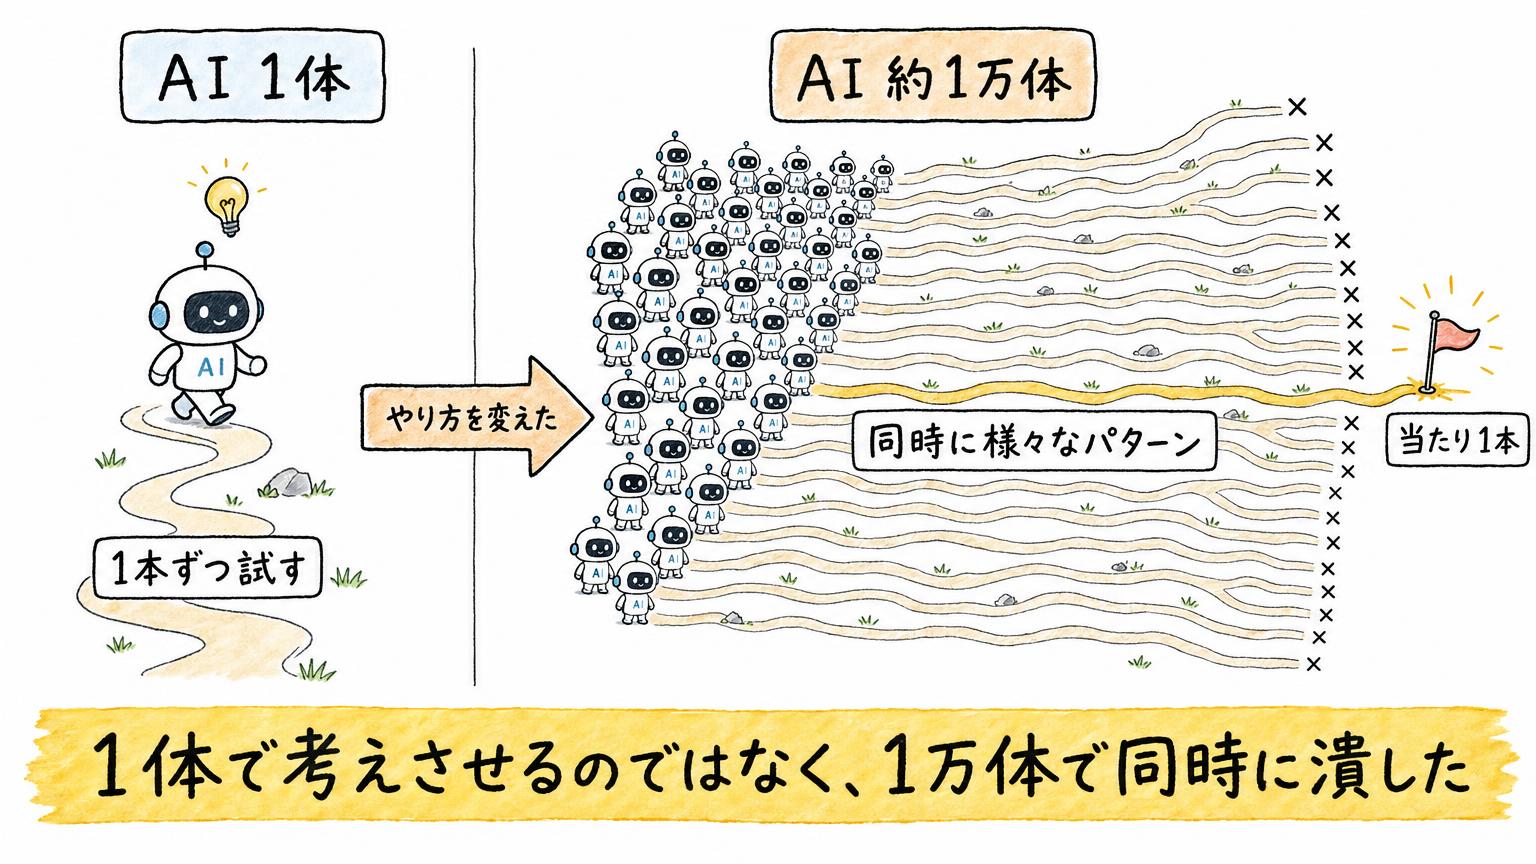
OpenAIが使ったのは、公開済みのGPT-6 Astraより「著しく高性能」とする未公開の社内モデルです。そして、そのモデルを1体で走らせたのではありません。約1万体を同時に立ち上げ、様々なパターンを徹底的に潰しにいった。ここが本質的な貢献です。
9月1日に着手し、9月5日に解へ到達。その後、GPT-6 Astraによる形式化と検証に追加で17時間かかっています。証明のPDFと、機械検証用のLeanコードはGitHubで公開されました。
※ Lean:数学の証明を機械が1行ずつ検算できる形で書くための言語のことです。
正確を期すと、この難問が完全に解けたわけではありません。
ナビエ–ストークス方程式はクレイ数学研究所のミレニアム懸賞問題の一つで、公式の問題文には4つの選択肢があります。今回の結果はそのうち「滑らかな外力あり」の(C)(D)に該当します。外力なしで解がずっとなめらかであり続けるかという(A)は、いまも未解決のままです。
OpenAI自身も「この結果でミレニアム賞を請求する意図はない」と明記しています。そして第三者による独立検証、査読、クレイ数学研究所による正式認定は、いずれもまだ完了していません。クレイ側は評価を「意図的に急がない」と説明しており、同研究所のサイトではナビエ–ストークスは未解決問題のまま掲載されています。
とはいえ、一部のパターンに限った結果だとしても、長年動かなかった問題で具体的な構成が出てきて、機械検証まで通ったこと自体は重い前進です。問うべきは「解けたかどうか」ではなく、その解き方が何に応用できるかです。
エージェントを増やしすぎると、むしろ効率が下がる
ここが面白いところです。「AIを増やせば賢くなる」という発想は、つい最近まで研究側から否定されるケースもありました。
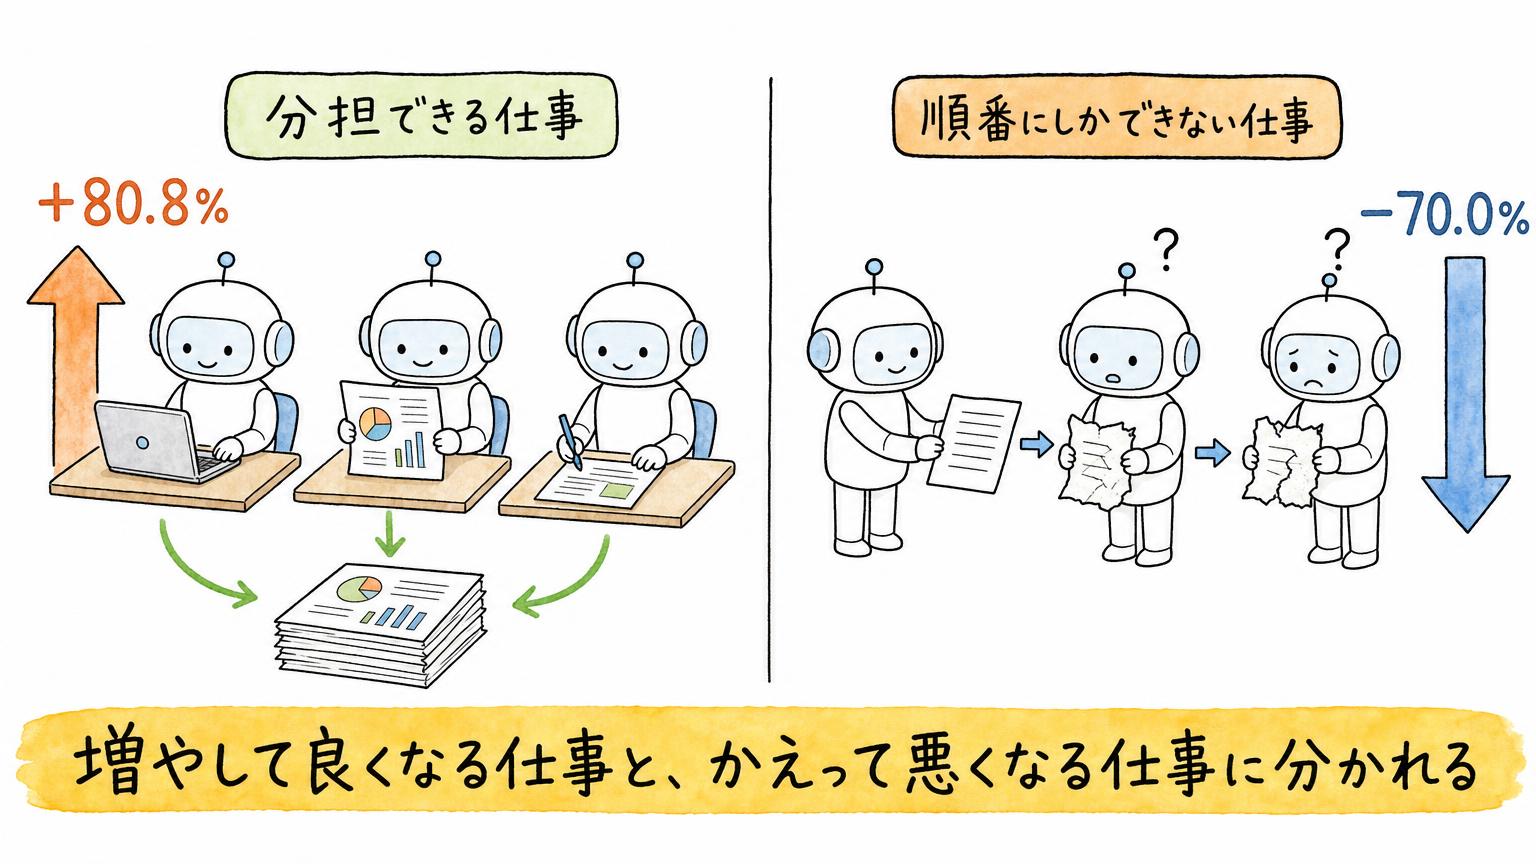
2025年12月に公開されたエージェントシステムのスケーリングに関する研究は、複数のAIに分業させることの効果を同一タスク群で実測しています。結果は極端に振れました。分解しやすい金融の推論タスクでは性能が+80.8%になった一方、順番に処理していくプランニングのタスクでは−70.0%。増やしたことで、半分以下に落ちたわけです。
さらにこの論文は、単体の性能が約45%という経験的な閾値を超えると、協調の効果が逓減するか負に転じると報告しています。エージェント1体あたりの性能が上がるほど、頭数を足しても意味がなくなっていく、という話です。
会議を思い浮かべると腑に落ちます。優秀な3人の議論に7人足しても、意思決定は速くなりません。文脈が分断され、伝言ゲームでズレが生まれ、誰も全体を把握できなくなる。
つまり「増やすと悪化する」は全否定ではなく、ケースバイケースです。効く仕事と、かえって悪くなる仕事に分かれる。では今回のOpenAIは、なぜ効く側だったのか。
量が効くかは「検証が自動で、速く安くできるか」で決まる
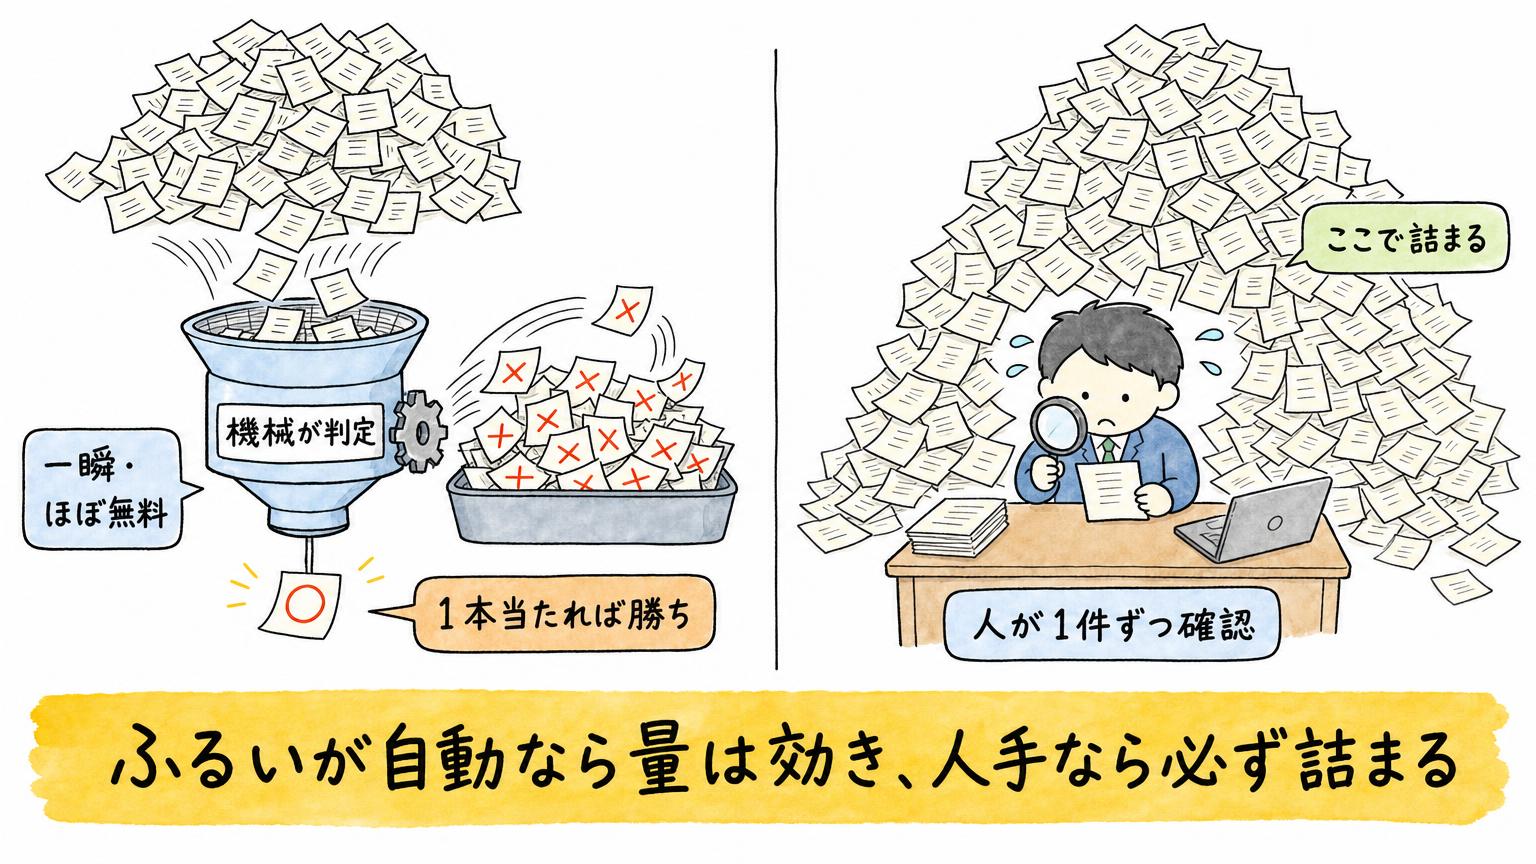
答えは、ナビエ–ストークスの証明が「答え合わせできる仕事」だったからです。
もう少し正確に言うと、量が効くかどうかは一つの問いで決まります。その仕事の結果を、機械が自動で、速く、安く検証できるか。 ここだけです。
一つ一つの当たり外れを人が手で確かめなければならない仕事では、この戦い方は使えません。候補を10万本出しても、検証に人手がかかるなら、そこで全部詰まります。
逆に数学の証明は、正しいかどうかを機械が一瞬で判定できます。だから10万本出して外れが9万9,999本でも、費用は出す側だけ。1本当たれば勝ちです。
この線引きは、今回のOpenAIだけのものではありません。Google DeepMindのAlphaEvolveは、適用できる問題の条件を論文で明確に定めています。「AlphaEvolveは機械採点可能な解を持つ問題を扱い、利用者は生成された解を自動評価する仕組みを提供しなければならない(AlphaEvolve tackles problems with machine-gradeable solutions, the user must provide a mechanism for automatically assessing generated solutions)」。
自動評価の仕組みを人間が用意できない問題には、そもそも適用できない。量を投じる側の企業自身が、そう宣言しているわけです。
自動・速い・安いのどれかが欠けると、量は途端に効かなくなります。工場のラインで検品だけが手作業なら、前工程をいくら速くしても全体は検品の速度で決まる。それと同じです。
数学とコードが先に成果を出した理由
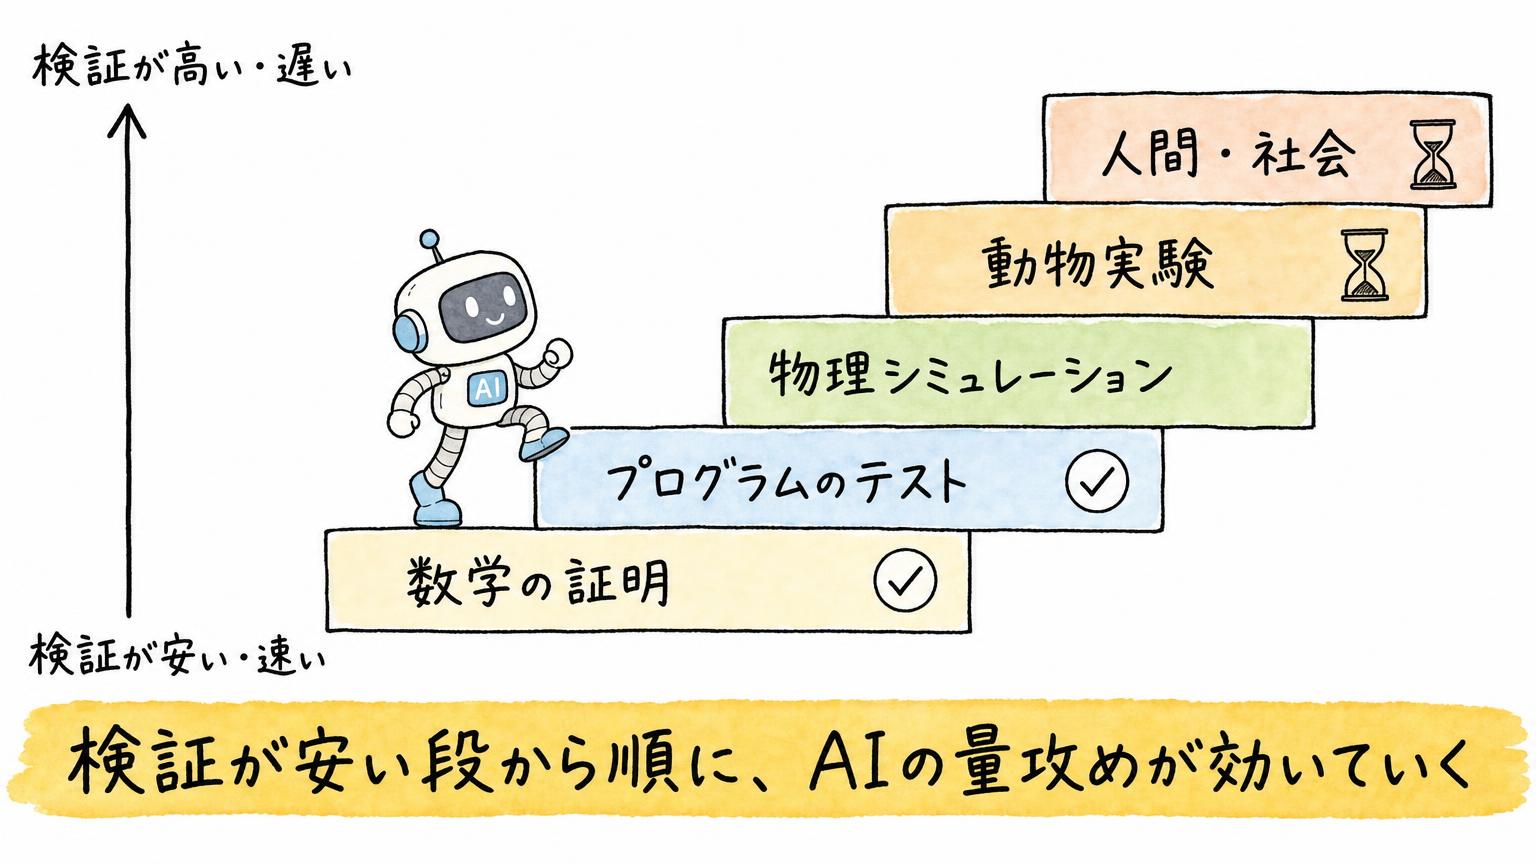
この基準で並べると、どの領域がいつ攻略されるかが、かなり見通せます。
検証コストの階段を下から積むと、こうなります。形式的な数学の証明が最下段で、秒・無料・自動。次にプログラムのテスト、次に物理シミュレーション、次にロボットによる自動実験、その上に動物実験、いちばん上に人体と社会実装。
AIの量攻めは、この階段を下から順に登っていきます。数学とコードが先に成果を出したのは、偶然ではありません。
逆側の例が分かりやすいので挙げます。Google DeepMindのGNoMEは、220万件の新しい結晶構造を予測し、そのうち38万件を安定と判定しました。では実験室で実物になっていたのは何件か。Nature論文によれば736件です。しかもこれは予測を受けて追試したものではなく、同時期の別チームの研究ですでに作られていたものを、事後に突き合わせた数字です。
予測は220万、実物は3桁。生成と検証の間には、これだけの落差があります。
創薬はさらに極端です。分子を10億個設計するのは、いまや計算だけで済みます。でも本当に効くかどうかは、細胞に入れ、動物に入れ、最後は人間に入れないと分からない。1本あたり年単位、数百億円。ふるいがタダどころか、ふるいが本体になっている領域です。
だから創薬や材料科学の本命は、モデルの賢さではなく、検証を自動化する側にあります。ロボットが合成と測定を自動で回す自律実験ラボが実用域に入れば、これらの領域もこの基準に近づきます。そのとき初めて、数学やコードと同じ側に移る。ここは見通しであって、確定した話ではありません。
営業で検証器が作れる工程、作れない工程
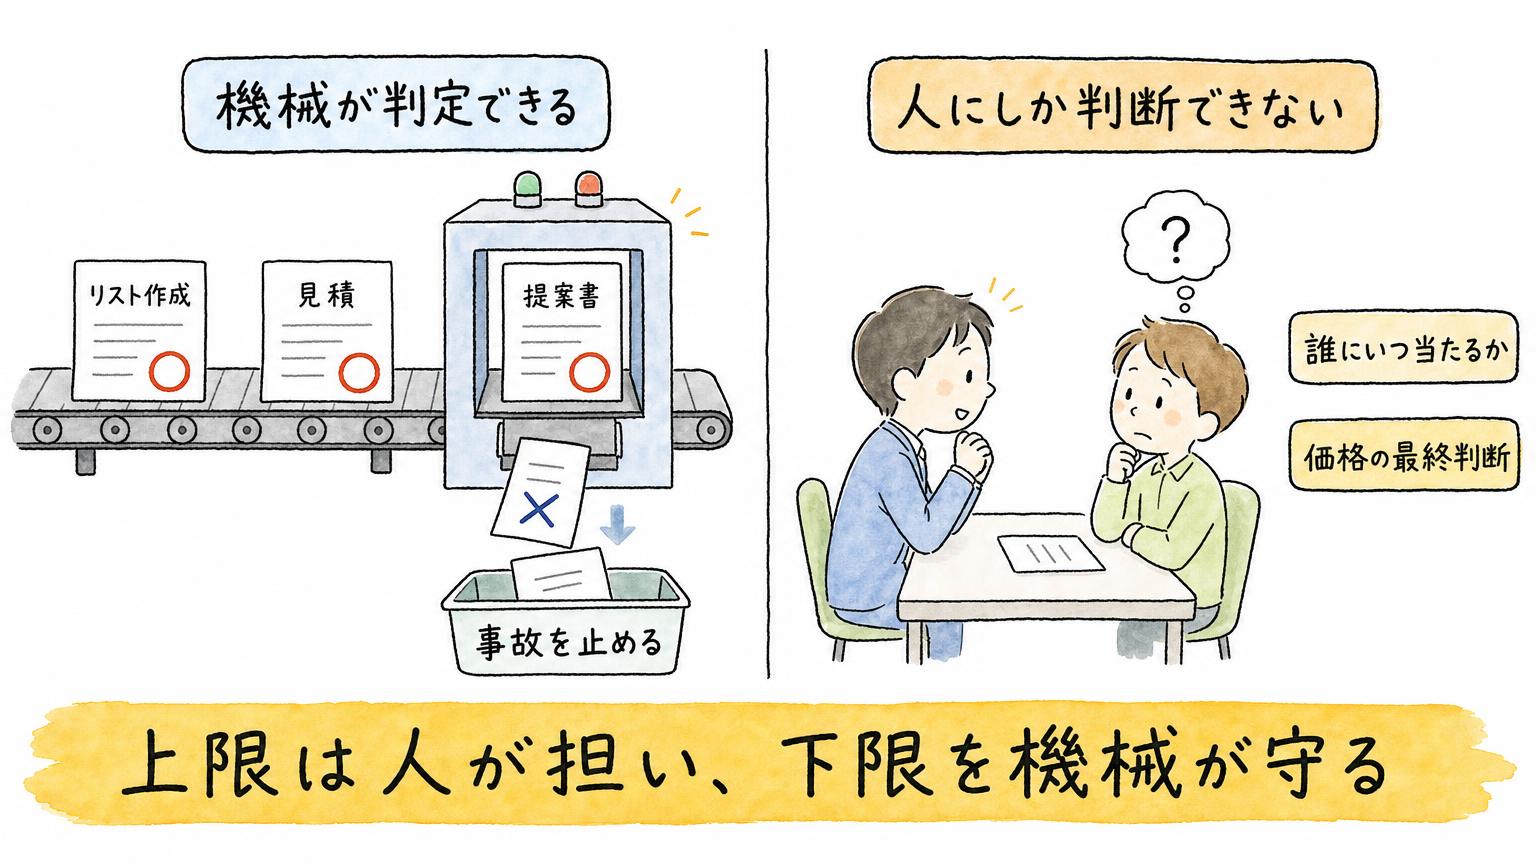
では自社ではどうか。ここからが本題です。
やることは一つです。自社の業務を、答え合わせが自動化できるものとできないものに仕分ける。 営業を例に、具体的にやってみます。
営業をひと塊で考えると、絶対に仕分けできません。工程に割ります。リスト作成、事前リサーチ、アポ取り、初回ヒアリング、提案書作成、見積、交渉、契約書類、CRM入力、フォロー。
いちばん作りやすいのはリスト作成です。既存顧客マスタと重複していない、対象外業種を含まない、従業員規模が範囲内、休廃業データに該当しない、過去に「再アプローチ不可」と記録されていない。全部マスタとの突合なので、人の判断はゼロ。1万件でも一瞬で判定できます。
次が見積です。標準価格表との差異が割引権限の範囲内か。値引き後の粗利率が下限を割っていないか。オプションの組み合わせに矛盾がないか。営業現場でいちばん事故が起きる場所であり、同時にいちばん判定が簡単な場所でもあります。
提案書は、考え方の切り替えが要ります。提案の「良さ」は判定できません。でも提案書の「事故」は完全に判定できます。他社名が残っていないか。提案金額が見積と一致しているか。記載した実績データの出典が社内の承認済みリストにあるか。効果保証にあたる断定表現が入っていないか。
多くの営業組織では、提案書に前の案件の社名が残ったまま送られる事故が、いまも起きています。それを1件防げるだけで、この仕組みは元が取れます。
ここが今回いちばん持ち帰ってほしい発想です。検証の仕組みは、品質の上限を上げる道具ではなく、下限を守る道具です。 上限は人が担い、下限を機械が守る。
一方で、絶対に人に残る工程もあります。誰にいつ当たるかの判断。価格の最終判断。相手が言っていないことを察すること。ここを無理に条件化すると、営業が指標を満たすだけの機械になります。
そして最大の落とし穴が、受注率を判定基準にしてしまうことです。結果が出るまで数か月かかるので遅い。失注理由の大半は相手の事情なのでノイズが多い。月30件では統計にならない。そして何より、取りやすい小口ばかり狙い、値引きを乱発し、見込みの薄い案件を早々に落として分母を減らす、という動きを誘発します。指標上は全部「改善」に見えてしまう。
判定すべきは結果ではなく、「その工程の成果物が、次の工程に渡せる状態か」です。工場の工程間検査と同じ発想で、最終製品の売れ行きではなく、次の工程に不良を流さないことを見る。これなら即座に、大量に判定できます。
あわせて読みたい:合格条件だけを渡して訓練する手法と、その裏返しである報酬ハッキングについては「偽のGmailを5000万個作った話 — Kimi K3が示した、AIの育て方の転換点」で扱っています。
明日から動かすなら、会議を1本だけ設定してください。参加者は、その業務を実際にやっている人と、判定基準を決める権限のある人。主要業務5つについて「答え合わせを人の好みに依らず1日以内に自動でできるか」を仕分けし、該当した1つについてだけ、OKの条件を具体的に書き出す。所要90分です。
書けたかどうかの判定基準も、一つだけあります。文中から「正しい」「適切」「わかりやすい」という言葉が消えていること。この3語が残っているうちは、まだ条件になっていません。
最後に、今回の学びを一つの問いに戻します。
自社の仕事に大量のAIを投じる物量作戦が効くかどうかは、その結果を機械が自動で、安く、速く検証できるかどうかだけで決まります。この条件を満たす業務が見つかったなら、あとは様々なパターンを同時に試せます。人手の都合で1案しか検討できなかったところに100案を並べ、機械にふるいをかけさせる。改善の幅も、こなせる量も、これまでの延長線ではない大きさになるかもしれません。
1万体のエージェントがやったことは、突き詰めればそれだけです。
よくある質問(FAQ)
Q1. AIエージェントを増やせば、どんな仕事でも成果が上がりますか?
いいえ。この記事が示す条件は、成果物を機械が自動で、速く、安く検証できることです。人が一つずつ正しさを判断する仕事では、候補を増やすほど検証がボトルネックになります。
Q2. 営業で最初に検証器を作りやすい工程はどこですか?
既存顧客との重複、対象外業種、従業員規模、再アプローチ不可の条件を照合するリスト作成や、価格表・粗利率・オプションの矛盾を確認する見積が始めやすい工程です。提案書も、良さそのものではなく他社名の残りや金額不一致などの事故は検証できます。
Q3. 自社の業務で何から着手すればよいですか?
主要業務を工程に分け、「人の好みに依らず、1日以内に自動で答え合わせできるか」を仕分けます。該当した一工程だけについて、OKの条件を具体的に書き出すところから始めます。
1万体のエージェントが数学の難問に挑んだ話をもっと立体的に追いたい方へ。YouTubeでは、こうした最新のAIニュースを毎週まとめて動画で解説しています:https://www.youtube.com/@iketomoch
「答え合わせできる仕事をAIに任せる」という今回の考え方を、実際の業務フローとして組み上げる方法は、拙著『Claude 最強のAI自動化術』で手順まで落としています:https://amzn.to/4eTUVG1
読んで理解する段階から、自分の業務で検証の仕組みを1つ動かす段階へ進みたい方へ。いけともハンズオンなら、2時間手を動かして自分専用のツールを1つ残して帰れます:https://handson.workstyle-evolution.co.jp/
■合わせて読みたい
■関連記事

公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ