判断特化AI「Jev」とは?TypeSafe AI開発、193倍速く444倍安いと主張
- 米TypeSafe AIが、判断だけを返す専用AI「Jev」を2026年9月15日に発表した
- 回答形式をあらかじめ固定し、幻覚や形式エラーが仕組み上起きない設計にした
- 「193倍速く444倍安い」は自社評価の数字で、第三者による検証はまだ無い
経費申請の金額は規定内か。問い合わせをどの部署に振るか。在庫を発注していいか。
こうした「文章にするまでもない小さな判断」が、あなたの一日にもいくつか紛れていませんか。ひとつひとつは数秒で終わるのに、積み重なると誰かの時間を静かに奪っていきます。
この「小さな判断」だけを高速・低コストでこなす専用AIが、2026年9月15日に発表されました。名前は「Jev」。文章は一切書けません。でも、いま主流のAIとは決定的に違う設計思想を持っています。
目次
Jevとは何か──判断だけを返す「System One Model」
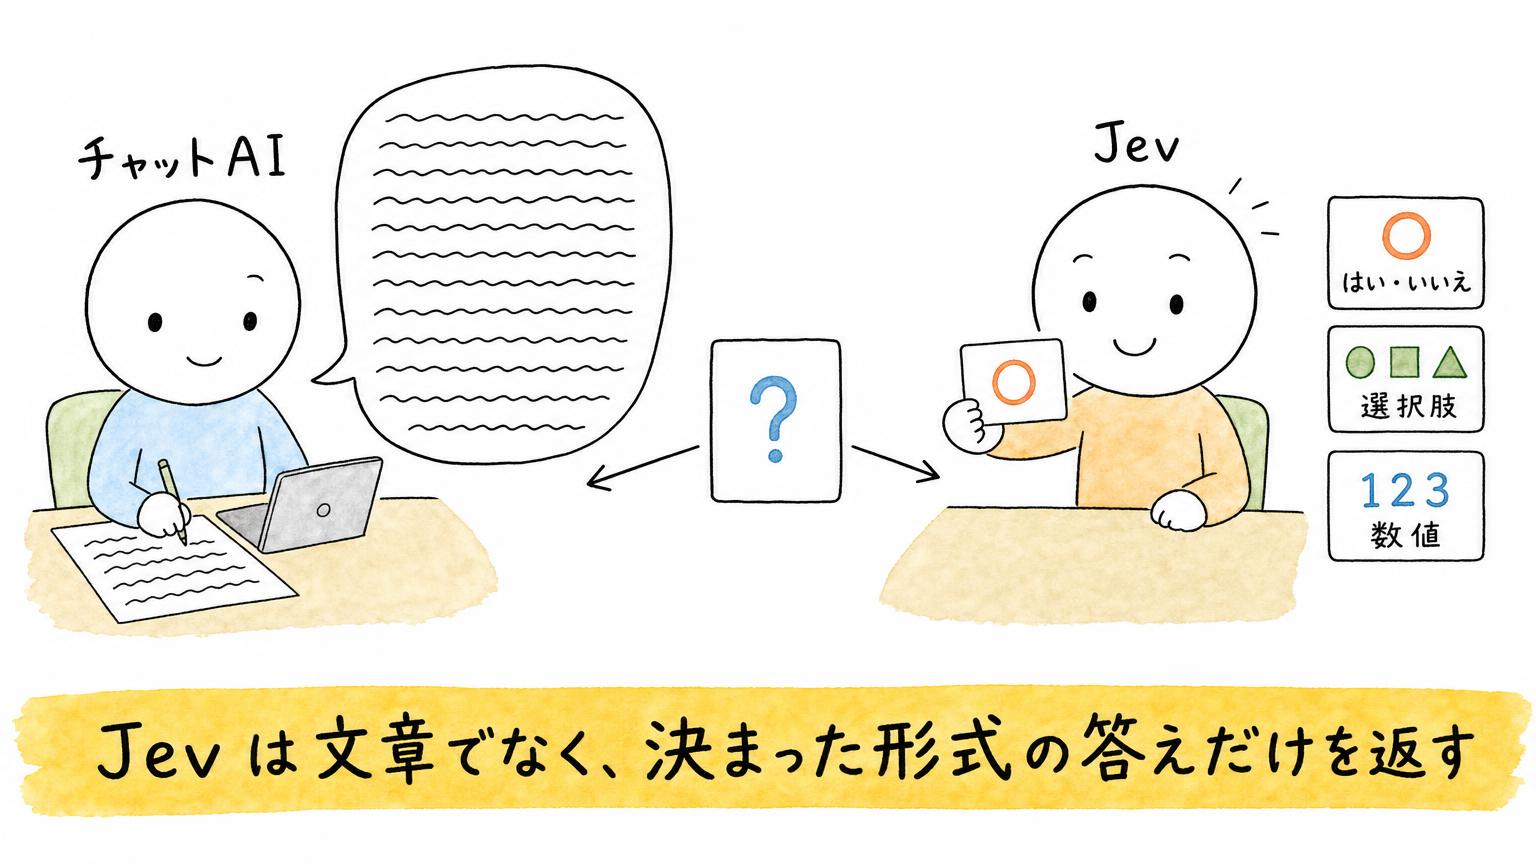
開発したのは、米サンフランシスコのTypeSafe AI。状況を説明するテキストを送ると、Jevは「はい/いいえ」「選択肢のどれか」「数値」といった、あらかじめ決まった形式でしか答えを返しません。文章もコードも一切生成しない代わりに、回答のたびに「どれくらい自信があるか」を確信度という数値でも提示します。
TypeSafe AIはこれを「System One Model」と呼びます。人と会話するAIではなく、ソフトウェアの内部で判断だけを下す自動化専用のAI、という位置づけです。つまりJevは、ChatGPTのようなチャットの代わりにはなりません。
料金は入力100万トークンあたり約6.5円、出力は無料。応答時間は1回70〜500ミリ秒で、TypeSafe AIは主要LLMの3〜329秒と比べて40〜200倍速いと説明しています。
開発を率いるのは、CEOのDiogo Almeida氏。ChatGPTの前身にあたるInstructGPT論文(2022年、約20人いる共著者の1人)に名を連ねた人物です。ただし土台になった学習手法自体は、同氏が参加していない先行研究が考案したもので、「モデルは何年も前からチャットで超人的なのに、自動化はどこにあるのか」と問い続けてきたといいます。
なぜ型エラーも幻覚も起きない設計になっているのか
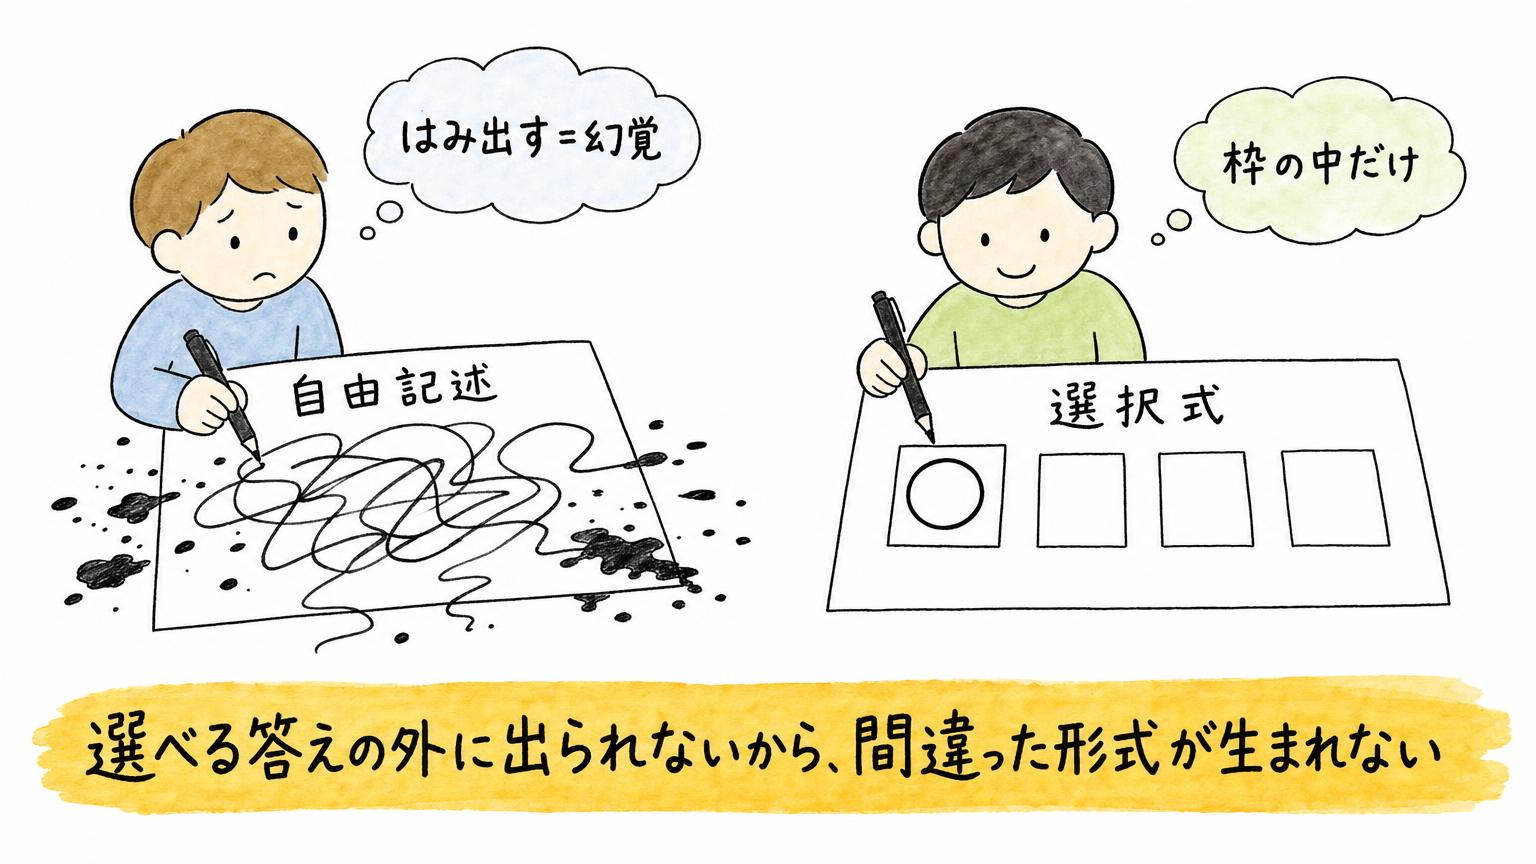
LLMは文章を1語ずつ順番に生成します。前の単語が決まってから次を予測する、という繰り返しです。だから文章が長くなるほど時間がかかりますし、実在しない答えをもっともらしく書いてしまう「幻覚」も起こり得ます。
Jevはここが違います。あらかじめ定義した形式の値しか出力できないため、すべての回答を1回の問い合わせで並列に出せます。選べる答えの外に出ようがないので、形式の誤りも幻覚も仕組みの上で起きない、というのがTypeSafe AIの説明です。
ただし、これは「形式が正しい」という意味であって、判断の中身が常に正しいわけではありません。だからこそ確信度が付いています。学習には「RLCD」という独自の強化学習手法を使い、確信度が高い回答ほど実際の正答率も高くなるよう鍛えているといいます。
実演で見えた差──ゲームで示された速度とコスト
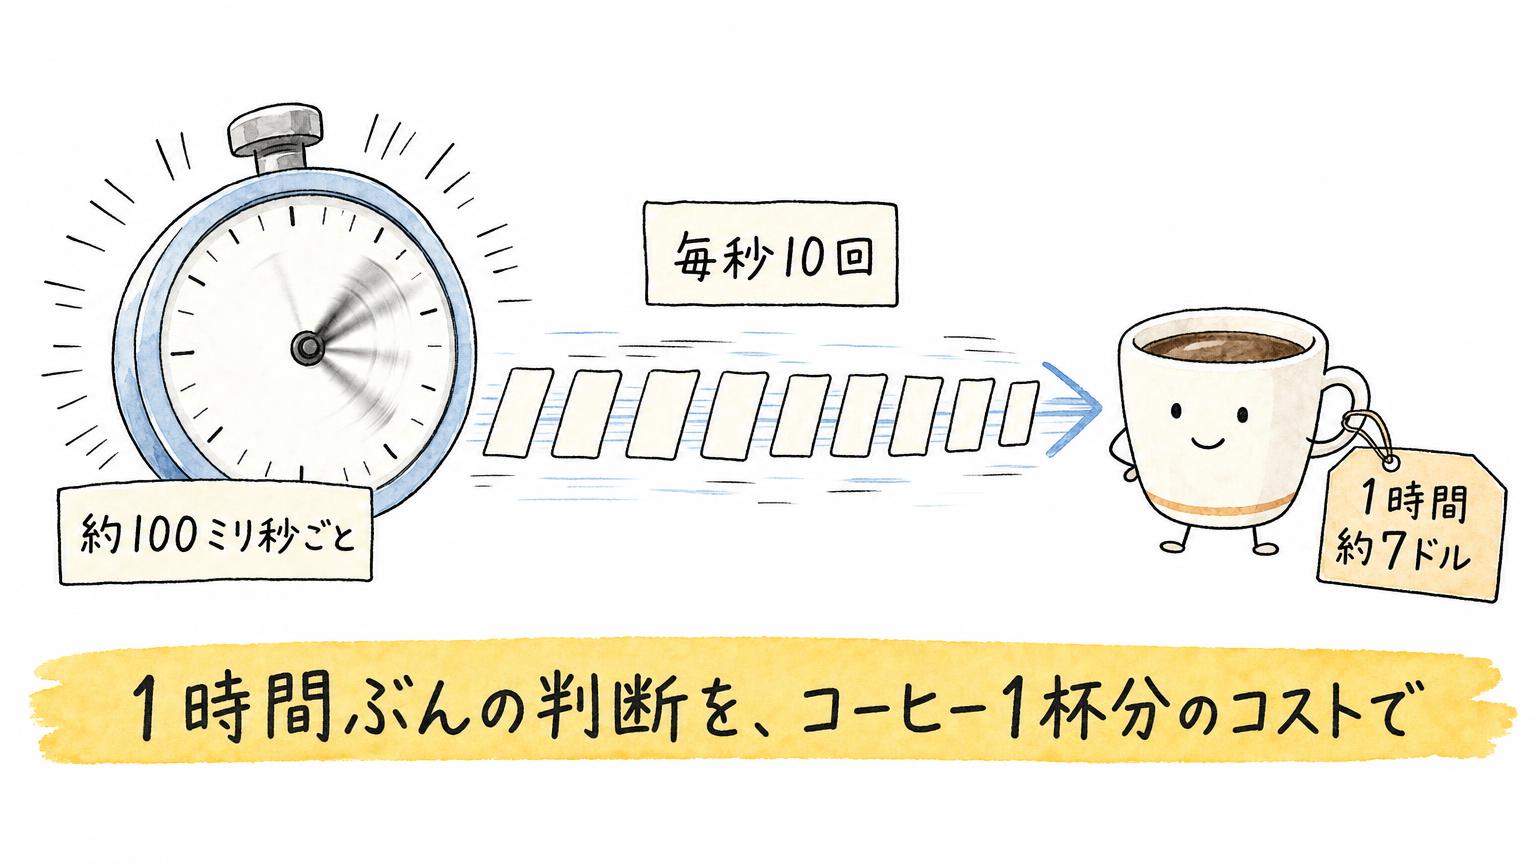
発表ブログでは、2つの実演が紹介されています。
ひとつは、ゲーム「DOOM」の自動プレイ。ゲーム内の状況を説明するテキストから、約100ミリ秒ごとに射撃・移動・回避を判断させ続け、毎秒およそ10回の問い合わせを送っても、運用費は1時間あたり約7ドルで収まったとのことです。
もうひとつは、Wikipediaのリンクだけをたどって目的の記事に到達する競走ゲーム。Jevは高速で完走した一方、対戦した大規模言語モデルは、ページに存在しないリンクを回答する幻覚を起こしてやり直しています。
193.6倍高速・444.6倍低コストという数字も、この2つの実演を含むTypeSafe AI自社設計のワークフロー評価から出たものです。ただしTypeSafe AI自身が「評価の作り手による偏りの可能性がある」と注記しており、第三者による独立検証はまだありません。数字よりも「判断だけに絞れば、ここまで速く安くできる」という設計思想の実証として読むのが適切でしょう。
▶︎ あわせて読みたい:AIの量が効くかどうかは、結果を機械が検証できるかで決まる
現場にどう組み込むか──境界線を引くのは開発者
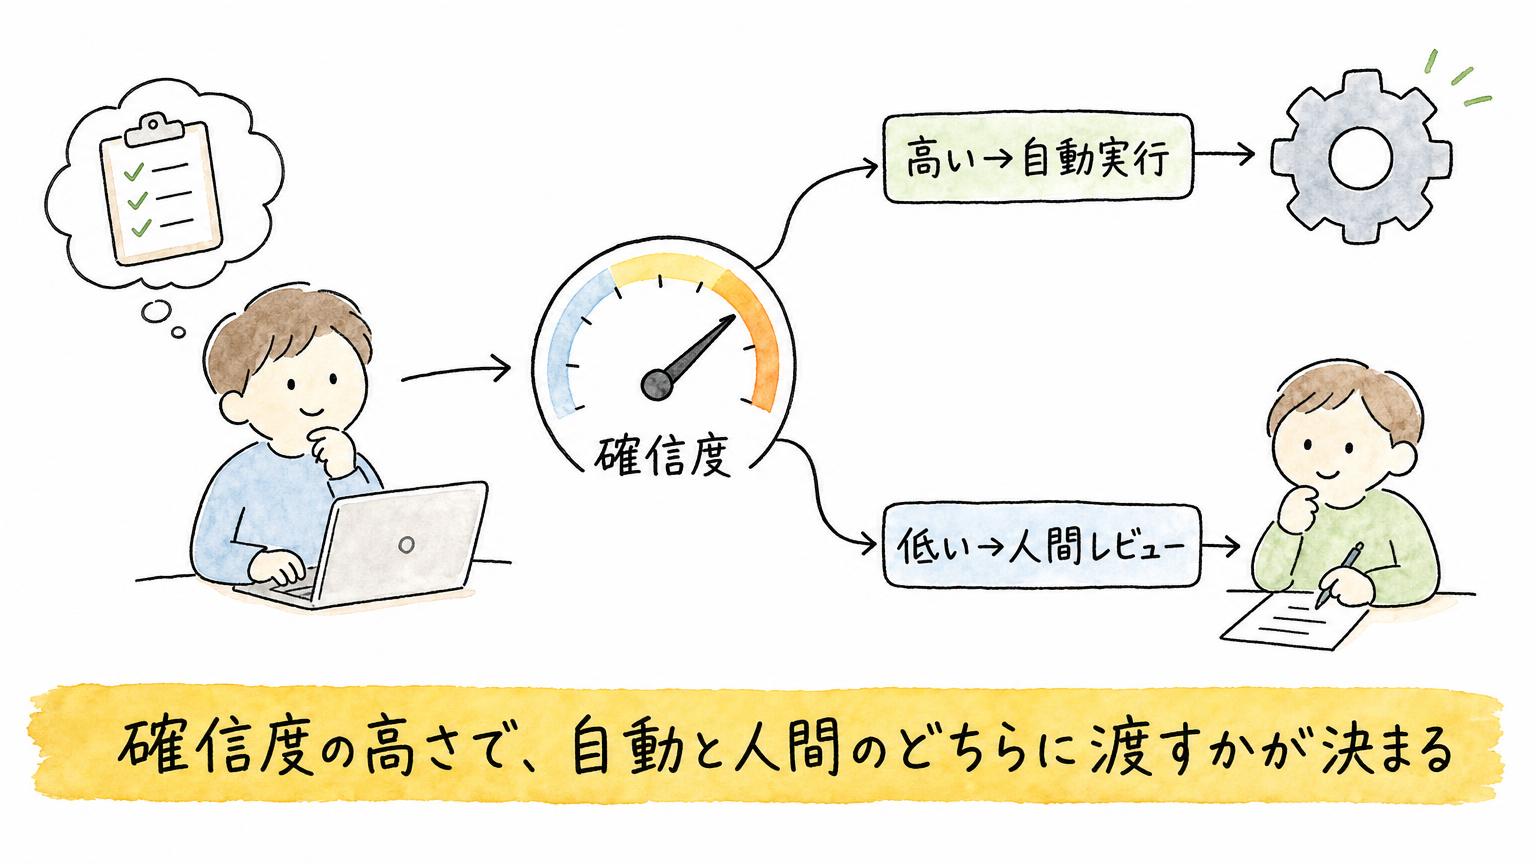
Jevは単体の対話AIではなく、複数の小さな判断をつないで一つの業務の流れ(ワークフロー)を作る部品として使われることを想定しています。
たとえば、ある中小企業の経理担当者が抱える経費精算業務なら、「金額が規定内か」「領収書の形式は正しいか」「過去に似た申請がなかったか」といった判断を、それぞれJevに渡すイメージです。開発者は確信度に閾値をコードで設定し、確信度が高ければ自動実行、低ければ人間のレビューに回す、というルールを組めます。
つまり自動実行と人間レビューの境界線は、AIが勝手に決めるのではなく、業務側が数値でどこまで任せるかを設計する仕組みになっています。
▶︎ あわせて読みたい:「見極める判断」はルール化、「決める判断」は人に残る――LayerXが独立に辿り着いた境界線
上級編:自動化が進むほど、レビューに残るのは「難しい判断」だけになる
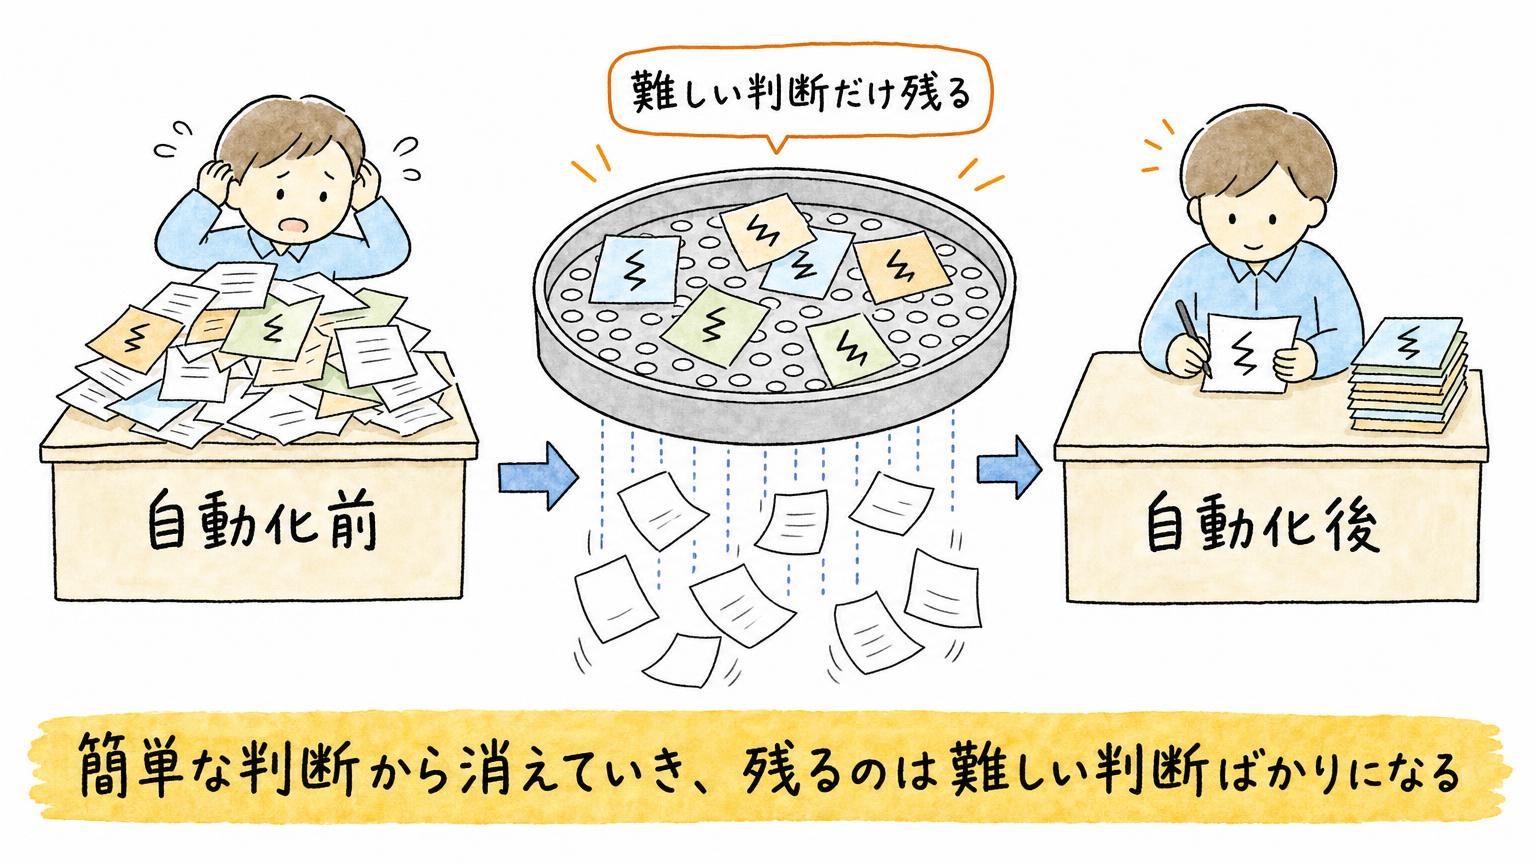
この仕組みには、見落としやすい副作用があります。
確信度の高い判断から自動化されていくと、人間のレビューに残るのは「確信度が低い、つまりJev自身が迷った判断」ばかりになっていきます。従来は簡単な案件と難しい案件が混ざって人の手元に届いていたのに、自動化が進むほど、レビュー担当者の元には平均より難しい案件だけが集まるようになるのです。
閾値の設定にもトレードオフがあります。閾値を高くすればするほど自動実行の誤りは減りますが、レビューに回る件数が増えて負荷が膨らみます。逆に閾値を低くすればレビュー負荷は減っても、確信度の較正が甘ければ「自信はあるが実は間違っている」判断まで自動実行されるリスクが上がります。
件数が減っても、レビューという仕事そのものが楽になるとは限らない。ここがJevのような仕組みを現場に入れるときの、地味だが重要な論点です。
結論──人間の役割は「判断を下す」から「境界を管理する」へ
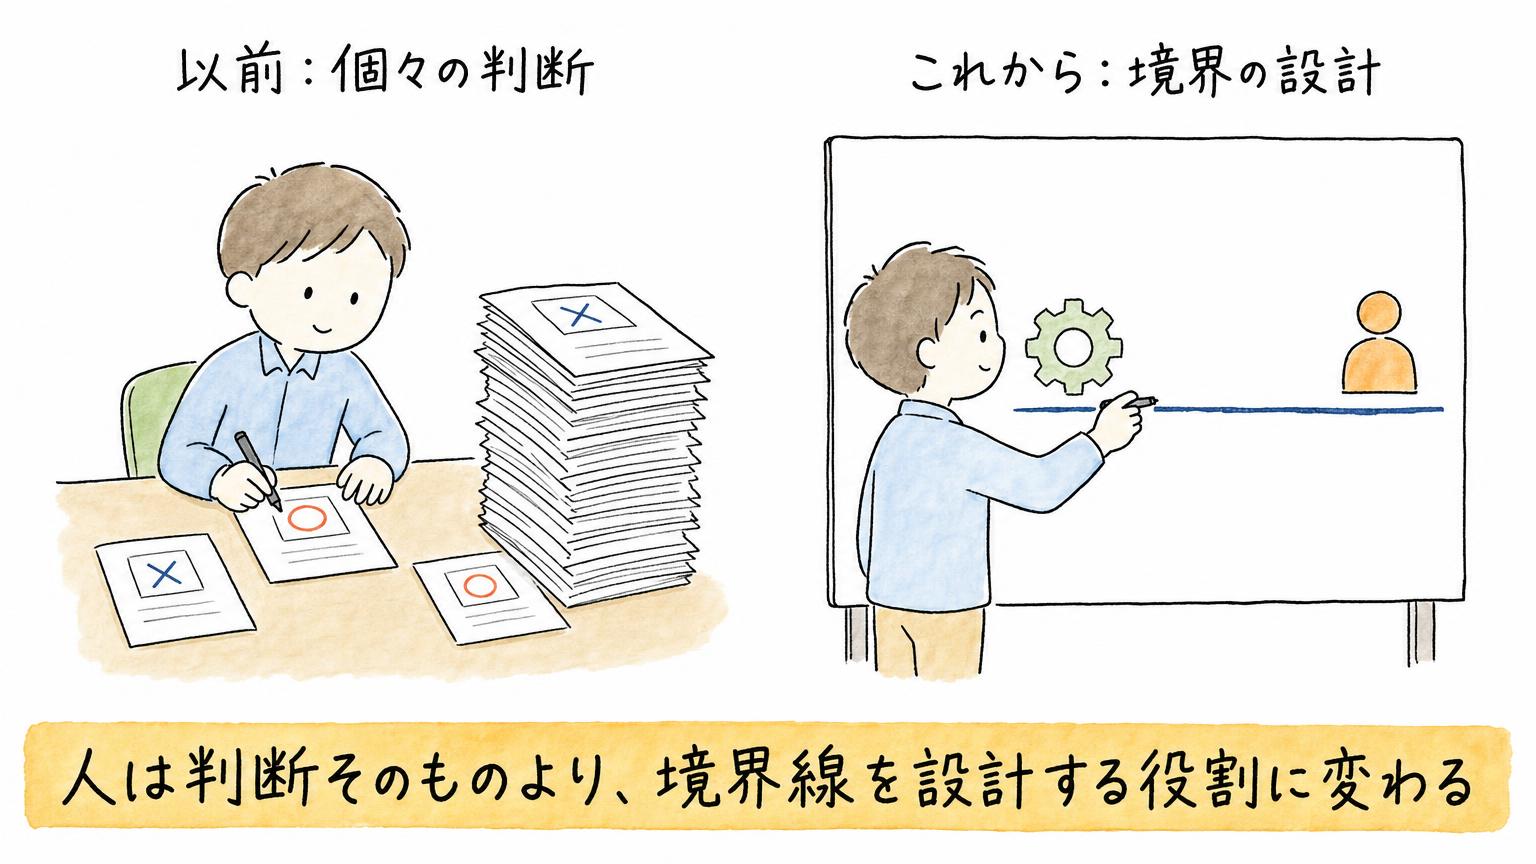
Jevが示しているのは、AIが人間の仕事を丸ごと奪う話ではありません。自動化は判断の総量を減らすのではなく、人間が扱う判断の種類を変える、という話です。
これまでは、簡単な判断も難しい判断も同じように人が処理していました。閾値による切り分けが進むと、人間に残るのは「基準そのものを設計すること」と「境界をまたいだ例外を扱うこと」になっていきます。個々の判断を下す役割から、判断の仕組みを設計し、境界を管理する役割への移行です。
これはJev固有の話にとどまりません。手元の業務で「これはルール化できる判断か、それとも最後まで人が決めるべき判断か」を一度棚卸ししてみると、思っていたより多くの判断が前者に分類できることに気づくはずです。まずは自分の業務の中から、確信度で線引きできそうな判断をひとつ見つけることから始めてみてはいかがでしょうか。
▶︎ あわせて読みたい:判断を渡しても、意思まで渡していいのか
YouTube『いけともch』:https://www.youtube.com/@iketomoch
よくある質問(FAQ)
Q1. 判断特化AI「Jev」とは何か。ChatGPTのようなAIと何が違うのか
米TypeSafe AIが2026年9月15日に発表した「System One Model」と呼ばれる自動化専用のAIです。文章やコードは一切生成せず、「はい/いいえ」「選択肢のどれか」「数値」などあらかじめ決まった形式でしか回答しません。人と会話するチャットAIの代わりではなく、ソフトウェアの内部で小さな判断だけを下す部品として使われます。
Q2. 「193倍速く444倍安い」という数字はそのまま信じてよいのか
この数字は、DOOMの自動プレイやWikipediaリンクをたどる競走ゲームなど、TypeSafe AI自社設計のワークフロー評価から算出されたものです。TypeSafe AI自身が「評価の作り手による偏りの可能性がある」と注記しており、第三者による独立検証はまだありません。数字そのものより、判断だけに絞ることで速度とコストを大きく圧縮できるという設計思想の実証として捉えるのが適切です。
Q3. 現場で導入する場合、人間側は何を設計する必要があるのか
開発者が確信度に閾値をコードで設定し、確信度が高ければ自動実行、低ければ人間のレビューに回す、という境界線を業務側で決める必要があります。閾値を上げれば自動実行の誤りは減る一方でレビュー件数が増え、閾値を下げればレビュー負荷は減る一方で誤った自動実行のリスクが上がるというトレードオフがあります。
新著『Claude 最強のAI自動化術』:https://amzn.to/4eTUVG1
YouTube『いけともch』:https://www.youtube.com/@iketomoch
Podcast『いけとも尾原DeepなAIニュース』:https://open.spotify.com/show/3hGAbKZI5oo9PsbFI1IxTr
■合わせて読みたい
■関連記事

公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ