Anthropicの研究開発の26%をClaudeが主導――「主導」と「協働」の違い
Anthropicの研究開発の26%をClaudeが主導――「主導」と「協働」の違い
- Anthropicは、自社のAI研究開発の26%をClaudeが「主導」していると公表しました。
- 26%は使った回数ではなく、人の時間で重みづけした「任せた深さ」を測った数字です。
- ただし測定も判定もClaudeが担い、第三者による検証結果は示されていません。
目次
26%は「AIを使った回数」ではない
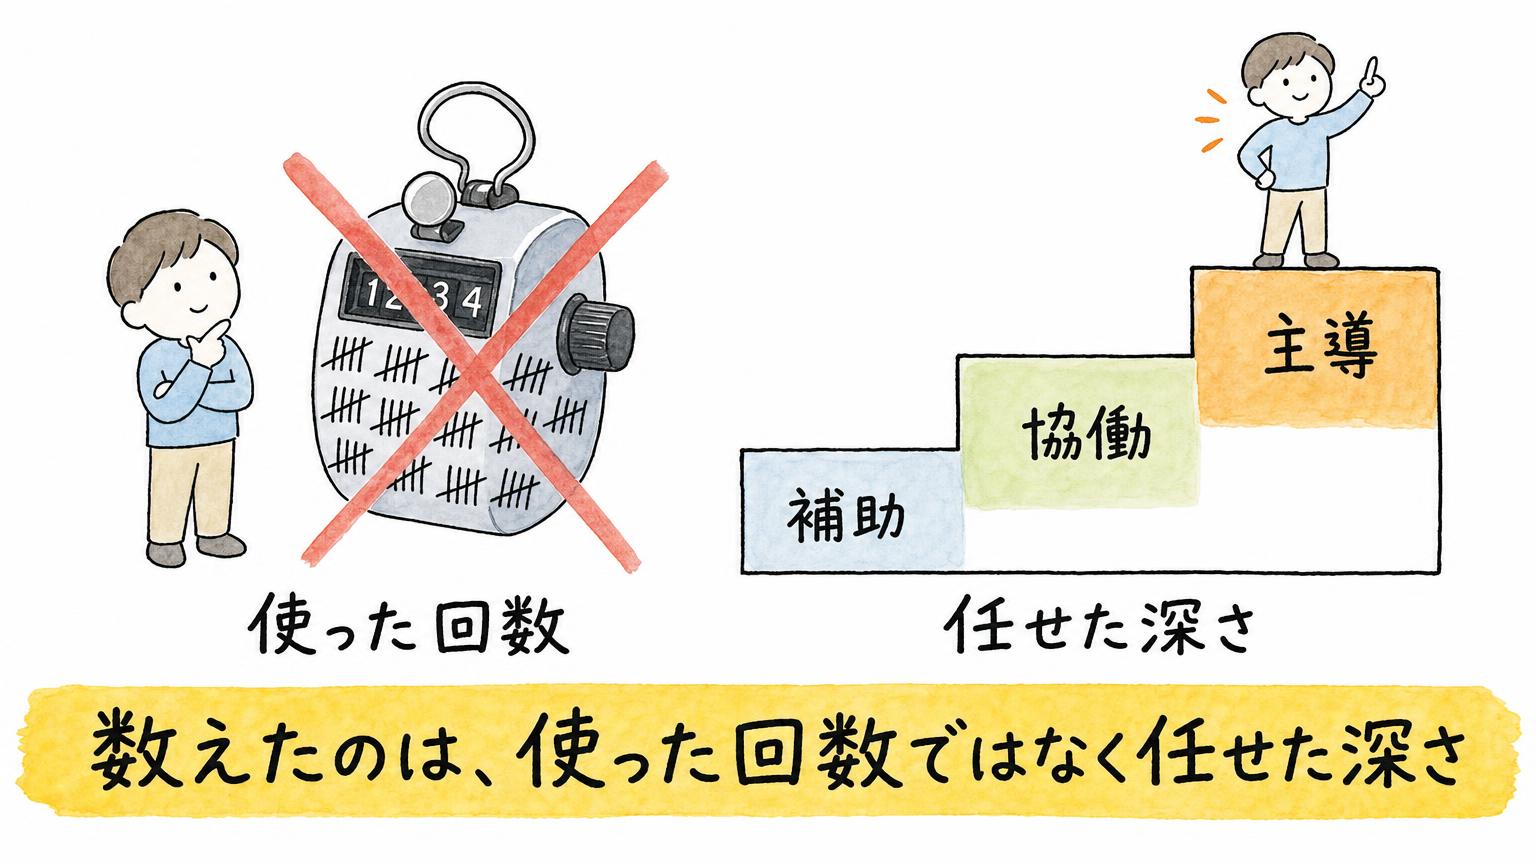
この数字の出どころは、Anthropicが公開したレポートです。社内で「Anthropic R&D Automation Index」と呼ぶ試作の指標で、8月時点の評価が26%でした。
測り方はこうです。まず7月の各週に、モデル開発に関わる各部門から社員の20%を無作為に選びます。次にClaudeが、Slackや社内資料をもとに、その人の1週間の仕事を書き出します。
集まった約1万5,000件のタスクを、542の分類(末端は378)に整理して固定しました。そのうえで、各分類についてAIがどの段階まで担っているかを6段階で評価します。
集計では、仕事の重要度の代わりに、その仕事に割かれた人の時間を使っています。粗い近似だと報告書自身が認めていますが、平均的には妥当に働く、とも書いています。
つまり26%は、使った回数ではなく、任せた深さを測った数字です。研究開発の仕事全体を、その仕事に割かれた人の時間で重みづけしたとき、26%分でAIが「主導」の段階にある、という意味になります。
「主導」と「協働」を分けるのは、人間の立ち位置
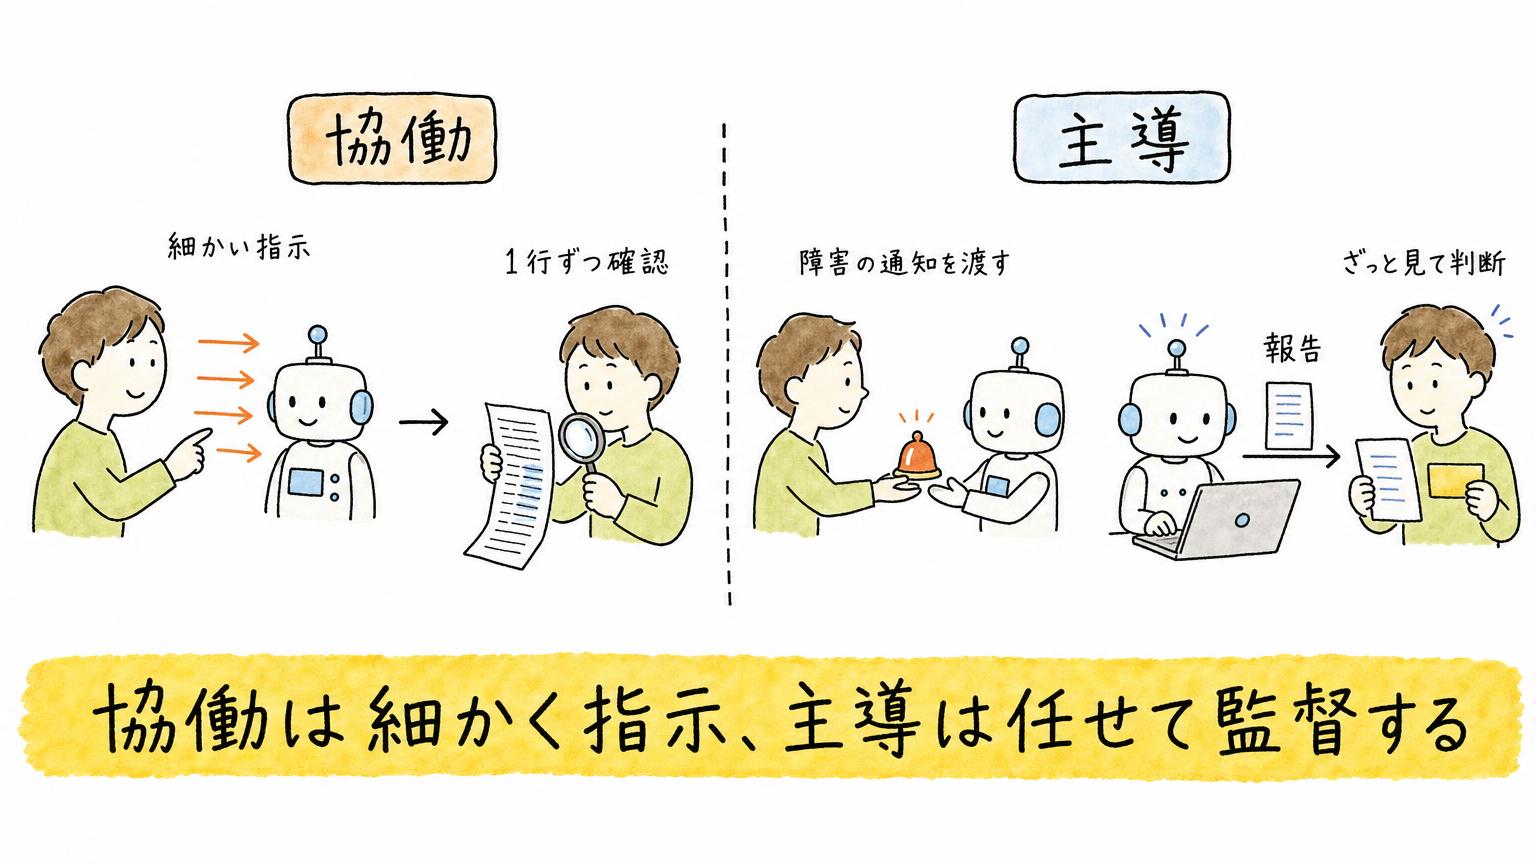
6段階は、Epoch AIが作った物差しです。AIの関与が深くなる順に、次のとおりです。
- AL0:AIの関与なし
- AL1:AIの関与はごくわずか
- AL2:AIが補助する
- AL3:AIが協働する。人間の綿密な指示のもとで、大きなかたまりの作業をこなす
- AL4:AIが主導する。高いレベルの指示から、作業の大半を最後までやり遂げ、人間は監督に回る
- AL5:AIが完全に自律する。人間が関わらなくても動く
AL1とAL2は、報告書では名称だけが示されています。この記事で大事なのは、AL3の「協働」とAL4の「主導」の境目です。
報告書は違いを、夜間のデータ処理が壊れた場面で説明しています。
協働では、エンジニアがログを持ってClaudeに相談します。途中で新しい問題が出たらClaudeは止まり、エンジニアが対処を決めます。テストが通ったら、エンジニアが変更を1行ずつ確認し、自分で再実行してから本番に出す、といった流れです。
主導では、エンジニアは障害の通知を渡すだけです。Claudeがログを読んで原因を突き止め、修正を書いてテストし、想定外の問題も自分で処理して記録します。データのコピーで再実行して前回の正常な結果と比べ、何が起き、何を変えたかをまとめて、エンジニアに知らせます。
ただし、本番に出すのはClaudeではありません。エンジニアは報告を読み、変更をざっと確認して、今夜出すか待つかを決めます。この例では、本番に出す判断は人間が握っています。
「協働は約9割」という要約を見かけますが、報告書の表現は「協働以上が9割超」です。26%の主導は、その内側に含まれます。
この主導の例では、エンジニアが障害の通知をClaudeに渡すところまでは、人間の役目として描かれています。
完全に自律するAL5では、その通知すら要りません。Claudeが自分で障害を見つけ、調べ、直し、本番に出すところまで担い、人間は関わらなくてもよい状態です。報告書は、測った範囲でClaudeが完全に自律して動いている領域はない、と明記しています。「AIが自分で次のAIを作っている」という言い方は、現時点では強すぎます。
主導の割合は、半年で1%未満から26%へ伸びた
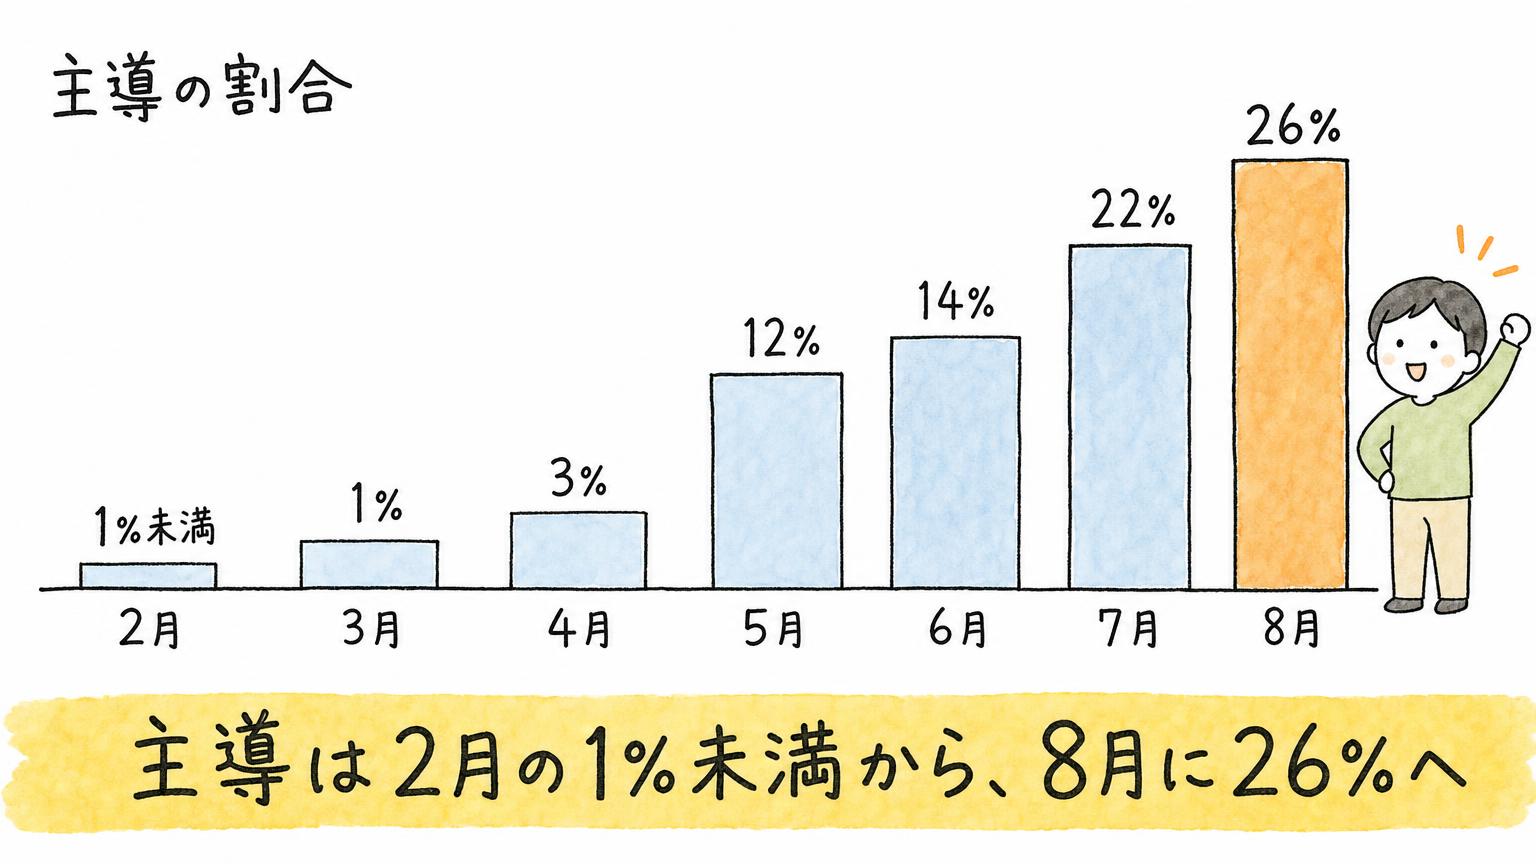
レポートのグラフを読むと、2026年2月は1%未満でした。そこから3月が1%、4月が3%、5月が12%、6月が14%、7月が22%、8月が26%と読み取れます。グラフの縦線は90%の測定区間で、どの月も幅のある推定値です。
Bloombergも、年初は実質ゼロだったと伝えています。5月に大きく上がり、その後も伸びが続いています。
重要なのは、この変化の速さです。グラフの読み取りでは、協働以上の割合は、2025年8月の数%から、2026年2月に3割台、8月には9割超へ伸びています。
1年前は、大半の仕事が「補助」か「ごくわずか」の段階でした。それが1年足らずで、AIが主導する仕事まで増えてきました。
Claudeを作っているAnthropicでさえ、主導が1%を超えたのは今年の3月です。いまも大半の仕事は協働の段階にあり、グラフの読み取りでは約7割を占めます。
なお、この物差しは「7月時点の仕事」を固定しています。伸びたのは、同じ仕事の任せ方が深まったということで、新しい仕事が生まれたかどうかは、この指標だけでは分かりません。
報告書はここも確かめています。1月時点の仕事で分類を作り直して比べたところ、2月から7月にかけて新しい種類の仕事が増えた形跡は見つからず、モデル開発の仕事の構造は、この分析の粒度では安定していると示唆されたそうです。
この伸びの要因を切り分けた分析は、報告書には載っていません。モデルの性能が上がったのか、使う側が任せ方に慣れたのか、その寄与までは分かりません。このペースが続くのか、頭打ちになるのかも、報告書からは読み取れません。
ここから先は僕の見立てです。この変化の速さを見ると、段階的には、完全に自動化される領域も増えていくと思います。
この数字は、Claudeが測りClaudeが判定している
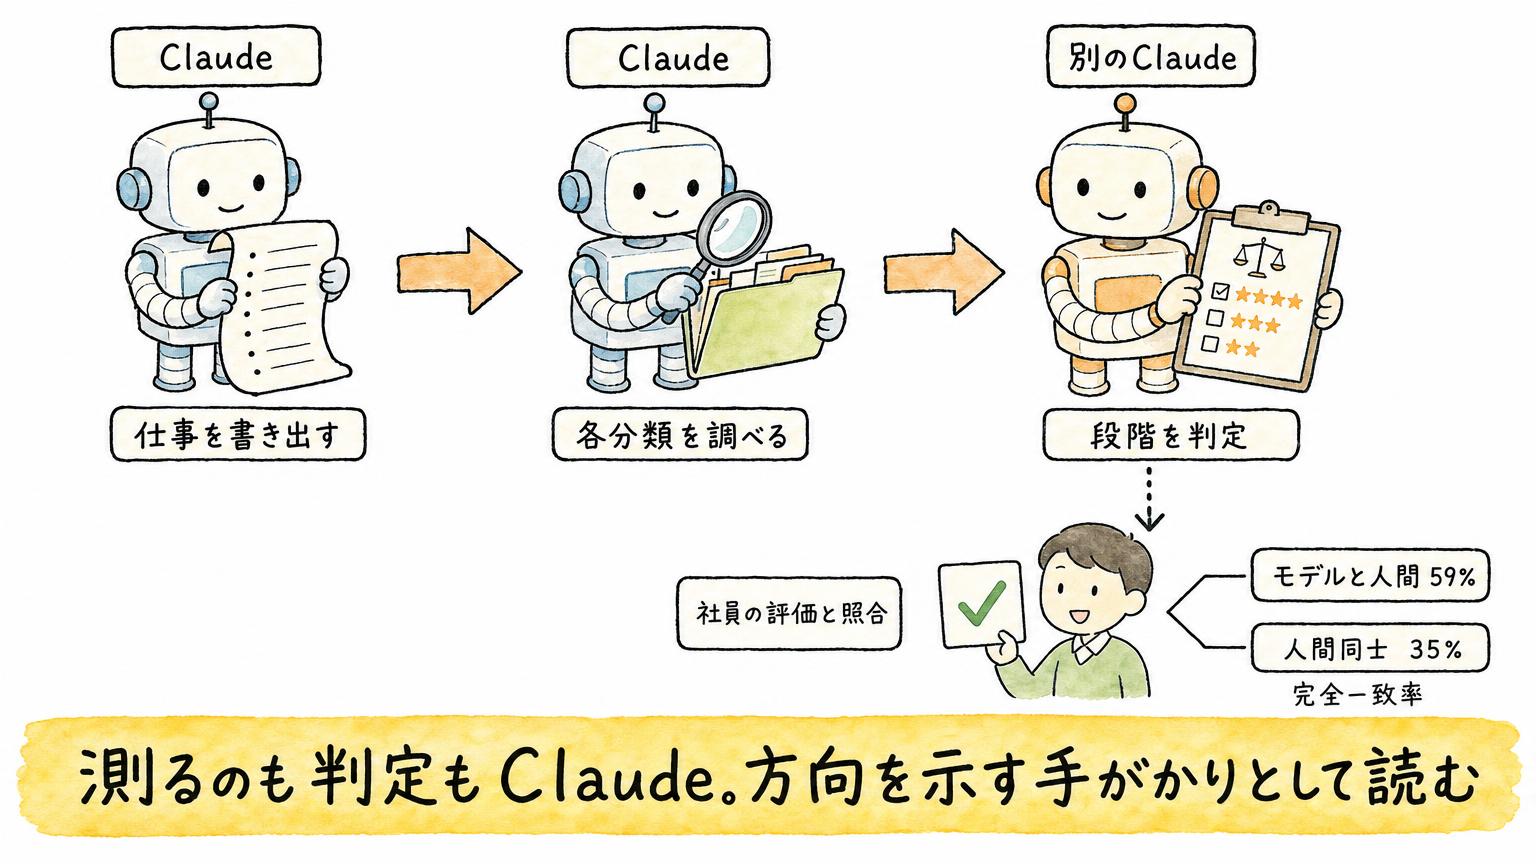
仕事を書き出したのも、各分類を調べたのも、段階を判定したのもClaudeです。判定役は、独立した別のClaudeが務めています。
Anthropic自身も、自社のモデルで自社を評価しているため、判定役のモデルが、評価される側のモデルと同じ種類の間違いをする可能性があると認めています。
対策として、担当領域の社員にも、証拠を見せずに評価してもらっています。段階まで完全に一致した割合は、モデルと人間で59%、人間同士では35%でした。モデルと人間の評価が1段階以内に収まった割合は97%です。
人間同士でも、段階まで完全に一致するのは3割台です。報告書も、協働と主導の境目のようなケースでは判断が割れる余地が残ると書いています。
この数字は、Anthropicが自社で測って公表したもので、第三者が数字を検証した結果は報告書に示されていません。Anthropicは、複数の組織の第三者評価者を社内に受け入れる計画だと述べています。
僕は、この26%を正確な実測値ではなく、方向を示す手がかりとして読むのが妥当だと考えます。
▶︎ あわせて読みたい:社員132人の自己申告も、Anthropic社内の数字でした
人間の仕事は「作る」から「確認する」へ動く
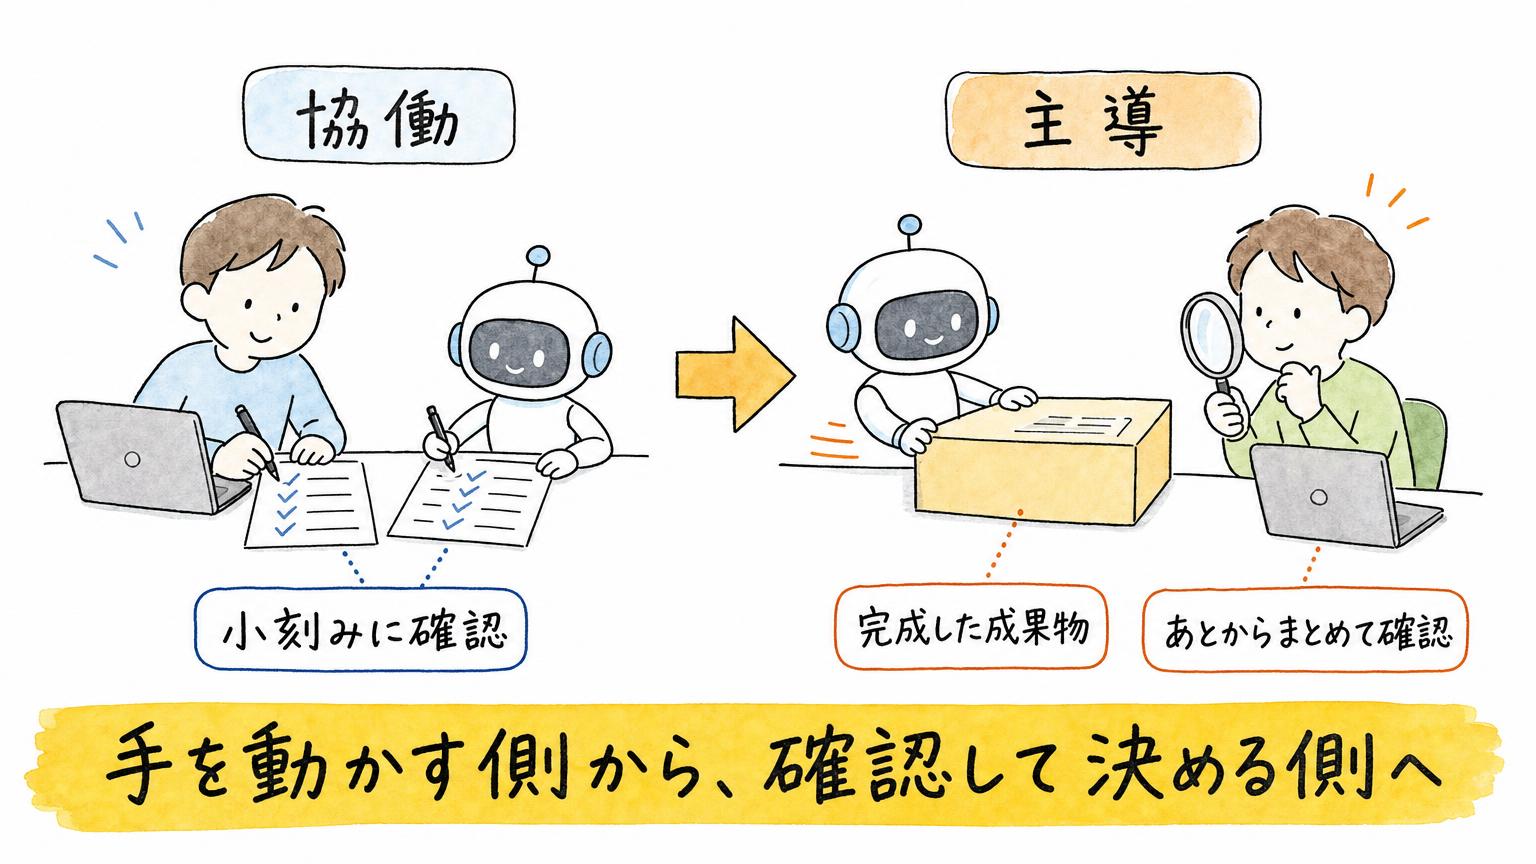
先ほどの例をもう一度見てください。協働の例では、エンジニアが変更を1行ずつ確認します。主導の例では、Claudeがまとめた報告を読み、変更をざっと見て、出すかどうかを決めます。
人間の仕事は、手を動かす側から、確認して決める側へ動いています。定義と例からは、そう読み取れます。
報告書は、作業が協働から主導へ進むと、次にどの研究方向を追うかといった、より重い判断までエージェントが担い得ると書いています。そうした判断には、歯止めと監視の仕組みが要るというのが報告書の立場です。
ここから先は、報告書ではなく僕の見立てです。AIの実行が速くなっても、確認する人の数と時間は増えません。
協働なら、人間が途中まで伴走しているので、確認は小刻みで済みます。主導では完成した成果物を後から見るので、途中の判断が見えないぶん、1件あたりの確認が重くなります。確認が、次の制約点になり得ます。
ただし、この制約は固定されたものではなく、段階的に動かせると僕は考えます。最初は、任せる範囲を絞って、結果を丁寧に確認する。任せられると分かってきたら、確認する範囲、頻度、対象を少しずつ減らして、任せる範囲を広げていく。新しいメンバーに仕事を任せていくときと、同じ順番です。
Claudeを作るAnthropicでも、主導が広がるまでには時間がかかりました。一般の企業が同じ変化を起こすには、もっと時間がかかるはずです。意識して速度を上げなければ、この形には近づけないと僕は見ています。
確認は全件ではなく、絞り込んで人が見る
報告書には、確認の設計の実例も載っています。エージェントの行動を監視する仕組みの測定です。
社内でもっともよく使われる基盤では、常時およそ3万体のエージェントが研究と開発の仕事をしています。この測定は、その基盤だけが対象です。すべての行動は、実行の前に自動の監視を通ります。
8月は10億件を超える判断のうち、実行前の監視でブロックされたのは0.002%(約4万7千件に1件)でした。ブロックされた行動は、人間が1週間以内に見直します。
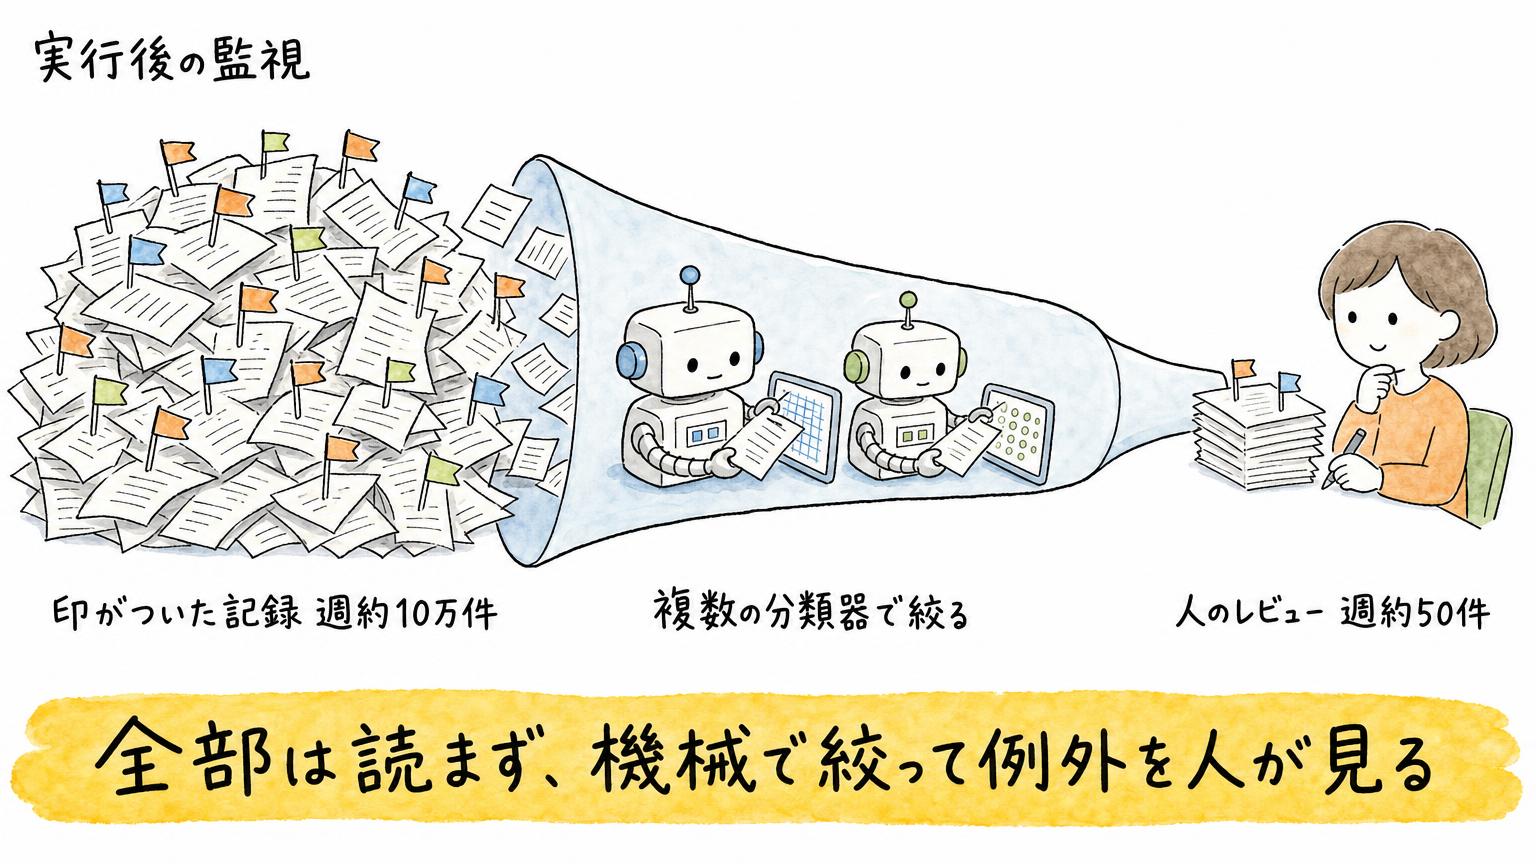
実行後の監視もあります。週におよそ10万件の記録に印がつき、複数の分類器が誤検知を取り除きます。大半はそこで解消し、優先度が高い週約50件が人間のレビューに回ります。
週10万件の印が、約50件に絞られます。全件を人が読むのではなく、機械で絞り、例外を人が見る設計です。
ただし、これは危険な行動を止め、その兆候を見つけるための安全監視の話です。報告書はこの測定を、エージェントの行動の監視として説明していて、研究成果物を人が承認する場面は扱っていません。この種の監視は、まだ数年ではなく数か月分の経験しかなく、知見は今後大きく変わると見込んでいる、とも書いています。
ここから先は僕の考えです。低リスクの仕事は確認を減らし、高リスクの仕事はしっかり確認する。リスクの大きさで、見る場所を分ける設計が要ります。責任を取るために確認するのは、これからも必要です。
ただ、それは今この時点の話です。任せられる範囲が広がるにつれて、確認は少しずつ減らせます。確認が制約になる状態は、時間とともに改善していくものだと僕は見ています。
明日から持ち帰る3つ
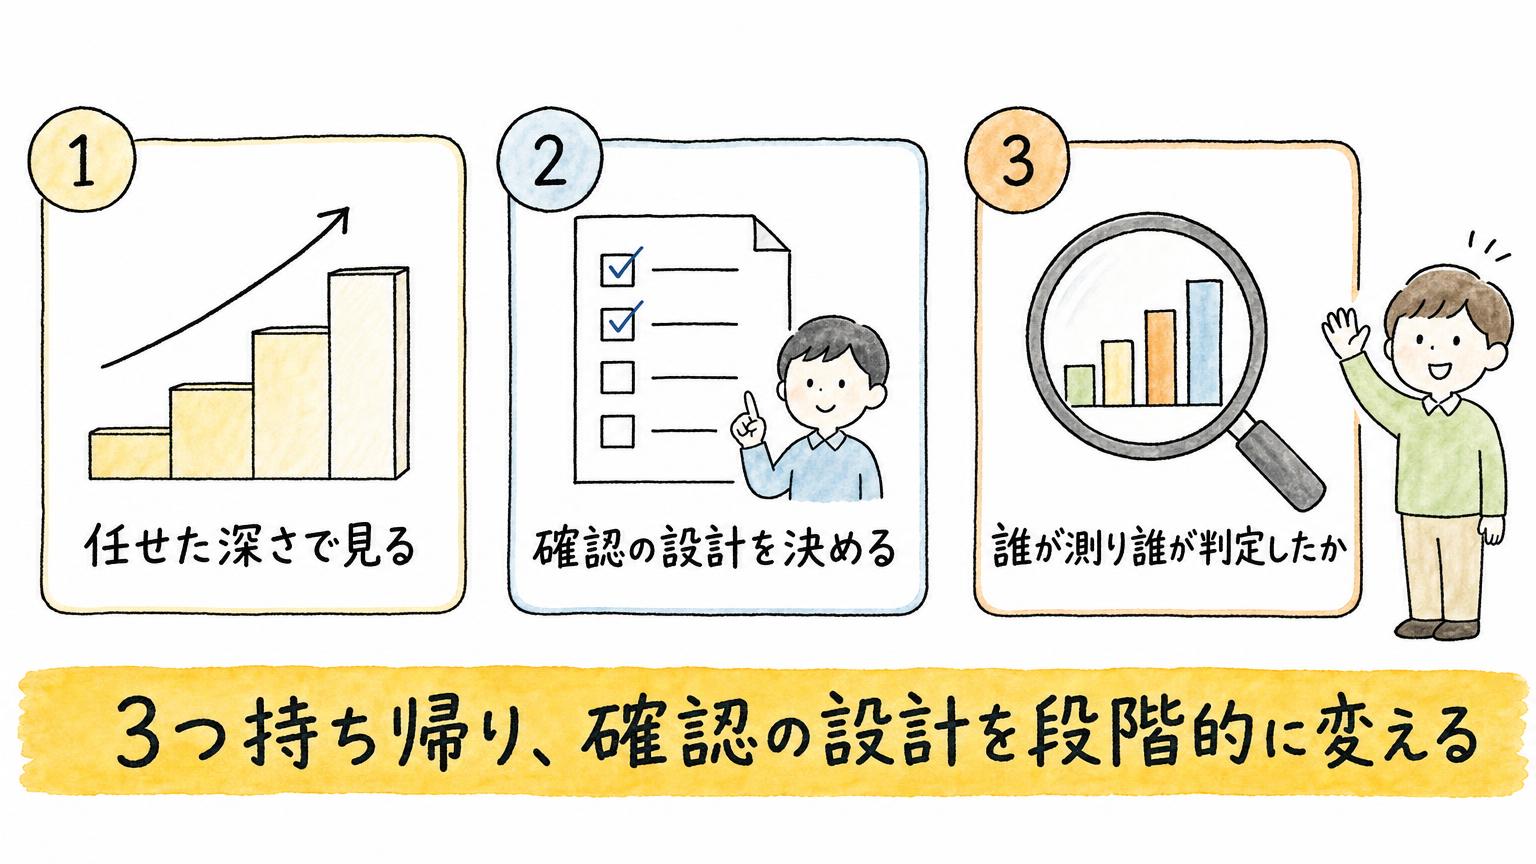
今回の話を自分の仕事に引き寄せると、次の3つになります。
1つ目は、AI活用を「使った回数」ではなく「任せた深さ」で見ることです。今週AIを使った仕事を3つ挙げて、自分が細かく指示した「協働」か、通知やゴールだけ渡して最後まで任せた「主導」かに分けてみてください。
2つ目は、主導に広げる前に、確認の設計を決めることです。誰が、何を、どこまで見るのか。報告書の障害対応の例では、Claudeが「何が問題で、何を変えたか」を書き上げ、エンジニアはそれを読み、変更をざっと見て、今夜出すか待つかを決めます。AIに同じ形の報告を書かせる運用にすれば、確認の手間を抑えやすくなると僕は考えています。
3つ目は、数字を見るときに「誰が測り、誰が判定したか」まで確認することです。今回は自社の公表で、判定役もClaudeで、第三者が数字を検証した結果は示されていませんでした。
日本の職場には、稟議や決裁が何段階も重なる会社が少なくありません。AIが主導する仕事が増えたとき、最初に詰まるのは実行ではなく、承認の段数かもしれません。これは僕の仮説です。
ただ、詰まったままにするのが正解ではありません。任せて、確認して、任せられると分かったら確認を減らし、また任せる範囲を広げる。このサイクルを早く回した企業ほど、任せられる範囲を広げて、有利になっていくと僕は見ています。競合が先に切り替えれば、そちらが有利になります。早く始めて、段階的な変化を実現していく必要があります。
僕は、26%を、AIが速くなった数字というより、人間の仕事の置き場所が動いた数字だと読みます。だからこそ、確認の設計を段階的に変えていくサイクルへ、早く向かいましょう。
よくある質問(FAQ)
Q1. Claudeが研究開発の26%を「主導」しているとは、どういう状態ですか?
AI関与の6段階のうち、AL4にあたる状態です。人間が高いレベルの指示を出すと、Claudeが作業の大半を最後までやり遂げ、人間は監督に回ります。
26%は、研究開発の仕事全体を、その仕事に割かれた人の時間で重みづけしたとき、26%分でAIが「主導」の段階にあるという意味です。使った回数ではなく、任せた深さを測っています。
Q2. 「協働」と「主導」は何が違いますか?
協働(AL3)は、人間の綿密な指示のもとで、Claudeが大きなかたまりの作業をこなす段階です。主導(AL4)は、高いレベルの指示から作業の大半を最後までやり遂げ、人間は監督に回る段階です。
報告書の障害対応の例では、協働ではエンジニアが変更を1行ずつ確認して本番に出します。主導ではClaudeがまとめた報告をエンジニアが読み、変更をざっと確認して、今夜出すか待つかを決めます。どちらの例でも、本番に出す判断は人間です。
なお「協働は約9割」という要約は正確ではなく、報告書の表現は「協働以上が9割超」です。26%の主導は、その内側に含まれます。
Q3. Claudeが測って判定した26%という数字は、信頼できますか?
仕事の書き出しも、各分類の調査も、段階の判定もClaudeが担っています。Anthropic自身も、判定役のモデルが評価される側と同じ種類の間違いをする可能性を認めています。
対策として社員にも証拠を見せずに評価してもらっており、段階まで完全に一致した割合は、モデルと人間で59%、人間同士で35%でした。モデルと人間の評価が1段階以内に収まった割合は97%です。第三者が数字を検証した結果は示されていないため、この記事では、正確な実測値ではなく方向を示す手がかりとして読むのが妥当と考えます。
新著(7/27発売)『Claude 最強のAI自動化術』:https://amzn.to/4eTUVG1
Claude Codeで仕事を自動化する仕組みを、手を動かして作る回は、いけともハンズオンの「Claude Codeの自動化術」で扱っています:https://handson.workstyle-evolution.co.jp/
AIニュースの解説は、YouTube『いけともch』でもほぼ毎日扱っています:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事

公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ