AIに研修資料を7時間丸投げして90点——納品できる割合は約2割から約4割へ(Claude・Gemini)
- Claude Fable 5.2とGemini 4 Carbonの登場で、AIに丸ごと任せられる範囲が一段広がった。
- 研修資料づくりを約7時間・約80体のエージェントに任せ、90点の出来で仕上がった。
- 納品できる割合は約2割から約4割へ。確認の手間は残るので、分けて任せる判断も要る。
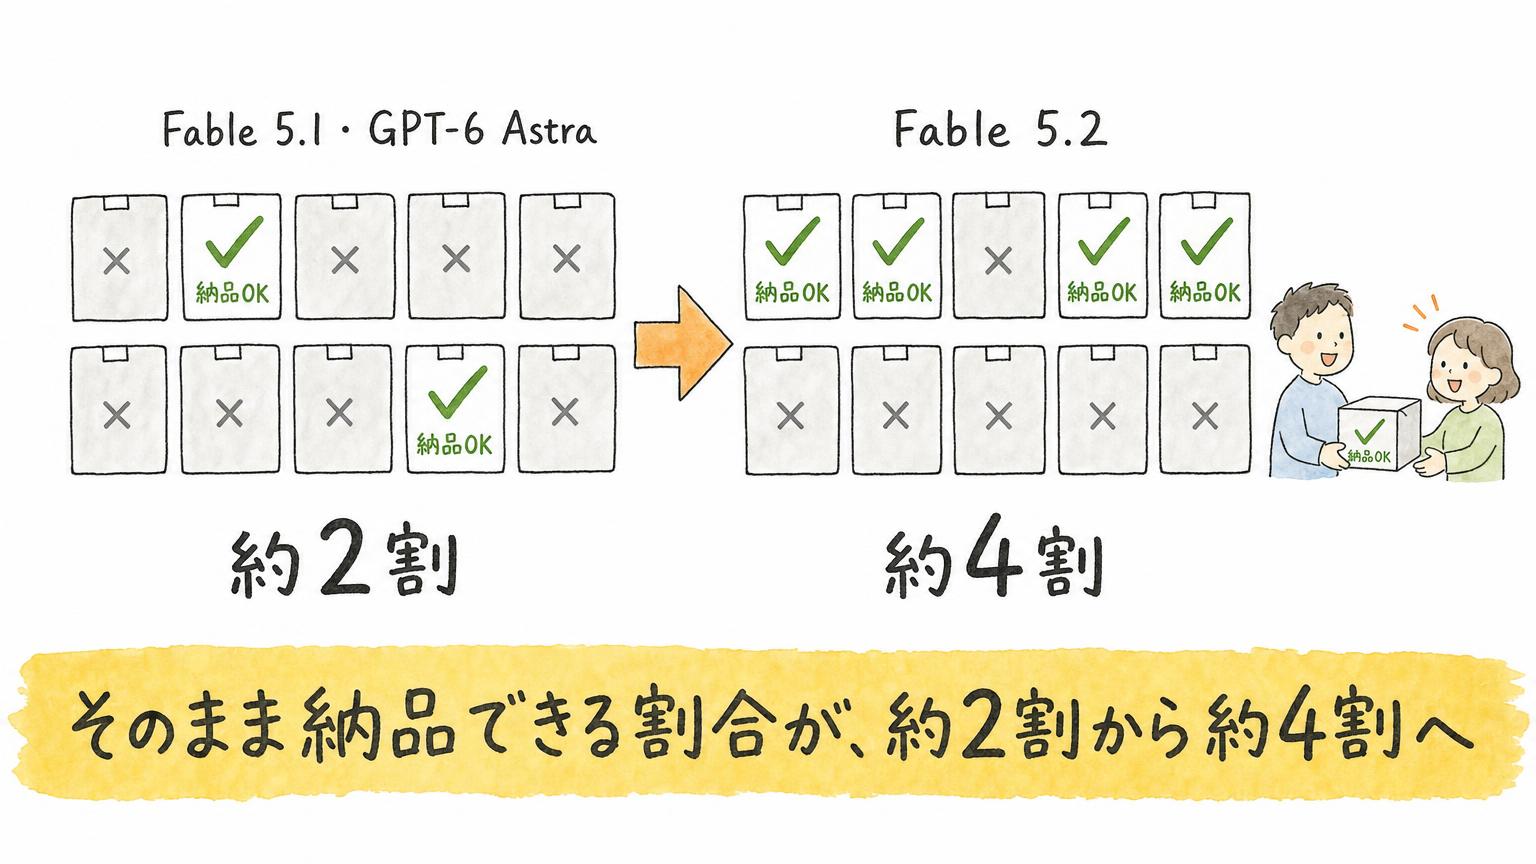
そのまま納品できる割合が、約2割から約4割へ。ほぼ2倍
いけとも:こんにちは、いけともです。
尾原:尾原です。今日のテーマは、フロンティアモデルのリリースが相次いでいる話です。Claude Fable 5.2と、Gemini 4 Carbonですね。
いけとも:公開されているベンチマークと、僕が使ってみた肌感を、あわせて話せればと思います。
尾原:Gemini 4 Carbonは、ランキングで上位に来た、という話です。Fable 5.2は、前にいろいろあってからのマイナーアップデート。とはいえ、今回はかなり実用的な更新でした。
いけとも:まさに実用的なんです。まったく違うモデルになったわけではありません。ただ、これまでより任せられる範囲が広がった。一気に丸ごと振ったときの期待値の天井が、上がった印象です。
僕はいつも、ベンチマークのテスト結果を見ています。どのモデルも「良くなりました」と、大量の項目が出ます。10個も20個もあって、正直、その点数が何を表すのか分からないことが多いんです。
だから最近は、前のモデルに比べて数字が大きく動いたところだけを見て、その裏のベンチマークが何を測っているのかを調べています。
Claude Fable 5.2の発表で、今回いちばんおもしろかったのが、「Remote Labor Index」です。実務の仕事を想定したベンチマークです。
尾原:どんなテストなんですか。
いけとも:リモートワークの依頼を、人間に本当に出したとします。納品物を、依頼主が受け入れられるか。そこを測っています。依頼は約240件あって、AIに頼んで出てきた成果物を、人間が評価します。
中身は、かなり現実的です。製品デザイン、建築、広告、動画づくり。実際にありそうな依頼ばかりです。
尾原:それで、結果は。
いけとも:Claude Fable 5.1やGPT-6 Astraでは、約2割でした。それがFable 5.2では、約4割に上がっています。「そのまま納品できる水準を満たせるか」が、ほぼ2倍になったんです。
研修資料の丸投げ、約80体のエージェントが7時間で90点
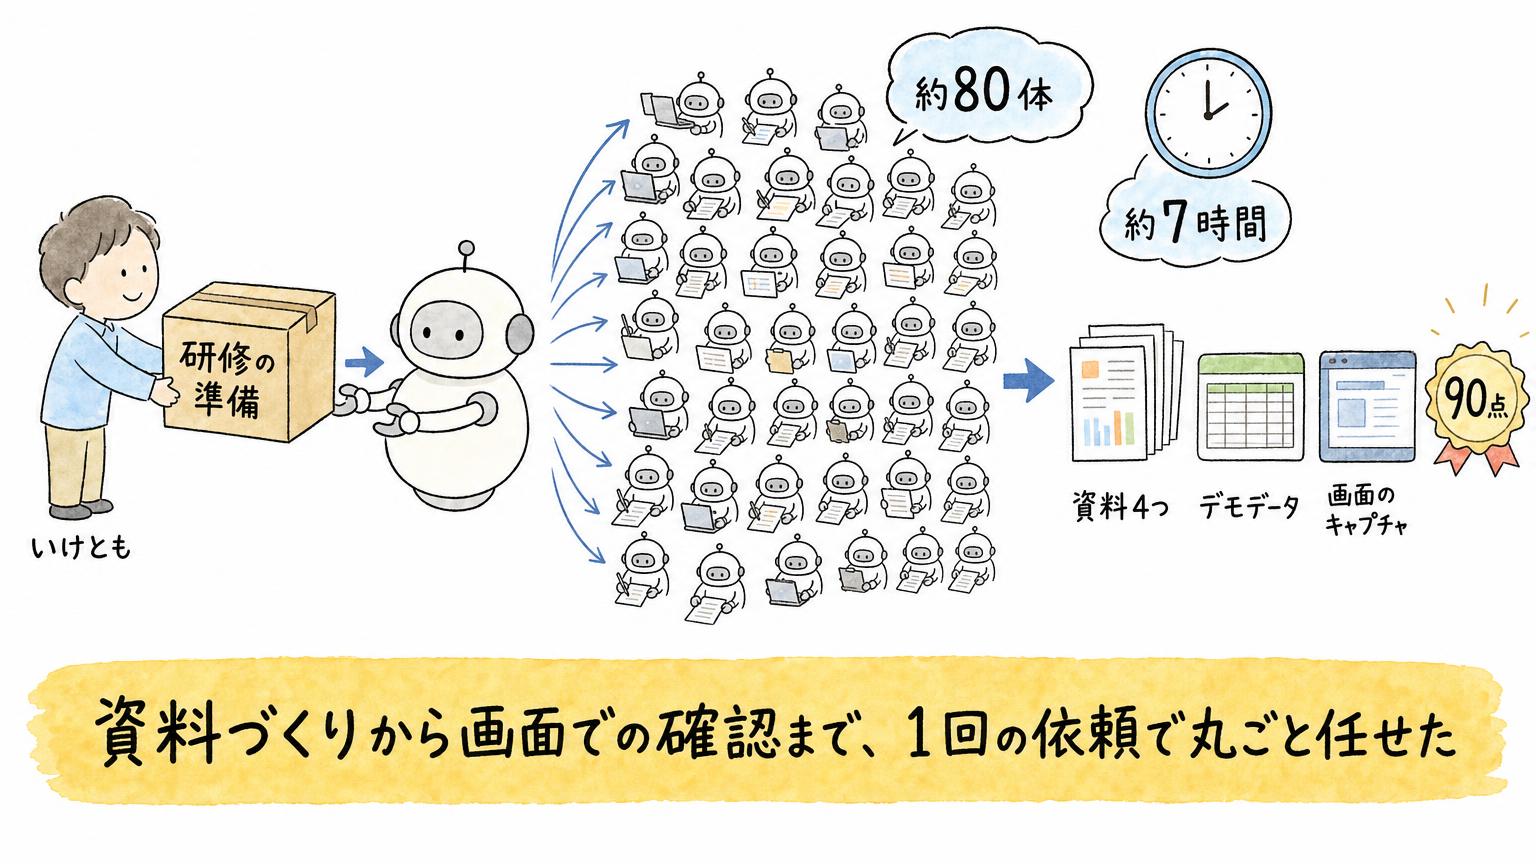
いけとも:この数字を見て、僕もやってみました。これまでもエージェント版のAIは使っていました。ただ、任せる玉は大きいと自分も大変なので、なるべく切って渡していたんです。
今回は、自分の研修の準備で試しました。Geminiを使った研修で、Geminiのチャットや、スライド、スプレッドシートの右側のサイドパネルを、ハンズオンで触ってもらいます。
これまでも、資料をつくる、デモデータをつくる、といった作業は、それぞれAIにお願いしていました。ただ、その作業と作業のあいだは、自分でつないでいたんです。とくに、デモデータをつくったあとに、実際の画面で操作して確かめる部分は、自分で確認することが多く、そこにまあまあ時間がかかっていました。
今回は、その先まで頼みました。内蔵ブラウザーでサイトを開いて、実際に動かせますよね。その検証まで含めて、全部です。
資料をつくる。デモデータをつくる。デモデータを実際の画面に入れて、実行する。実行結果の画面を撮って、資料に反映する。ここまで、丸ごと頼んでみました。
尾原:どこまで行きましたか。
いけとも:約7時間、ずっと動いて、最後に仕上げてくれました。4つの資料と、デモデータ。実際にやった結果のキャプチャは、資料にどんどん追加されていきます。さらに、講師の僕向けに、「この部分は、今回のデモでは使っていません」といった補足まで付いていました。
ここまで一式が終わって、約7時間で90点くらいです。こっちが確認するのは大変なので、細かく分けた方がやりやすい面もありました。でも、丸投げしても行ける水準が、また一段、広がったと感じました。
終わったあとに、AIに振り返りをお願いしました。エージェントは、約80体使っていたそうです。機能ごとに担当を分けて、終わったものを集めてチェックし、別のエージェントに渡していく。これを、1回の依頼で勝手にやってくれました。
消費したトークンは、約4億トークンです。ただ、キャッシュも使っているので、毎回新規に消費しているわけではありません。合計の数字は大きいですが、実際のコストは、そこまでではないと思います。それでも、この量を1回の依頼で、いい感じに回せる。かなり触れるなという感触がありました。
「ツールを回して検証し切れるか」へ移った勝負の軸
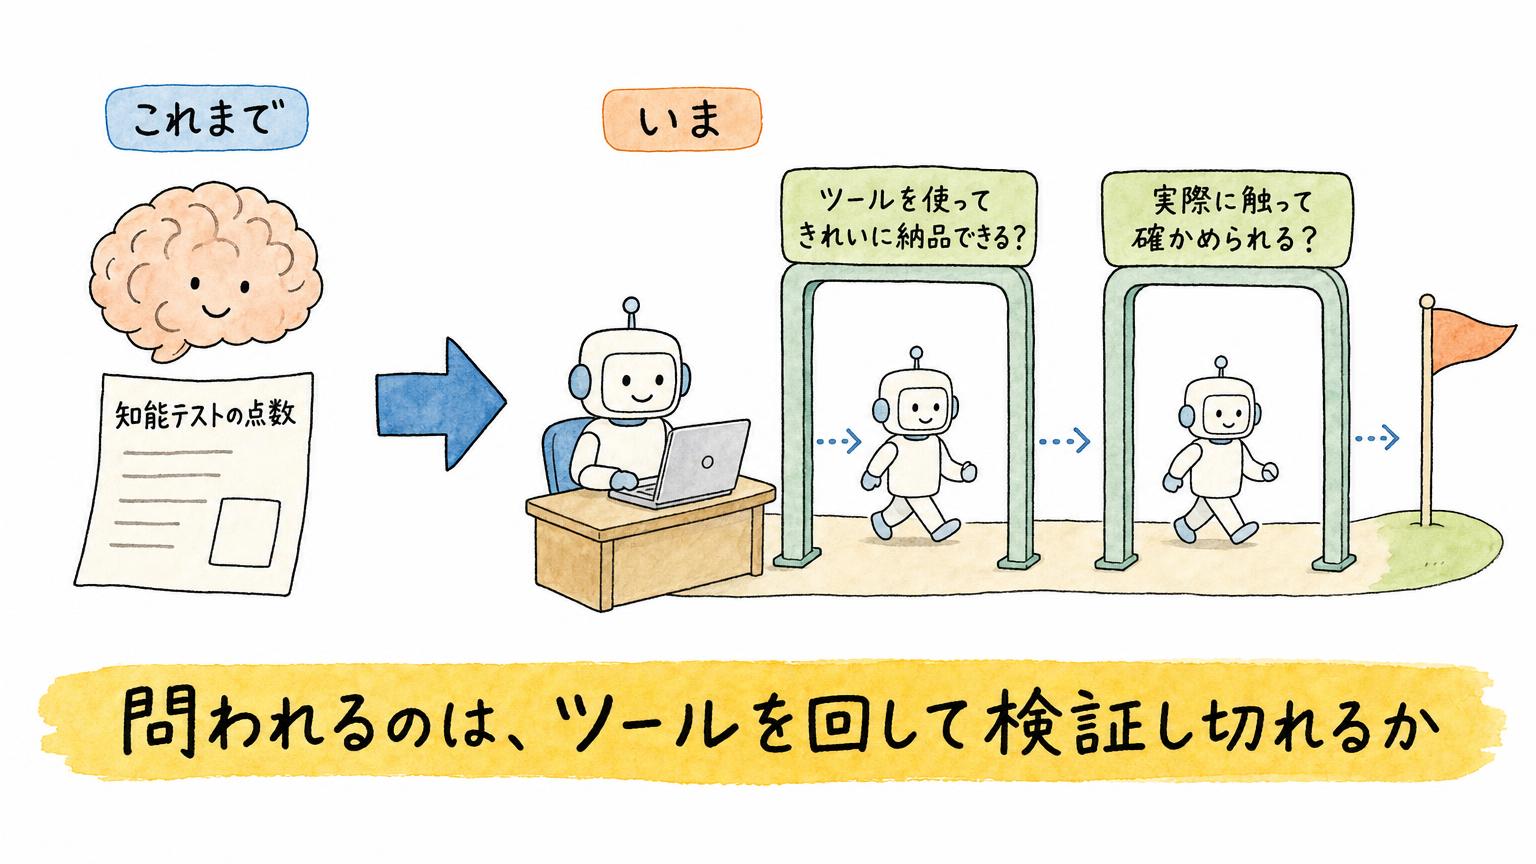
尾原:この話が面白いのは、最近の評価が、単純な知能レベルから離れてきている点です。実際の仕事を、どこまで任せ切れるか。「完了を売ります」「エンドツーエンドでできます」という話に、なってきました。
実務の感覚では、エージェントを8時間ぐらい回し続けても、エージェントが狂わない。このロングホライゾンの水準は、いったん、いい感じになってきました。
いけとも:8時間ぐらい、走れるようになったと。
尾原:はい。そうなると、ビジネスの論点は2つに絞られます。
1つめは、外部ツールを、複数のサブエージェントごとに活用していったときに、きれいな納品物が出るか。ツール活用を含めた、サブエージェントのマネジメントが、実用レベルに入っているかどうか。
2つめは、外部ツールや、つくったアウトプットを実際に触って、確かめられるか。検証として、十分に満足なものができるかどうか。
いけとも:この2つですよね。
尾原:はい。各社が、何の検証に重みを置いているかは、リリースごとに見えてきます。これまでChatGPTは、「GDPval」という、業種別に成果物を出せるかを測るテストを前面に出していました。そこから、さきほどのベンチマークのように、リモートで複数のツールを往復しながら、やり切れるかに、シフトしています。CADとか、Blenderとか、そういったツールを行き来するものです。
僕の場合は、コンテンツやマーケティング系の仕事が多いのですが、完遂率は圧倒的に上がっていると思います。
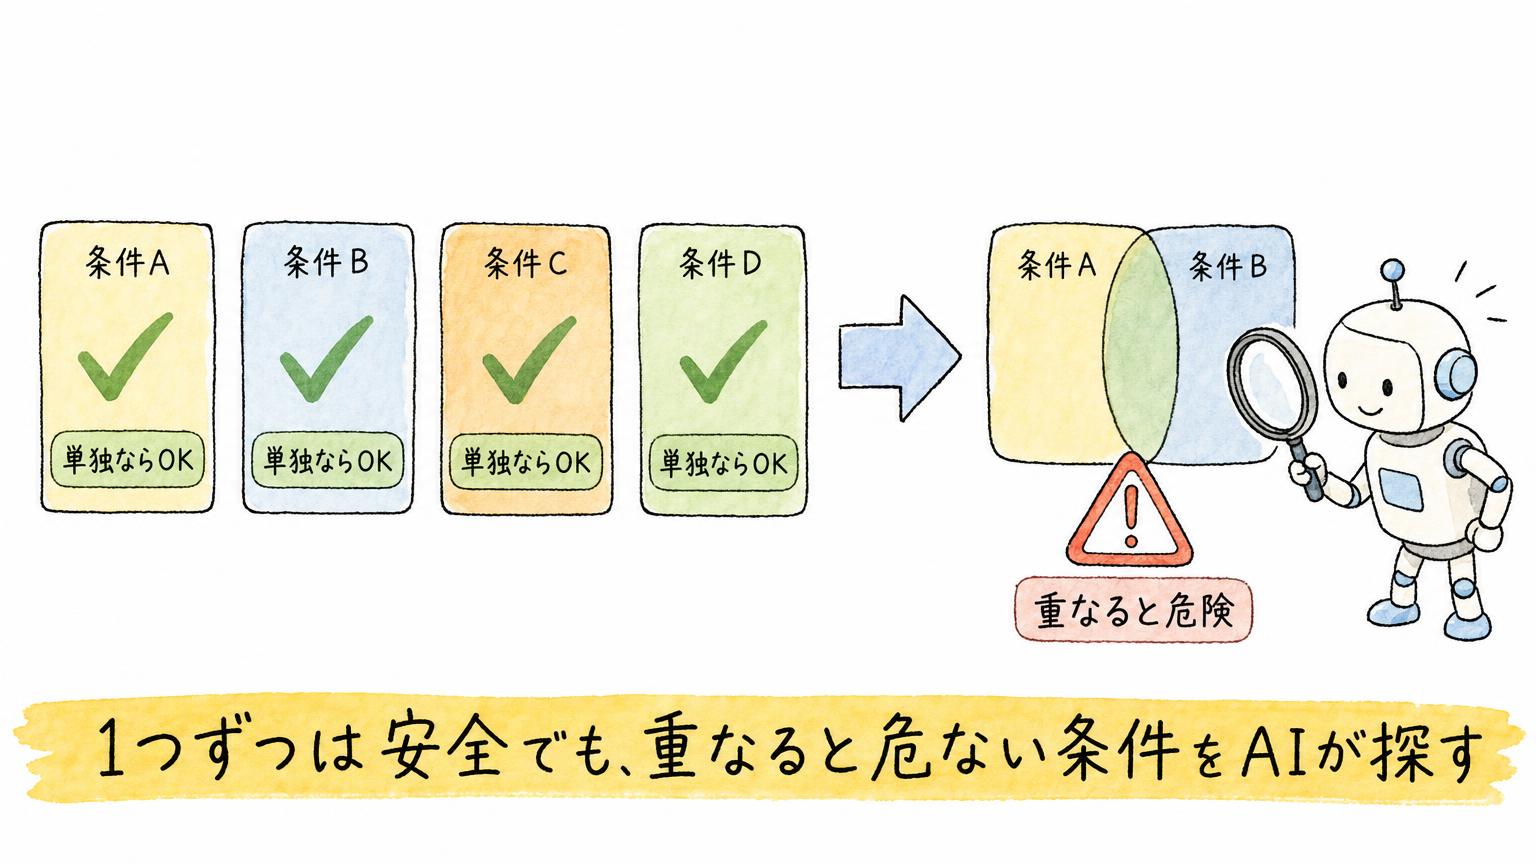
組み合わせでだけ壊れる条件を見つけ出すAI
いけとも:尾原さんは、投資の検証でも試してみたそうですね。
尾原:投資系の金融のデューデリジェンスなどが、最近は多いです。それと、来年に向けて、AIネイティブに経営していきたいときの話があります。業務の標準手順、SOPと呼ばれるものを、そもそもAI前提で、全社で変革しようという案件です。
扱うのは、大量の金融の資料です。一部は画像やチャートを含みます。業務手順書もあります。そこから、新しい価値の筋をつくりましょう、リスクを見ましょう、という使い方です。
今回、圧倒的に良くなったのは、エッジケースです。
いけとも:エッジケース。
尾原:投資の検証では、条件を1個1個見ていけば、それなりに大丈夫なんです。ただ、「この条件と、この条件が重なったときに、危なくなる」ということがある。いろいろな組み合わせの中から、本当にピンポイントで急所を見つけていく。これを「思考探索」と言ったりします。
そこが、えぐいくらいに筋が良くなってきて、しかも、諦めなくなってきました。
サイバーセキュリティも、同じです。ソフトバンクは、6月に約700システムを診断して、約1万500件の脆弱性を見つけました。それを埋めるのも大変でした。ところが、11月の決算説明会で、同じシステムをGPT-6 Astraで診断し直したところ、新たに約3万5000件出た、と語られています。
普通なら、そんなところに弱みはないだろう、と思う場所です。そこを、AIがひたすら、ひたすら動けるので、針の穴を通すように通していけます。同じことが、財務でも、業務でも、AIを使って検証できるようになっています。
いけとも:セキュリティは、組み合わせですよね。1か月ほど前に、PHPに深刻な脆弱性が見つかりました。修正版が出たのは10月21日で、日本でも、サイトの停止や緊急の対応が相次ぎました。この脆弱性は、AIを使った調査で見つかったと報じられています。
僕が聞いたのは、こういう話です。以前から、危ない入り口は1個ずつ知られていた。ただ、それを実際に使う方法が分からなかった。AIの進化で、4つぐらい組み合わせると、まずいことができてしまう、と見えてきたんです。
プログラムやシステムに限らず、財務でも、投資判断でも、あらゆる思考で、水準が一段、押し上がってきていると思います。
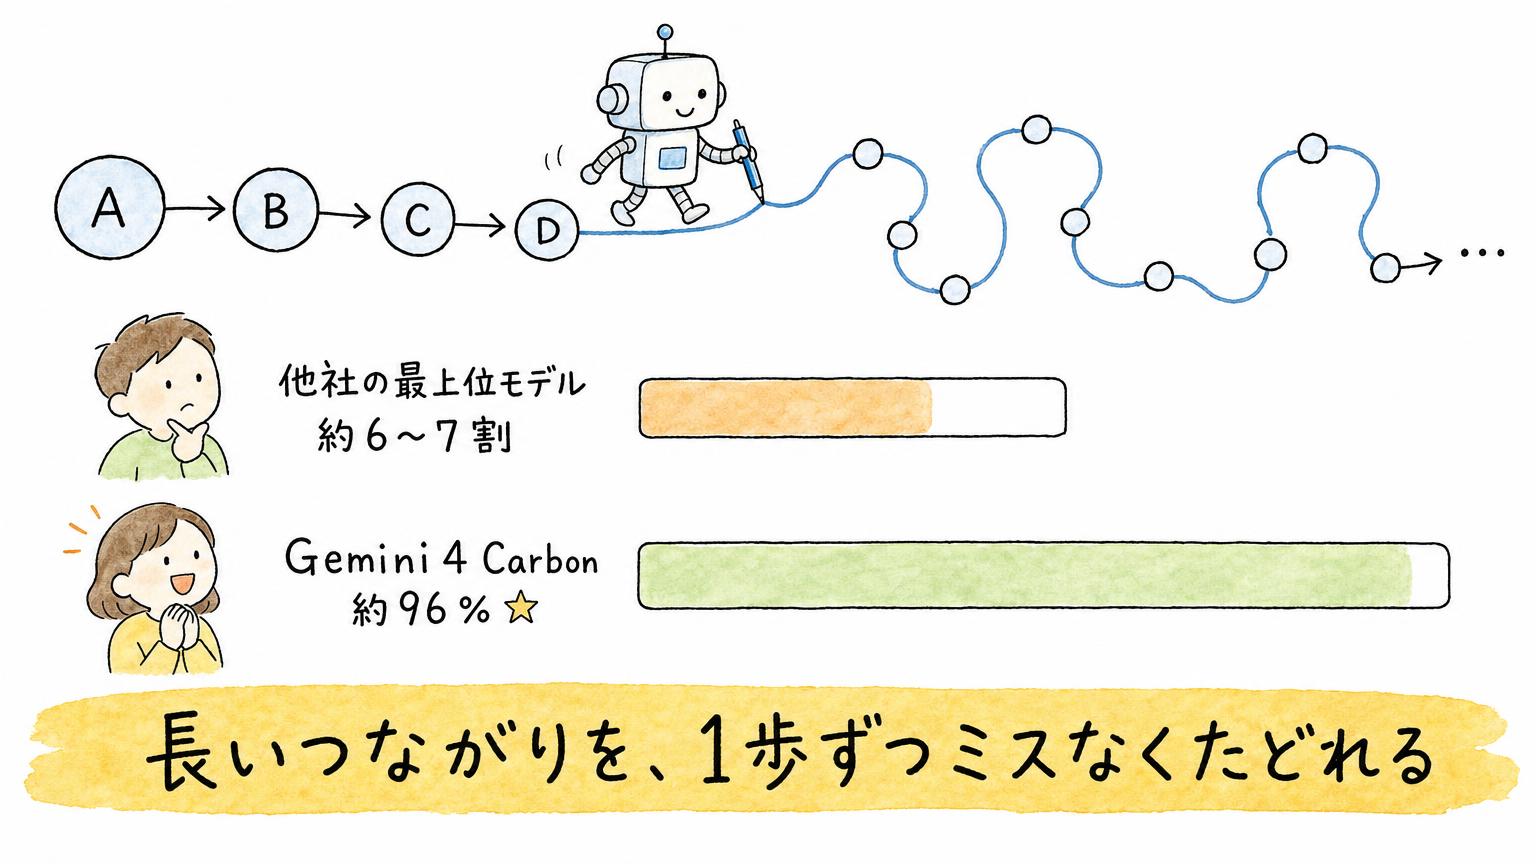
Gemini 4 Carbonは、長い繋がりを辿るテストで約96%
尾原:さっきの、紙からスキャンしたようなチャートや表を、一度、大量に入力します。そこから、検証、検証、検証を重ねていきます。
いけとも:Gemini 4 Carbonのベンチマークを見て、個人的に面白かったのは、ほぼ全部、最上位と比べて上がっていたことです。中でも、すごく上がっていたのが「Graphwalks」です。
ロングコンテキスト、つまり、とても長い文脈を踏まえたうえで、チェックするテストです。他社の最上位モデルは、6割か7割ぐらいでした。それが、Gemini 4 Carbonは、約96%になっています。
尾原:何を測るテストなんですか。
いけとも:何かなと思って見てみました。マニアックなデータなんです。「AはBにつながっている」「BはCです」「CはDです」という、つながりだけが、めちゃくちゃ大量に並んでいます。
その中で、何十回かたどらないと分からないデータがあります。それが、並列でずっと長く書いてあって、多数のパターンを見つけなければいけません。いろいろな問題を、ミスなく解けるか、という、ロジックの長いテストです。
つながりが複雑で、しかも6桁ぐらいの文字数で示されるので、人間にはまったく頭に入りません。それに対して、針の穴を通すように、1個1個、多段階で推論して、ミスなく、漏れなくやり遂げる。その度合いが、約96%です。もちろん、100%ではないんですが、できるようになっています。
実務で、この力が生きる場面は多いと思います。
論理で書ければ、AIは証明し切れる。1000体で、30時間
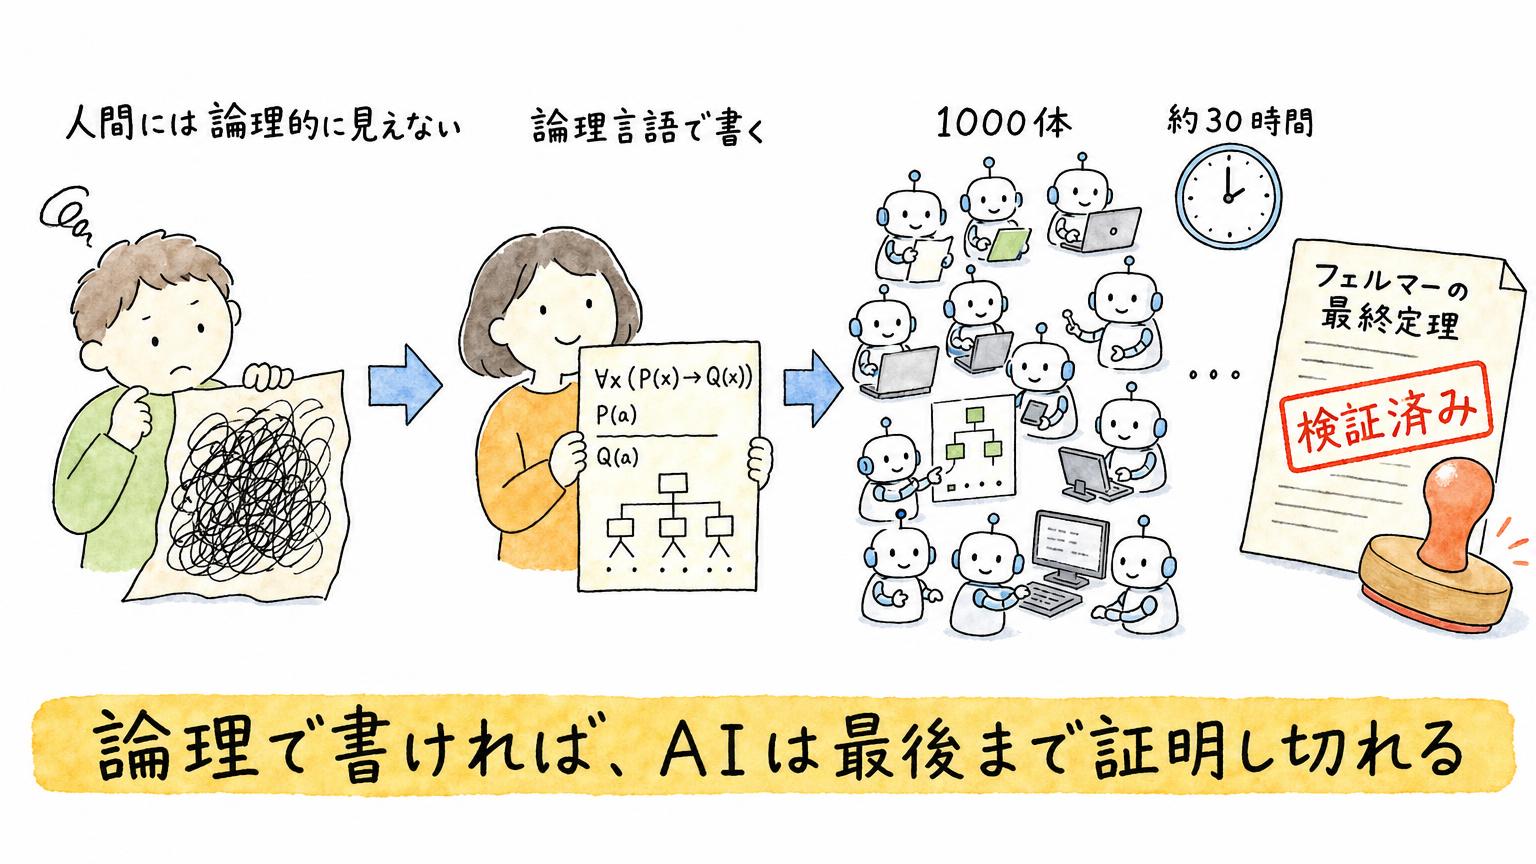
尾原:一見すると、人間には論理的に見えないことでも、論理的な表記ができるようになれば、それを証明できます。ここは、すごく大きいです。
OpenAIは、解ければ賞金100万ドルという、ナビエ・ストークス方程式の問題について、形式化したものを公開しました。ただ、その中身が正しいかどうかには、疑問の声も出ています。
同じように、Claude Fable 5.2も、今回、1000体のエージェントを使って、フェルマーの最終定理の形式化を、約30時間で完了させました。すでに証明されている定理を、コンピューターで検証できる形に書き直す作業です。
論理学的に記述ができて、その記述にもとづいて、多数のアプローチをやっていく。そこで、「これが成り立つ」と確かめる。それを、えぐいくらい安定的に、最後までやり切ってくれるようになりました。
AIの国際会議の中でも、同じ流れがありました。形式的な証明のために、どういう記述をするのか。その記述方式そのものを、AIに考えさせます。
一度、論理言語で記述できたら、その言語の中で、とにかく長時間、検証をひたすらやる。そうすると、これが破綻しないことを、立証できます。
それが、投資理論や、宇宙工学のような、とても複雑なパラメーターの中でも使えます。何かが重なったときに、とんでもない暴走をして、失敗に至る。それを、事前に回避する使い方が、できるレベルになってきました。
検証できるものは訓練できる、半年後に起きるAIの異常ケース発見
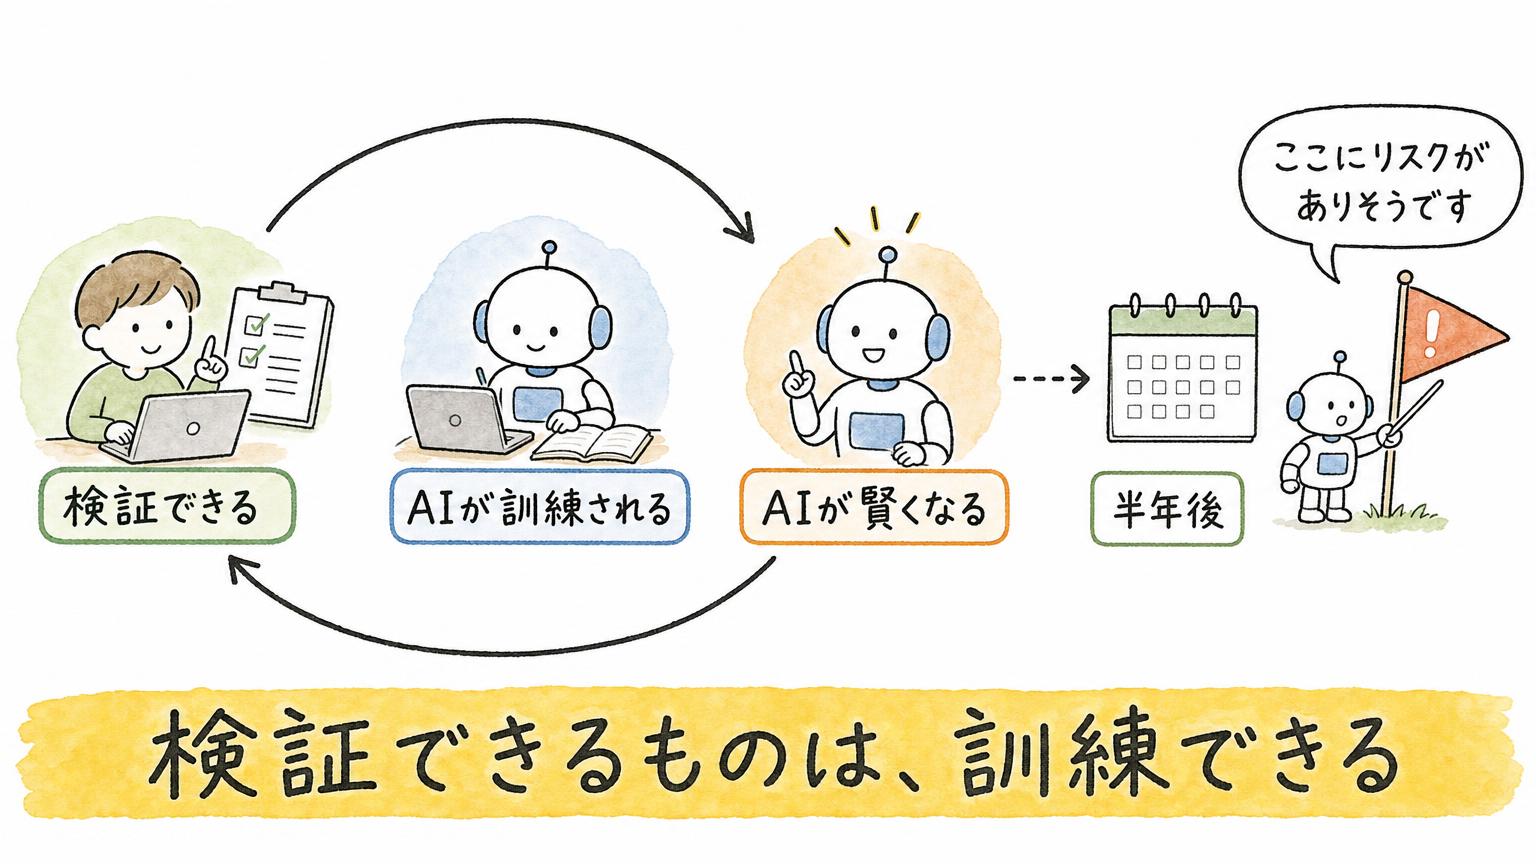
尾原:ただ、いまの話は、「何を言ってるんですか」という話だと思います。大事なのは、これができるようになったということは、検証できるものは、訓練できるという点です。
あと半年ぐらいすると、僕が分かりにくく言っていた、論理言語を中間で生成する、といった話まで含めて、AIが勝手にやってくれるようになります。いろいろなパターンで見たときに、「ここにリスクが出やすいので、このチェックをした方がいいですよ」と、AIがどんどん言ってくる。
「なんで、そんな異常ケースを発見できるの」という感じに、AIがなっていく。そう思っていただければ、皆さん、いいです。
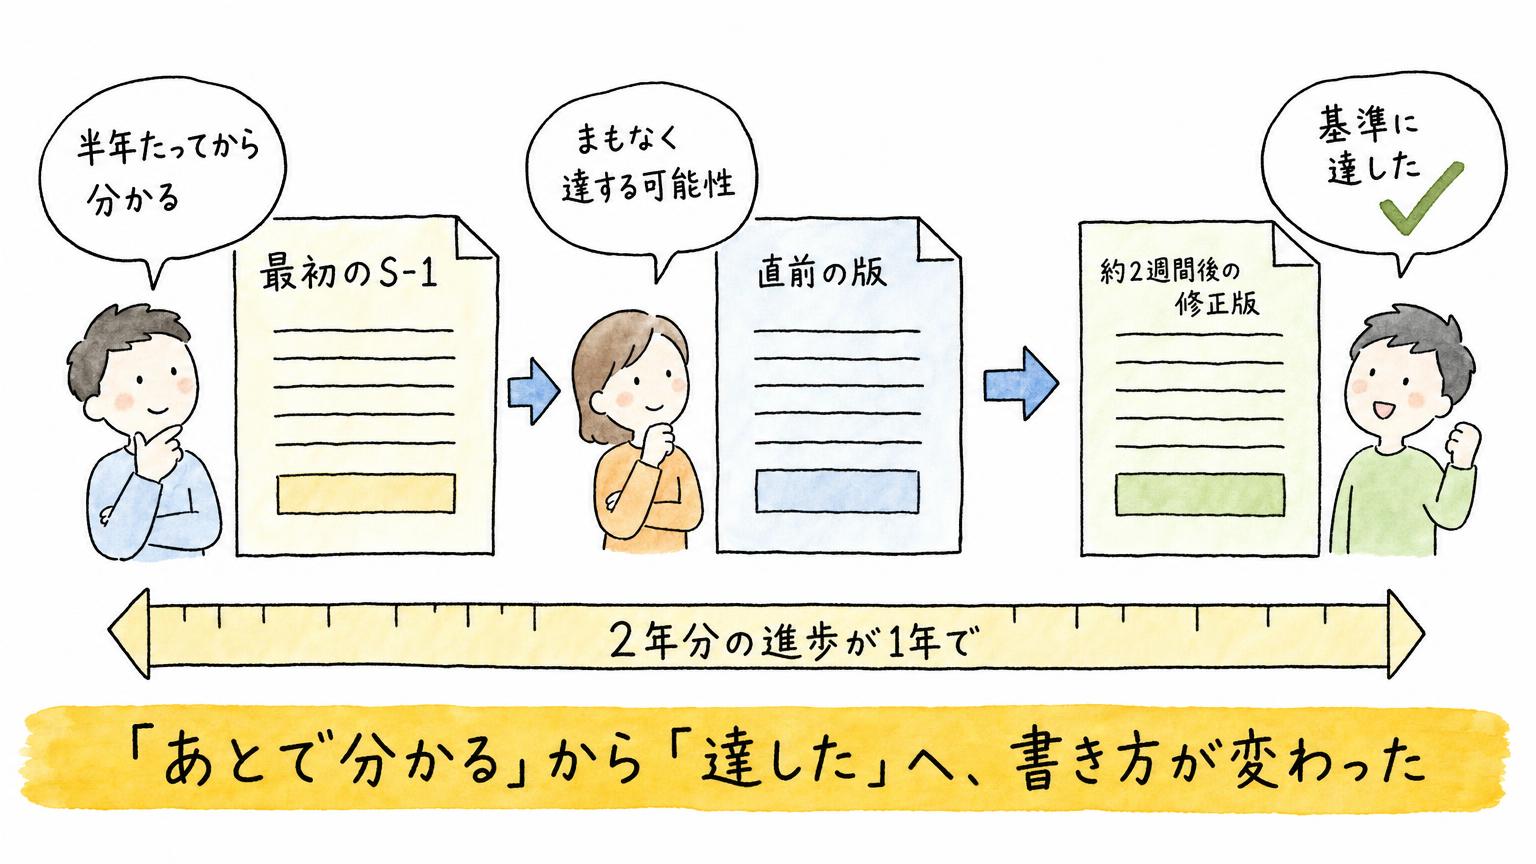
Anthropicの上場書類、「半年後に分かる」から「達した」への書き換え
いけとも:なるほど。今週、Anthropicの上場が予定されていますよね。
上場の資料で、S-1という説明資料があります。あれのバージョンが、地味に、ちょっとずつアップデートされます。
その中に、Anthropicが自分たちで定義している「RSP」、Responsible Scaling Policyという概念があります。
最初のS-1は、10月26日でした。そこでは、「AIが、いまどれぐらい進化しているのか」を問う内容です。ただ、AIが進化したかどうかは、その瞬間には分かりません。半年たって振り返ると、「2年かかるはずのことが、半年でできていました」と分かる。事後的に、分かるもの、という書き方でした。
それが、約2週間後の修正版では、基準に達したという記述に変わっていました。報道によると、直前の版では「まもなく達する可能性がある」という書き方だったそうです。
RSPの定義では、AIの研究開発が自動化された結果として、AI全体の進歩のペースが「2倍」になることを、基準のひとつにしています。「2倍」とは、基準となる2年分の進歩が、1年で起きる、という意味です。比べる相手は、想定されるペースと、AIの貢献がなかった時期に観測された最速のペース(少なくとも3つのモデル世代にわたるもの)の、両方です。
僕は、そのペースを超えてくる期待が持てる、という意味での「達した」だと読んでいます。
さっきの、半年後に、論理言語を自分で勝手につくって、さらに精度が上がっていく話と、つながると思いました。別次元のAI能力に、近づいていく方向性です。
尾原:そうですね。その速度が、2倍を超えたという見立てです。しかも困ったことに、「AI 2027」のような、恐怖のレポートが描いた予測よりも、早い速度を言ってしまっています。
でも、いま言ったとおりです。検証できる幅が広がっています。長期にわたって、やり切れる環境もできています。そのうえ、やり切ったものを、実際にツールを使って、成果物として確かめられます。たとえば、3Dモデルができあがったあと。あるいは、Webアプリケーションをつくったあと。AIが、それを実際に触って、検証する。そうやって、成果物の確度を上げられます。
この3つが、掛け算になっています。長くやり切る力、途中で検証する幅、できあがったものの検証の質。3つの掛け算なので、2倍と言っても、おかしくないと思います。上場するために、はったりをかましているわけではないと思います。
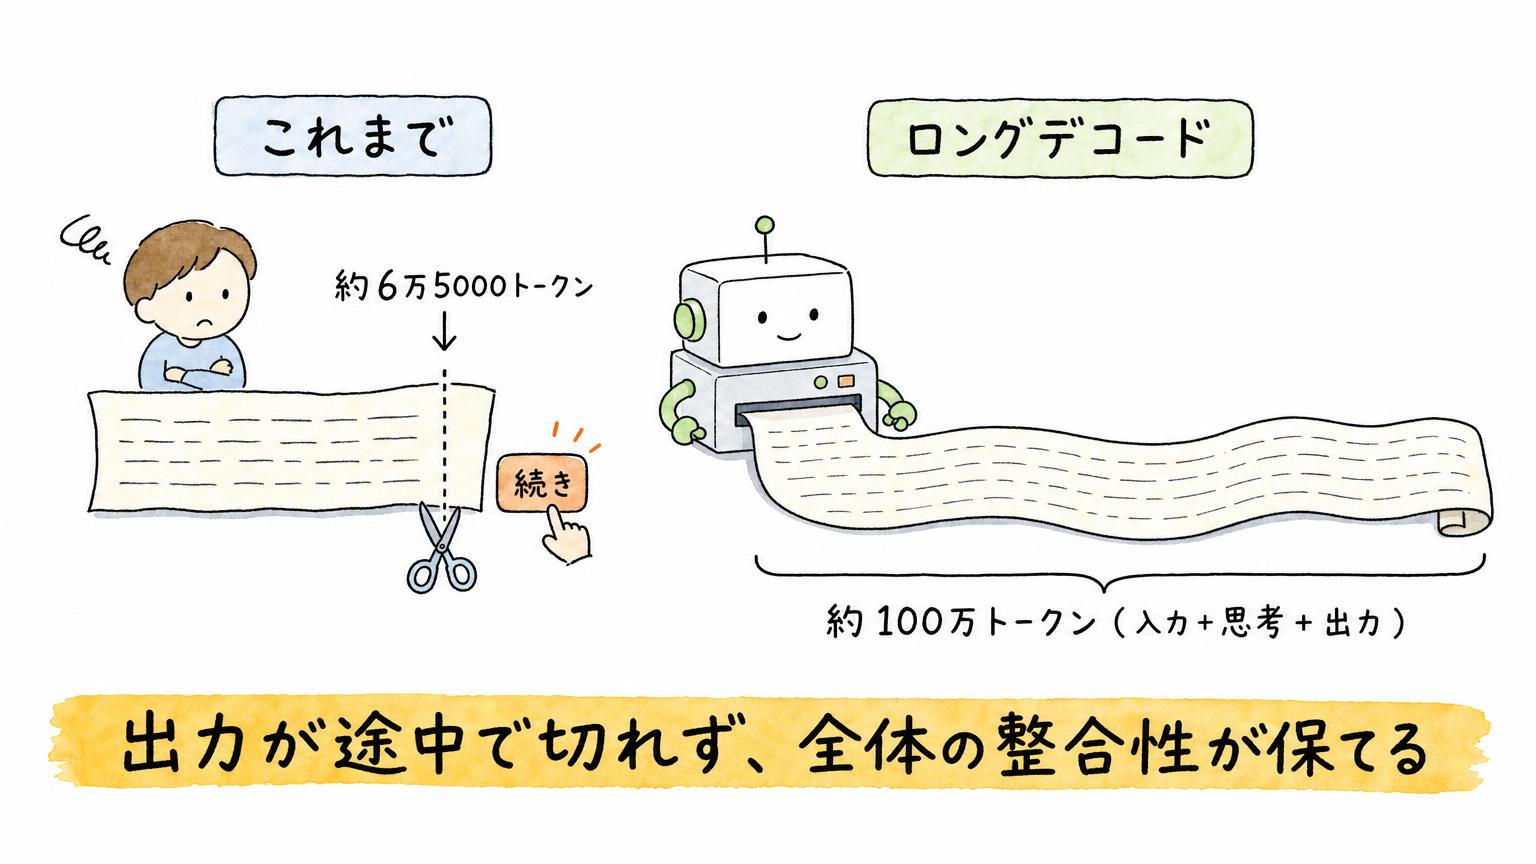
「ロングデコード」がもたらした、途中で切れない長い出力
いけとも:急に各論に行きますが、さきほどの投資の検証では、どういう使い方をしているんですか。
尾原:完全にそっちになると、ちょっとマニアックな話になります。キャッシュに当てることが、大事です。それと、今回のGemini 4 Carbonで大きかったのが、APIの「ロングデコード」に対応してくれたことです。
これまでのAIは、裏側の思考や推論で、100万トークンぐらいのコンテキストウィンドウを持って、動いてくれます。ただ、出力の部分は、途中で止まったりします。ChatGPTだと、途中で止まって、「続き」と入力しなければいけませんよね。出力の上限が上がったと言っても、約6万5000トークンぐらいでした。
それが、APIでロングデコードを使うと、入力と思考と出力を合わせて、約100万トークンの範囲で、出力をつなげて出せるようになりました。
なので、APIを直接叩いて、やっています。さきほどの、試行途中の検証性能が上がった話もあります。ただ、出力が分断されると、全体としての整合性が、損なわれるんです。
いけとも:なるほど。そういう使い方なんですね。
尾原:大きな調査体系や、仕様書をつくるときに、約6万5000トークンというのは、約3万ワードぐらいです。ビジネス書1冊分ぐらいの出力は、担保できます。ただ、それ以上の全体整合性を持って、アウトプットをつくりたいなら、ロングデコードの対応が、ものすごく大きいです。
超大型の出力の、全体整合性が取れる。ここが、すごいところです。
いけとも:知らなかった。
尾原:ただし、キャッシュにヒットしなかったら、お金が本当に飛びます。うまくキャッシュヒットさせるように、入力にテクニックを使いながら、やっていきます。これを実証に使うのは、一部の投資銀行や、生命保険、損害保険の方々ぐらいだと思います。
いけとも:キャッシュしやすくするのは、ざっくり、AIにそうやれと言えば、だいたいできると思います。最初の冒頭や前提を同じにすると、キャッシュに当ててくれます。「そういうふうに送ってね」「上に送るとき、データをユニークに入れないでね」と、AIにお願いするだけです。キャッシュを、ちゃんと使って、コスパ良くやる。この概念さえ分かれば、実装は、エージェントにお願いすれば、何とかなると思います。
エージェントを生み、失敗から学ぶエージェント
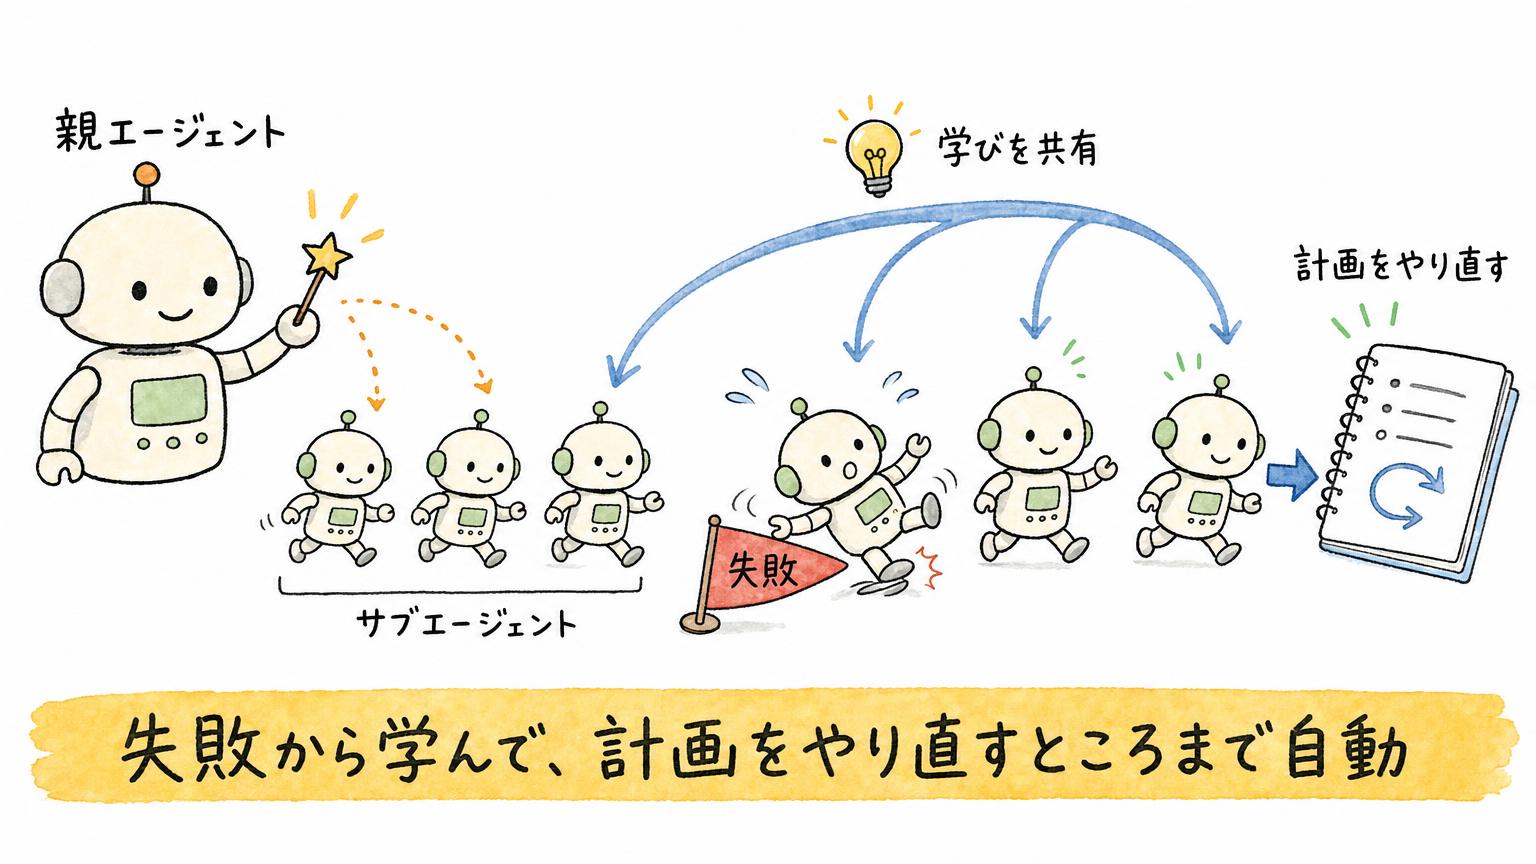
尾原:任せられるようになってきた、という話でもあります。半年ぐらい前は、ロングホライゾンで、ハーネスそのものを自分でがちがちに設計しなくても、長時間、AIエージェントが勝手にマルチエージェント、サブエージェントに分割して、実行し切ってくれる、という段階でした。
それが当たり前になりました。長時間実行する、ということは、それだけ大型の成果物を、きちんと検証しているのか、という話になります。その検証も、AIで自動でやりますよね、と。最近のフロンティアモデルの傾向は、そこです。
今回は、さらに、失敗ケースにぶつかったときの動きが、変わりました。これまでは、こちらがメモリに残していました。「この失敗にぶつかったことを記憶して、他のサブエージェントが学んで、同じ失敗をしないでね」という設計を、こちらでしなければいけなかった。
いろいろな事例を読むと、それを、勝手にやってくれるようになっています。エージェントが、エージェントを生成して、失敗から学ぶ。もう一回、プランニングをやり直す。そこまでやってくれます。ますます、皆さんは、最後までやり切りたいことを、ちゃんと言い切る必要があります。
いけとも:なるほど。面白い。こんなにAIが進化している中で、我々人間がどうするか、という本が『システムゼロ』です。いま、書店で、入口のど真ん中に、ドカンと置いてもらっています。何百冊と棚に並べてもらっていて、非常に好評です。
尾原:おかげさまで、入口の真ん中に、置いていただきました。
AIが勝手に補った仕様と、その「前提条件」の聞き出し方
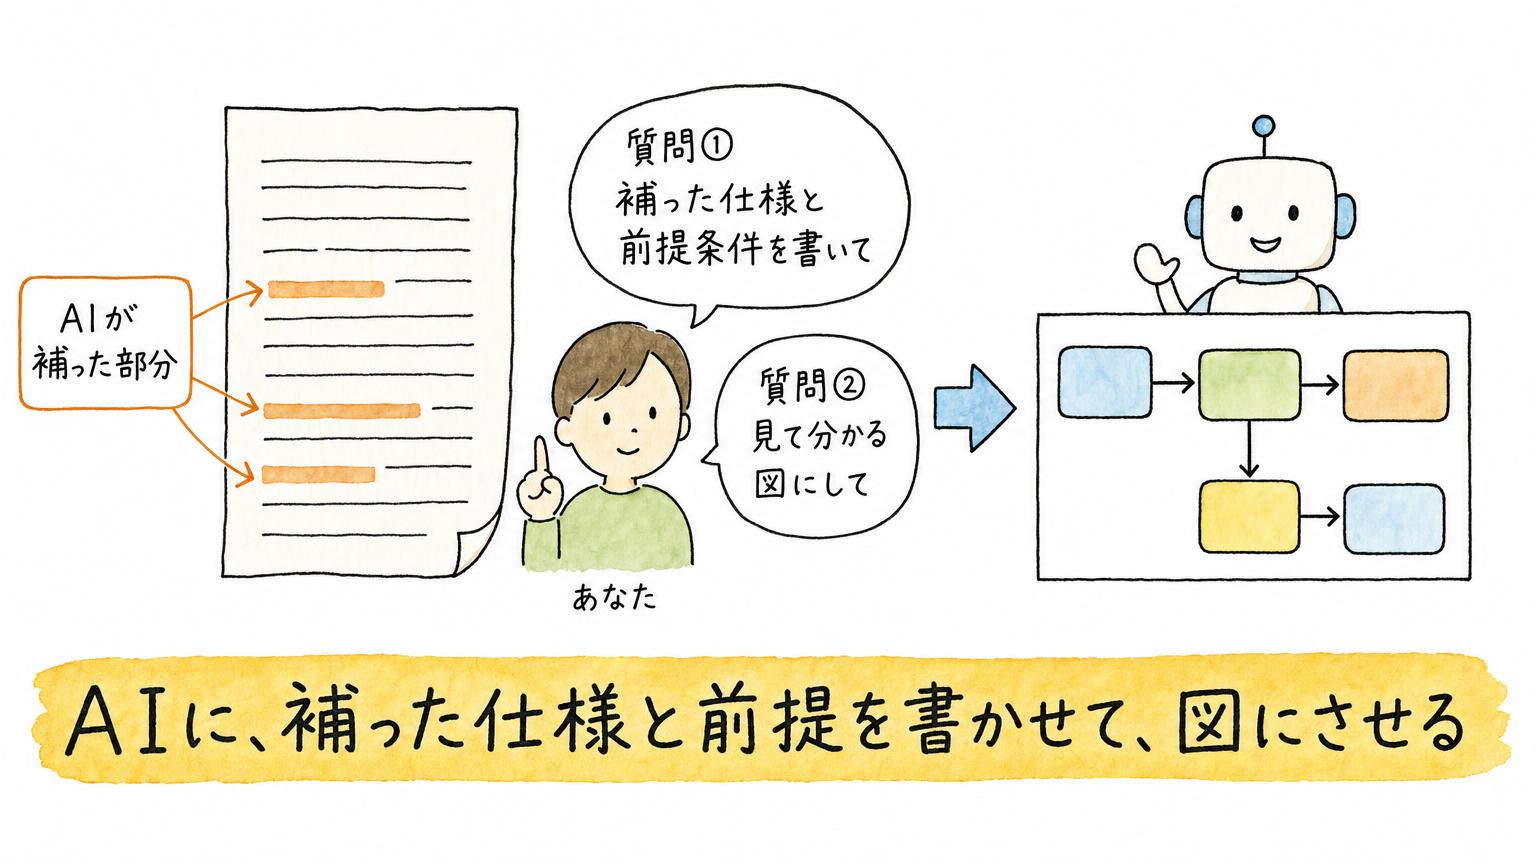
尾原:まさに、『システムゼロ』的な文脈です。これも、おそらく改善されると思います。でっかい仕事を、任せられるようになってきました。ここ半年ぐらいで、自分がやりたいことを、AIの方から質問してくれたり、勝手に推測して、仕様書のようなものを補ってくれたりします。
逆に言えば、出てきたアウトプットが、勝手にAIが切り回して、「そこまでつくらなくてもいいんだけど」というものを、つくってくることが増えてきました。だから、『システムゼロ』に書いた、「自分で考える」という姿勢も大事です。それに加えて、AIに、明確に聞くことが効きます。
聞くことは、2つあります。
1つめは、「あなたが気を回して、勝手に補った仕様は、何ですか。補うときに、何を前提条件だと思って、補ったんですか」と聞くことです。それを、精密に書いてもらう。
2つめは、その精密に書いた、AIが勝手に補ったものが、視覚的に分かりやすいように、ビジュアル化してください、とお願いすることです。
この仕様書が、めちゃくちゃ大きく出てくると、読んでも分かりにくいんです。だから、「何を補ったのか」を精密に書いてもらう。そして、直感的に理解しやすいように、ビジュアル化してもらう。この2つは、放っておいても、そうなると思います。ただ、ロングホライゾンでAIに任せるのは当たり前。AIサブエージェントの設計すら、AIに任せるのは当たり前。そういう時代の、大事な秘訣かなと思います。
いけとも:確かに。ありがとうございます。皆さん、ぜひ『システムゼロ』を買って、読んでいただけると、幸いです。
尾原:ちょっと本当に心配なのは、深読みしすぎて、このレベルで話していいのかな、ということです。テーマによって、深読みのレベルを変えながら、お話ししていければと思います。難しすぎます、という声や、こういうマニアックな話を待っていました、というコメントを、皆さんからいただければ、うれしいです。
もう1つ、大事なことがあります。『システムゼロ』を、ぜひ読んでいただいたら、Amazonにレビューを書いていただく。SNSに、ポストしていただく。そこまでやって、エンドツーエンドでございます。次に、皆さんが、ループを回していくよう、よろしくお願いします。
いけとも:ありがとうございました。また、お会いしましょう。
よくある質問(FAQ)
Q1. Remote Labor Indexは何を測るベンチマークですか?
リモートワークの依頼を人間に出したと想定し、納品物を依頼主が受け入れられるかを測るテストです。依頼は約240件で、製品デザイン、建築、広告、動画づくりなどが含まれます。Fable 5.1やGPT-6 Astraは約2割でしたが、Fable 5.2は約4割でした。
Q2. AIに7時間丸投げすると、どこまでできますか?
今回の例では、4つの資料とデモデータをつくり、実際の画面で動かして、その画面を資料に反映するところまで任せました。使ったエージェントは約80体、消費したトークンは約4億トークンで、出来は90点くらいでした。確認は大変なので、細かく分けたほうがやりやすい面もあります。
Q3. ロングデコードとは何ですか?
Gemini 4 CarbonのAPIが対応した、長い出力をつなげて出す機能です。入力と思考と出力を合わせて約100万トークンの範囲で、出力を途中で切らずにつなげられます。これまでの出力の上限は約6万5000トークンでした。キャッシュに当たらないとコストが大きくなる点には注意が必要です。
ポッドキャストできく:https://open.spotify.com/episode/77M4oMODFk5x0CZ1qAl4xO
新著(11/10発売)『システムゼロ――「AIがすべて先回りする」時代の思考法』:https://link.amazon/B0h56HiRH
新著(7/27発売)『Claude 最強のAI自動化術』:https://amzn.to/4eTUVG1
YouTube『いけともch』:https://www.youtube.com/@iketomo-ch
Podcast『いけとも尾原DeepなAIニュース』:https://open.spotify.com/show/3hGAbKZI5oo9PsbFI1IxTr
■合わせて読みたい
■関連記事
人気記事RANKING
-

ClaudeでAdobe・Canva・Notionを直接編集:インタラクティブコネクタ3つの実例と使える4条件
-

ChatGPTプロジェクトメモリ機能の使い方と設定方法
-

Suno V5とSuno Studio完全ガイド:プレミアム限定の革新的音楽編集機能を徹底解説
-

PixVerseの料金プラン完全解説|クレジットの仕組みと他AIツールとの比較まとめ
-

OpenAI Realtime APIとMCP連携で実現する音声エージェント革命
カテゴリー
- 主要AIサービス (114)
- 画像生成AI (87)
- 動画生成AI (114)
- 音楽・音声生成AI (28)
- AI開発・効率化ツール (153)
- AIのビジネス活用 (201)
- 教育×AI (19)
- AIの知識&トレンド (244)
- いけともサブチャンネル (420)
- AIエージェント時代の働き方 (1)
タグ
Agent V3
AI字幕
AI字幕ツール
Alibaba
Amazon Seller Assistant
Amazon Seller Central
AP2
ATOS
ByteDance
CAG
Cognition AI
Comscore
cotomi Act
DAW
DevOps
Gemini Advanced
GUGA
HeyGen
HunyuanImage
HunyuanImage-2.1
IndexTTS2
JR東日本
NEC
OpenAI Platform
Oracle
Perplexity Search API
Qwen3-Next
Replit
SeeDream
SongBloom
Stargateプロジェクト
Suno Studio
Thinking Machines
インコンテキストラーニング
カスハラ
コネクタ
ステム分離
ソフトバンクグループ
データセンター
パナソニックコネクト
事故対応
動画解析AI
暗黙知
決定論性
鉄道運行管理
公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ