Gemini 3.8 Live・Extended Thinkingとは?Googleの音声AIが裏で作業する仕組み
- Googleが2026年9月15日、音声AIの新モデル2つ「Gemini 3.8 Live」と「Extended Thinking」を発表しました。
- 会話を続けながらツールを裏で動かし、待ち時間を発話で埋めつつ作業をやり切ります。
- 評価は首位圏でも他社と僅差で、日本での提供時期や日本語対応は発表文から分かりません。
電話で問い合わせをしたとき、「確認しますので少々お待ちください」のあとに、何十秒も無音が続いた経験はありませんか。通話が切れたのかと不安になって、思わず「もしもし?」と声をかけたくなります。
音声のAIも、長いあいだ同じ壁にぶつかってきました。9月15日にGoogleが発表した2つの新モデルは、この無音の時間を「話しながら裏で作業する」ことで埋めにきています。
この記事では、2つのモデルの違いと仕組み、そして企業が導入前に見ておきたい3点を順に見ていきます。
目次
発表されたのは「2つのモデル」です
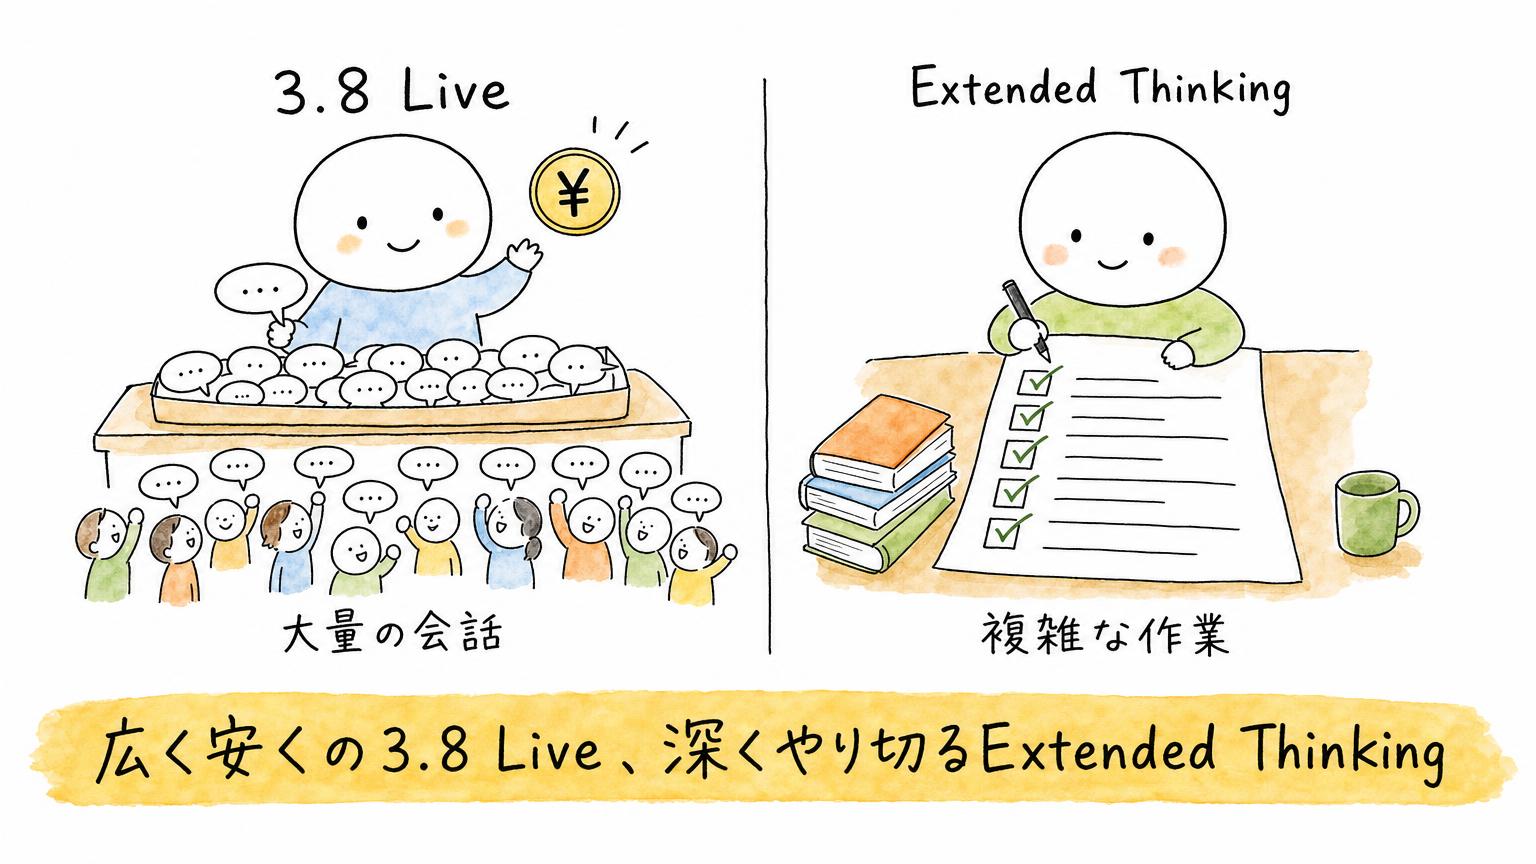
2026年9月15日、Googleは音声での会話に特化した新モデルを2つ発表しました。Gemini 3.8 LiveとGemini 3.8 Live Extended Thinkingです。
役割は分かれています。3.8 Liveは、大規模に使うことと費用の効率を重視したモデルで、会話の流れと視覚情報の理解を両立させます。Extended Thinkingは、複雑な作業向けに、推論力を高めたモデルです。
提供先も、発表日から順次、次のように分かれています。
- 開発者向け:どちらもGemini APIとGoogle AI Studio
- 企業向け:どちらもGemini Enterpriseのプライベートプレビュー(限られた企業への試験提供)
- 一般向け:3.8 LiveはSearch Live、Extended ThinkingはGemini Live
- Workspace向け:Extended ThinkingがDocs(Google AI ProとUltraの契約者)とGmail・Keep(すべてのGoogle AI契約者)。ビジネス顧客向けは「近日対応」
日本での提供時期や対応状況は、発表文には書かれていません。
3.8 Liveは「広く、安く」、Extended Thinkingは「深く、やり切る」。まずはこの役割分担を押さえておくと、次の話が読みやすくなります。
2つのモデルは「測っている軸」が違います
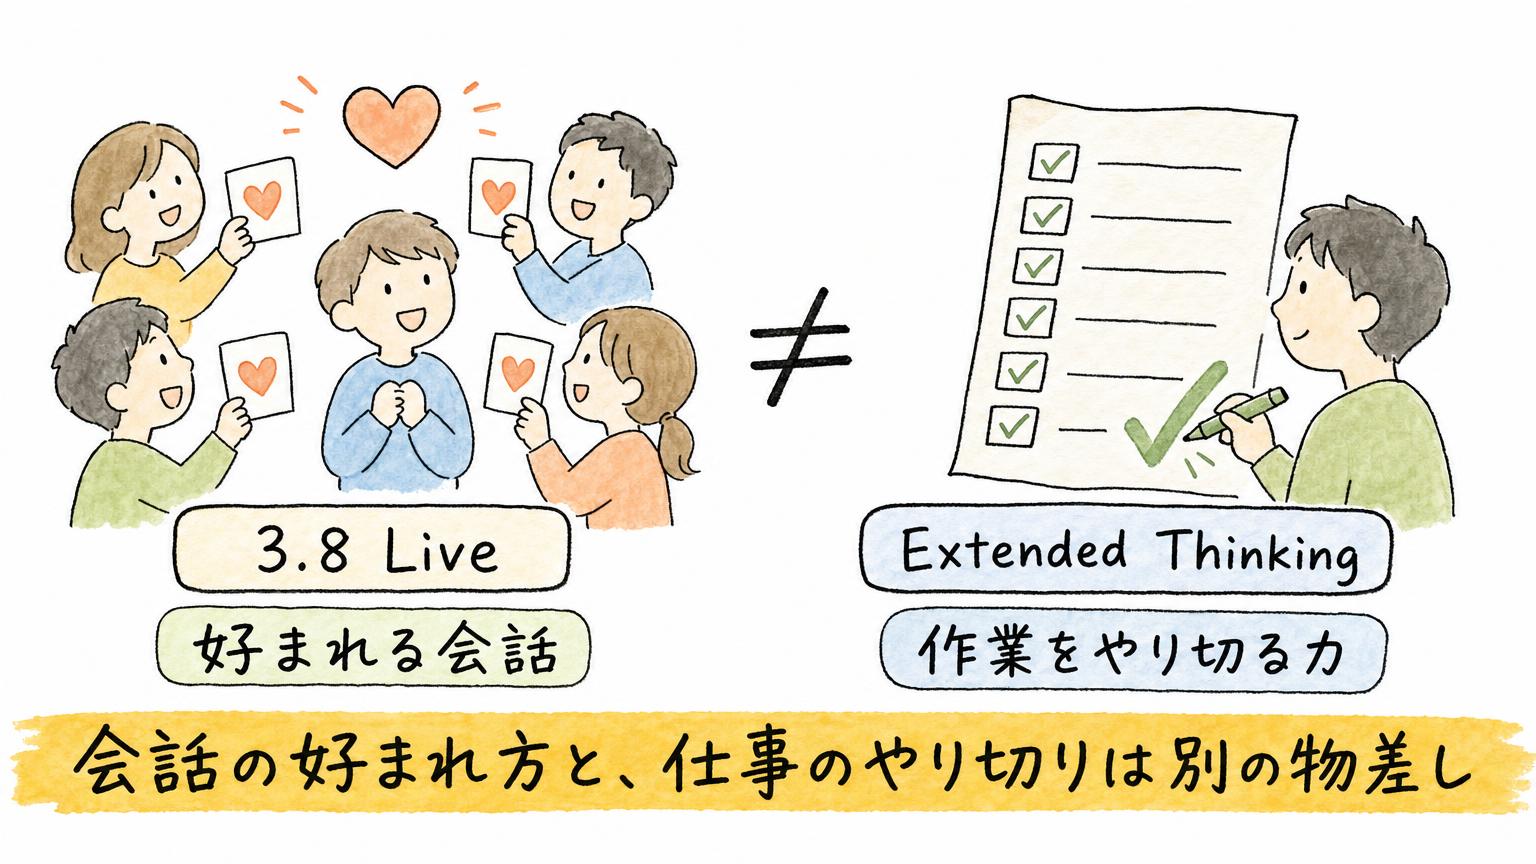
Googleが示した数字は、モデルごとに軸が違います。3.8 Liveは「Speech Agent Arena」で2位で、利用者から好まれているとGoogleは説明しています。好みが軸なので、会話の心地よさに近い評価です。
Extended Thinkingは、作業のやり切りを測る指標で名前が挙がっています。Artificial Analysisの音声モデル総合指数(Googleは「Speech to Speech Quality Index」と表記)で、82.6の総合1位です。
エージェントとしての作業完了率を測る「τ-Voice」では68.6%でした。これはArtificial Analysisが自社の実装で測った値です。Sierraの「τ-Voice-banking」では35.1%、音声からの推論力を見る「Big Bench Audio」では97.7%です。
同じ表で2位のOpenAI「GPT-Live-1」は67.9%で、差は0.7ポイントしかありません。総合指数も、2位は81.5で、差は1.1ポイントです。一方で、前の世代のGemini 3.1 Flash Liveは37.7%でした。そこからは、ほぼ倍になっています。
作者であるSierra自身の公式ボードでは、GPT-Live-1が81.7%と出ています。測る条件が違うので、単純には並べられません。テキスト版の上位が約85%なので、音声はそこへ近づいてきた段階です。
測っているのは「話し方」ではなく「やり切る力」です。僕の読みでは、首位圏には入っていますが、他を突き放した水準とまでは言えません。名前のとおり銀行の顧客対応を題材にした評価だとすれば、首位とされる数字でも35.1%です。何もかも任せられる水準ではなく、複雑な手続きほど、まだ人の目が要りそうです。
これらの数字は、Googleが発表で示したものです。評価条件や比べたモデルの設定は、発表からは分かりません。
「話しながら裏で作業する」仕組み
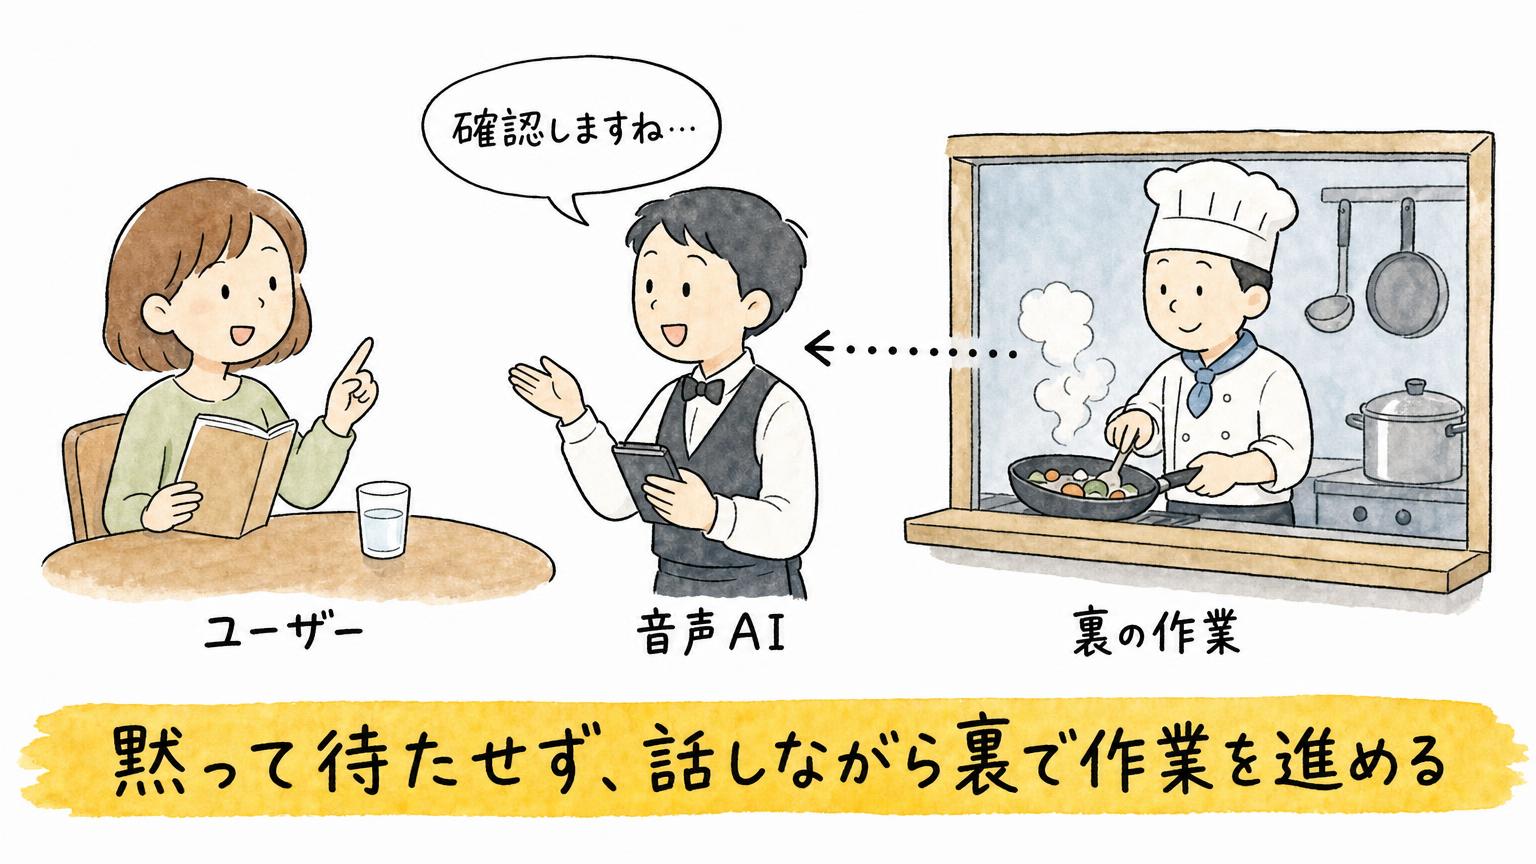
3.8 Liveは、ツールやAPIの呼び出しを、会話を続けながら裏で実行できます。依頼を受けたら、まず短く応じます。その間に、実際の処理が別の流れで進みます。
Extended Thinkingは、さらに一歩進んでいます。推論と発話を同時に行い、依頼を受けた直後に「確認しますね…」と一言返して、最初の間をつなぎます。複数の手順が進むあいだは、その進み具合を声で実況します。
飲食店にたとえると、厨房で調理を進めながら、客席には「いま焼いています」と声をかける店員です。先出しの一言と実況が客席への声かけにあたり、ツールの実行と推論が厨房の調理にあたります。客は無言で待たされず、店員は調理を止めません。
画面のあるテキスト型のAIなら、「実行中」の表示を出すだけで待ってもらえます。音声には画面がありません。沈黙を「発話」で埋めるしかないところに、この設計の理由があります。
想定より処理が長引いたときの挙動や、具体的な遅延の数値は、発表からは分かりません。
待ち時間を減らすもう一つの道が、AIそのものを速くする方向です。
▶︎ あわせて読みたい:「賢いAI」の次は「速いAI」——待ち時間が事業になる高速推論の市場
3.8 Liveに加わった3つの能力
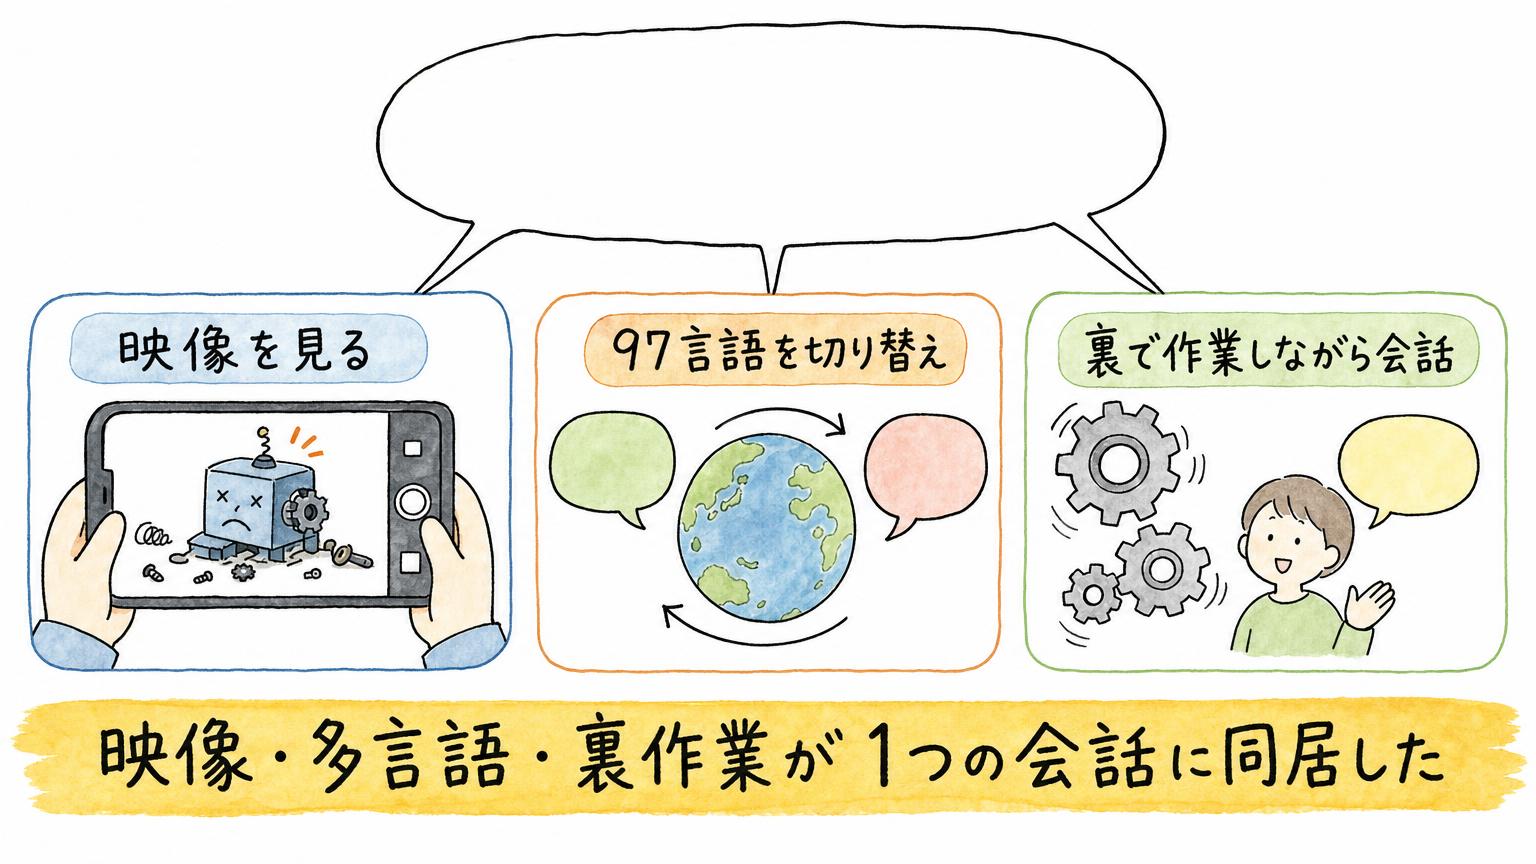
3.8 Liveの説明には、会話そのものの進化として、次の3つが挙がっています。
- 映像などの視覚入力を、ほぼリアルタイムで処理する
- 97言語を、会話の途中で自動検出して切り替える
- ツールとAPIの呼び出しを、会話を続けながら裏で実行する
1つ目は、カメラに映したものを会話の材料にできる、ということです。たとえば故障した機器を映しながら「これ、どう直せばいい?」と聞けば、機種名を言わなくても状況を踏まえた答えが返ってくる、という使い方が考えられます。
2つ目は、話す言語を途中で変えても、設定し直さずに会話が続くということです。3つ目は前の章の仕組みそのものです。
映像・多言語・裏作業が、1つの会話に同居した。それが今回の変化です。多言語の窓口を1つにまとめられるかもしれません。実務での安定性や、97言語に日本語がどこまで含まれるかは、発表からは分かりません。
▶︎ あわせて読みたい:同じ週のGoogle発表——資料を音声で「対話」して理解するGemini Notebook
競争の軸は「自然さ」から「仕事の完遂」へ
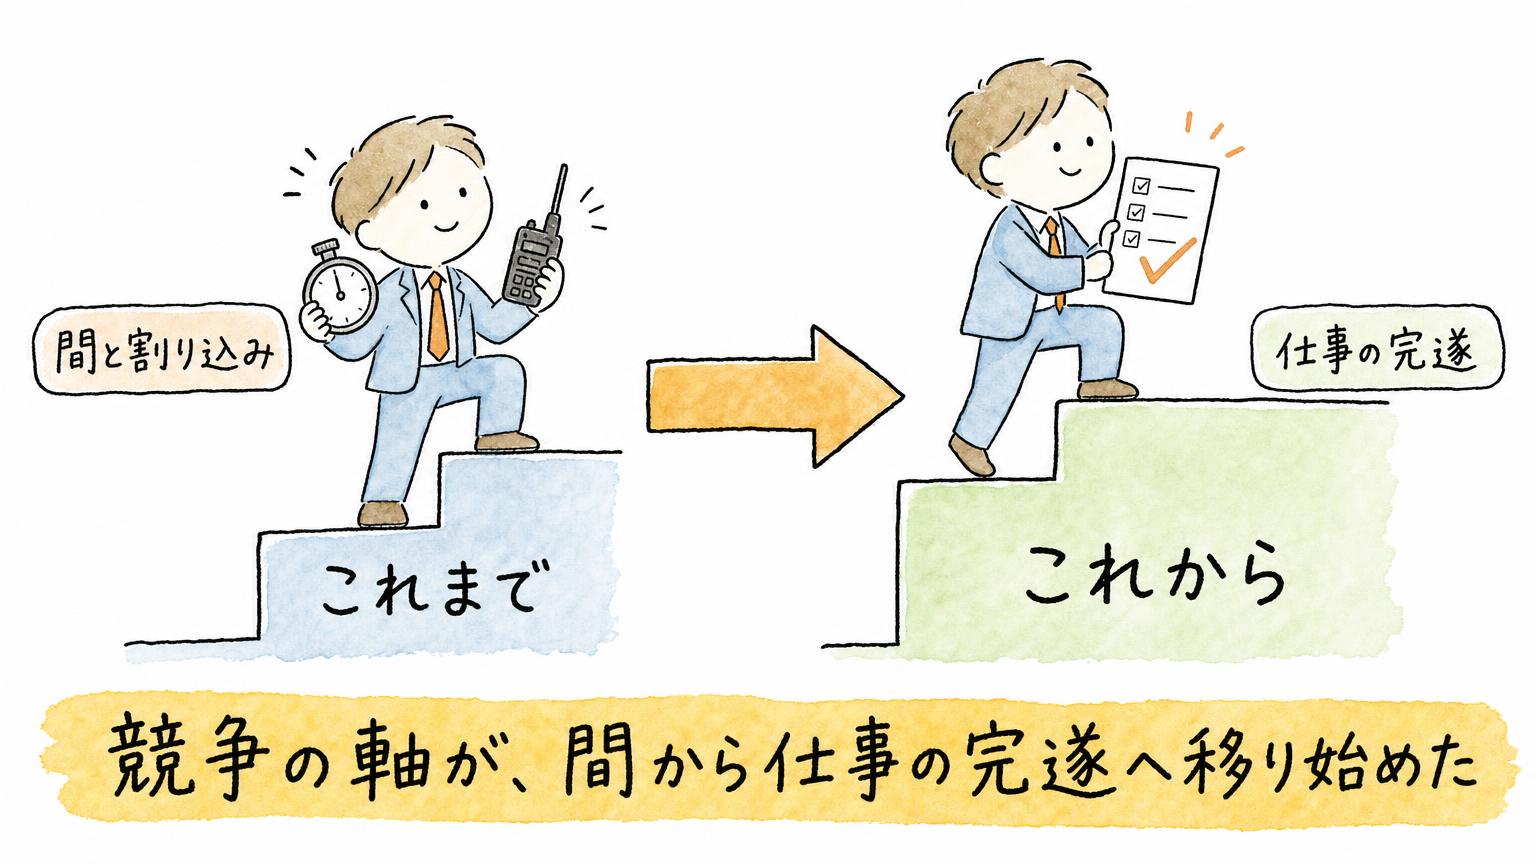
音声AIの競争は、長いあいだ「間」と「割り込み」が焦点でした。2026年7月には、OpenAIの音声モデル「GPT Live」が登場し、話の途中で割り込んでも会話が途切れにくくなりました。
今回のExtended Thinkingは、待たせないだけではありません。待たせている間に、仕事を進めます。
個々の要素は、他社も早くから進めています。OpenAIは2025年8月に、音声のAPIでもMCPと画像入力に対応しました。違いは、それらを1つのモデルにまとめ、業務向けの評価で示した点にあります。
ServiceNowが作った音声エージェント評価「EVA-Bench」は、作業の正確さと会話の体験を両方見る評価です。Googleは、複雑な業務の流れで、その両立の限界線(Pareto Frontier)を押し広げたと説明しています。
限界線とは、片方を犠牲にせずに達成できる最良の組み合わせの境目のことです。
同じ条件での他社との比較データは、発表にはありません。優劣はここでは判断しません。競争の軸が「間」から「完遂」へ移り始めた、と読むのが今回のニュースの要点です。
企業が今見る3点と、明日できること
企業向けの提供は、まだプライベートプレビューです。開発者向けには、LangChain、LiveKit、Vercelなどの基盤が、Gemini Live APIを使った音声サービスの開発を支えていると挙げられています。
Googleは、Salesforce、Genspark、Lumerisなどの企業と提携していて、遅延の小ささ、会話のなめらかさ、ツール呼び出しの力に期待が寄せられていると紹介しています。
Googleは、自社のAI製品が生成する音声すべてに、SynthIDという透かしを入れています。AIが作った音声だと後から判別できるようにするための仕組みです。
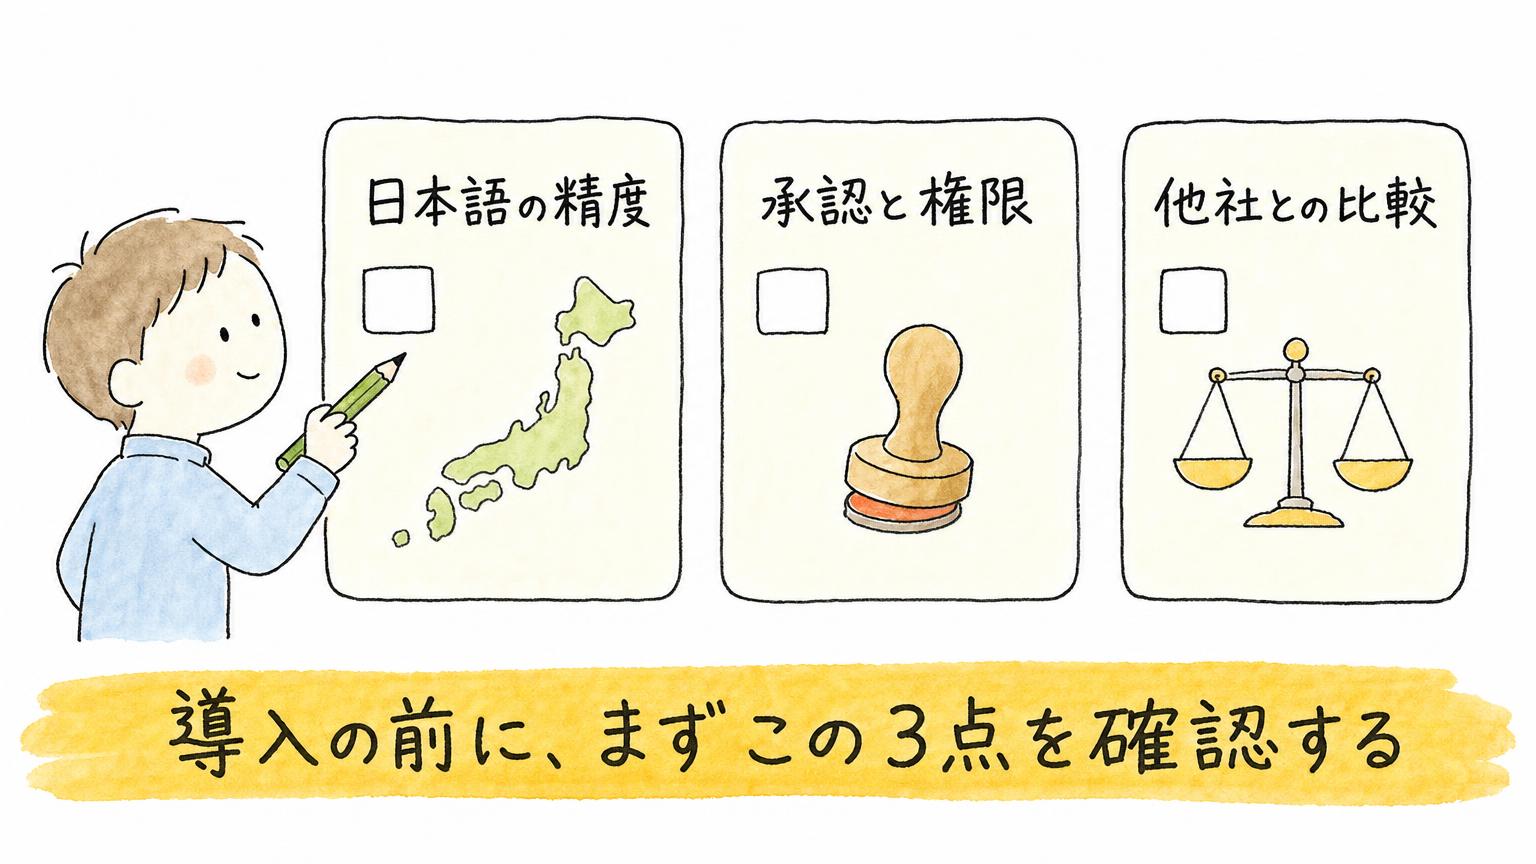
導入を考えるなら、次の3点を見ておくのがよさそうです。
- 日本語での実用精度と、提供時期
- 承認と権限を、誰がどう設計するか
- 評価条件の公開と、他社との同じ条件での比較
2つ目の承認と権限は、要注意です。今回の発表文には、承認や権限の設計についての記述はありません。裏で動く作業をどこまで自動で進めさせるかは、導入する側が決める部分になります。
▶︎ あわせて読みたい:承認・権限の分離・監視まで——「AI社員に仕事を渡す」ときの設計(GPT-6 Astra)
明日からできることは、次の2つです。
- 自社の電話や問い合わせ窓口の操作を、「調べるだけのもの」と「取り消せないもの(送金、契約変更など)」に分けてみる
- 自分のGeminiアプリで音声の会話を試し、待たせる作業の途中で、一言や実況がどう入るかを観察する
日本で使えるかどうかは発表文から分からないので、まずは手元で確認してください。音声AIに任せる範囲は、「取り消せるか」で先に決めておく。これが、導入の最初の一歩になります。
よくある質問(FAQ)
Q1. Gemini 3.8 LiveとExtended Thinkingは何が違いますか?
3.8 Liveは、大規模に使うことと費用の効率を重視したモデルで、会話の流れと視覚情報の理解を両立させます。Extended Thinkingは、複雑な作業向けに推論力を高めたモデルです。推論と発話を同時に行い、依頼の直後に一言返して、複数の手順が進むあいだは進み具合を声で実況します。
Q2. 「話しながら裏で作業する」とは、どういう仕組みですか?
3.8 Liveは、ツールやAPIの呼び出しを、会話を続けながら裏で実行できます。依頼を受けたらまず短く応じ、その間に実際の処理が別の流れで進みます。音声には画面がなく「実行中」の表示を出せないので、沈黙を発話で埋める設計です。処理が長引いたときの挙動や具体的な遅延の数値は、発表からは分かりません。
Q3. 日本で使えますか?企業は導入前に何を確認すべきですか?
日本での提供時期や対応状況は、発表文には書かれていません。企業向けは、Gemini Enterpriseのプライベートプレビュー(限られた企業への試験提供)の段階です。導入前に見ておきたいのは、日本語での実用精度と提供時期、承認と権限の設計、評価条件の公開と他社との同じ条件での比較の3点です。
Google AI Studioを使って、自分専用の業務ツールを実際に作ってみたい方は、いけともハンズオンのアーカイブをご覧ください:https://handson.workstyle-evolution.co.jp/
最新のAIニュースを継続的に追うなら、YouTube『いけともch』もあわせてどうぞ:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事
公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ