
Claude Opus 5.5の料金と性能:入力4ドル・コスト4割減でFable級
Claude Opus 5.5の料金と性能:入力4ドル・コスト4割減でFable級
- AnthropicのClaude Opus 5.5は、多くの作業で上位モデルのFable 5.1並みの性能を出します。
- 運用コストはOpus 5より4割安く、68万行のコード移行を1日未満で終えた事例もあります。
- 数字は自社評価と早期利用企業の報告で、高リスク領域の作業は別モデルへ振り分けられます。
AIエージェントに、本当は大きな仕事を任せたい。でも費用がいくらになるか読めないし、途中で何をするかも心配で、結局は小さな作業だけを渡していませんか。
Anthropicが発表した「Claude Opus 5.5」は、その2つのブレーキに同時に手を入れてきました。
性能は多くの作業で上位モデルのFable 5.1並み。運用コストは前モデルのOpus 5より4割安く、安全性の社内評価は過去最高です。何が変わり、なぜ両立できたのかを整理します。
目次
Opus 5.5は「安全対策に歩調を合わせる」方針後の最初のモデル
AnthropicはOpus 5.5を、新しい「Claude 5.5」ファミリーの最初のモデルと位置づけています。多くの作業でFable 5.1と同じ水準の性能を出し、運用コストはOpus 5より40%安く、出力も30%以上速くなりました。
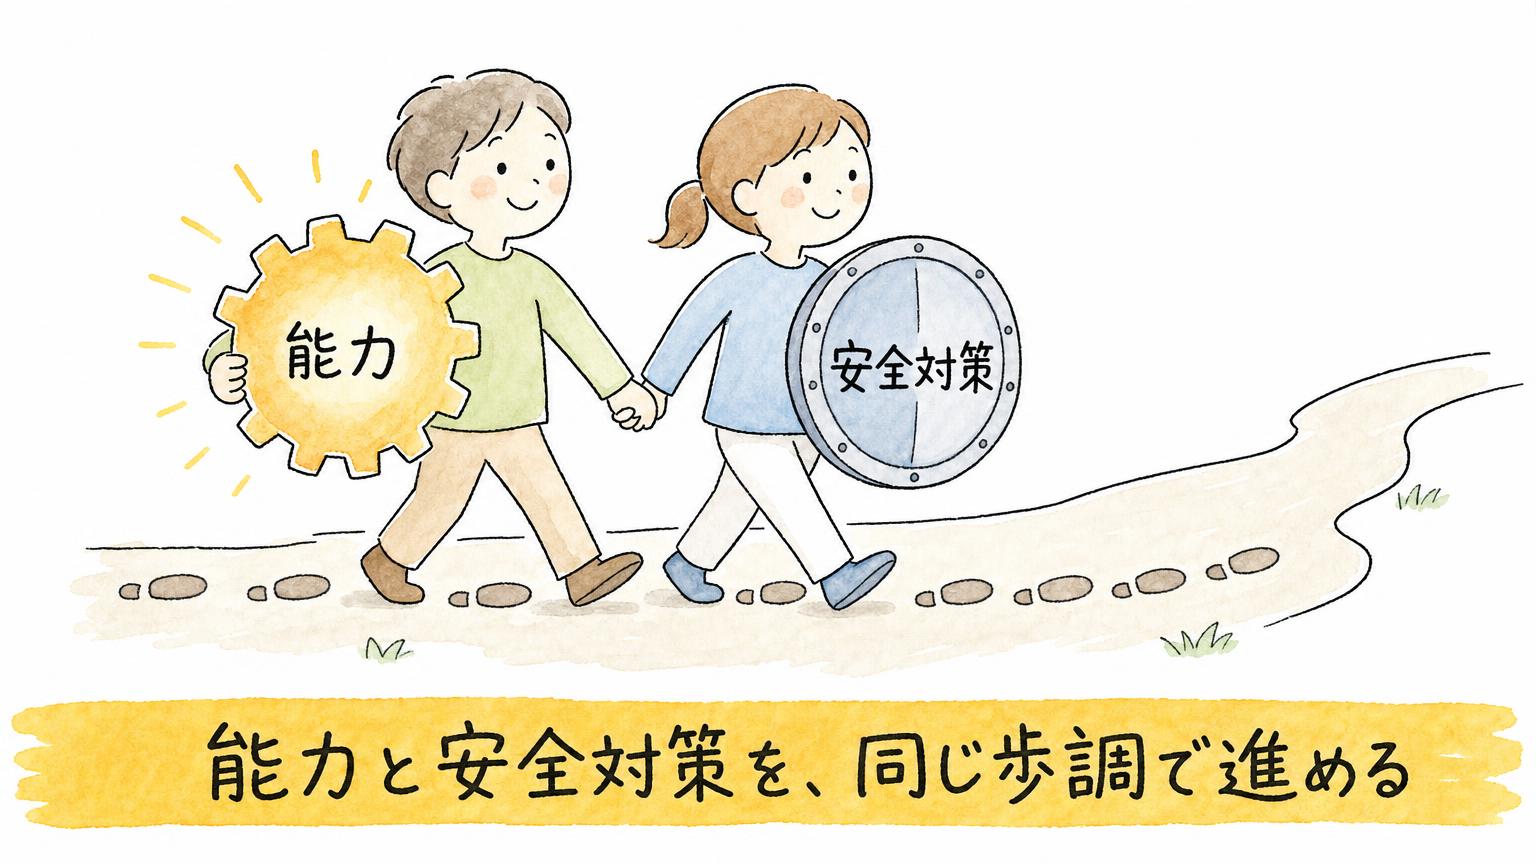
発表のタイミングにも意味があります。前の週に、CEOのダリオ・アモデイ氏がエッセイで「AIの進歩は、安全対策が能力の先を行き続けるように歩調を合わせるべきだ(pacing the frontier)」と主張しました。Opus 5.5は、その方針を掲げてから最初のリリースです。
Anthropicはもともと、大きなリスクへの備えを自主的な枠組み(Responsible Scaling Policy)として公開してきた会社です。今回も公開前に、METRやFrontier Designといった外部の評価機関のテストを経ています。
一気に性能を跳ね上げるより、「同じ水準をより安く、より安全に出す」ことに重心を置いた一手と読めます。
使える場所は、AWS・Google Cloud・Microsoft Azureを含む全プラットフォームです。あわせて、Pro・Max・Team・席単位のEnterpriseプランでは5時間あたりの利用上限が引き上げられました。Sonnet 5.5とHaiku 5.5も数週間以内に続く予定です。
なお、この記事で扱う数字は、Anthropic自身の評価と早期利用企業の報告によるものです。第三者による独立した検証は、発表時点では示されていません。
数週間かかる仕事が1日で終わる
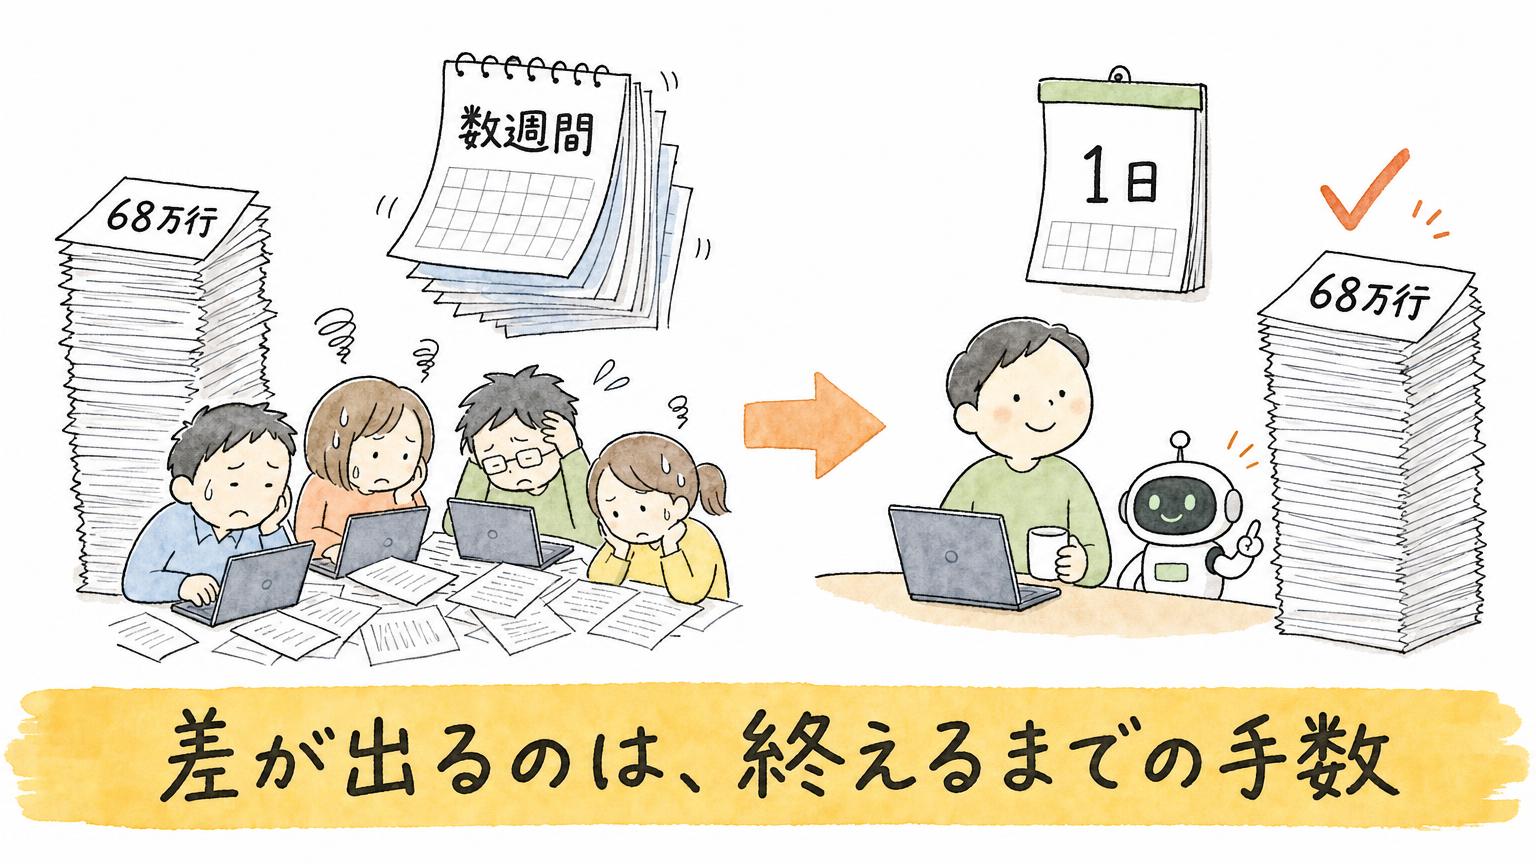
いちばん象徴的なのは、コード移行の事例です。Anthropicの発表によると、ある早期テスターは、68万行のコード移行を1日かからずに終えました。Anthropicによれば、エンジニアのチームなら数週間かかる作業です。
別のテスターは、20万行のコードベースの監査と修正を3時間未満で終えました。Opus 5では20時間以上かかり、使ったトークンも2.5倍だったといいます。
社内のテストでも差が出ています。Webアプリの全ページの読み込みを速くする課題では、Opus 5.5は40回中39回成功しました。Opus 5は小さな改善にとどまり、そのうえアプリの動き自体を変えてしまったそうです。
現役の上位モデルとも比べています。ネットワークの負荷分散ソフト「HAProxy」をC言語からRustへ書き換える課題で、Opus 5.5とFable 5.1はどちらも回帰テスト(既存の機能が壊れていないかの確認)をほぼ全て通しました。そのうえで、Opus 5.5は9.5時間(Fable 5.1は12時間)で終え、コストは51%低く済んでいます。
コードの外でも同じ傾向です。架空のHR(人事)ソフト会社2社の合併案を分析させ、Excelで財務モデルを組み、経営陣向けの資料にまとめる課題では、どちらのモデルも同じ結論に達しました。Opus 5.5は63分(Opus 5は93分)で終え、コストは半分でした。
差が出ているのは「できるか」より「どれだけ少ない手数で終えるか」です。これまで人手や費用の面で現実的でなかった規模の仕事が、試せる範囲に入ってきたと言えます。
コスト4割減は「単価×使う量」の掛け算
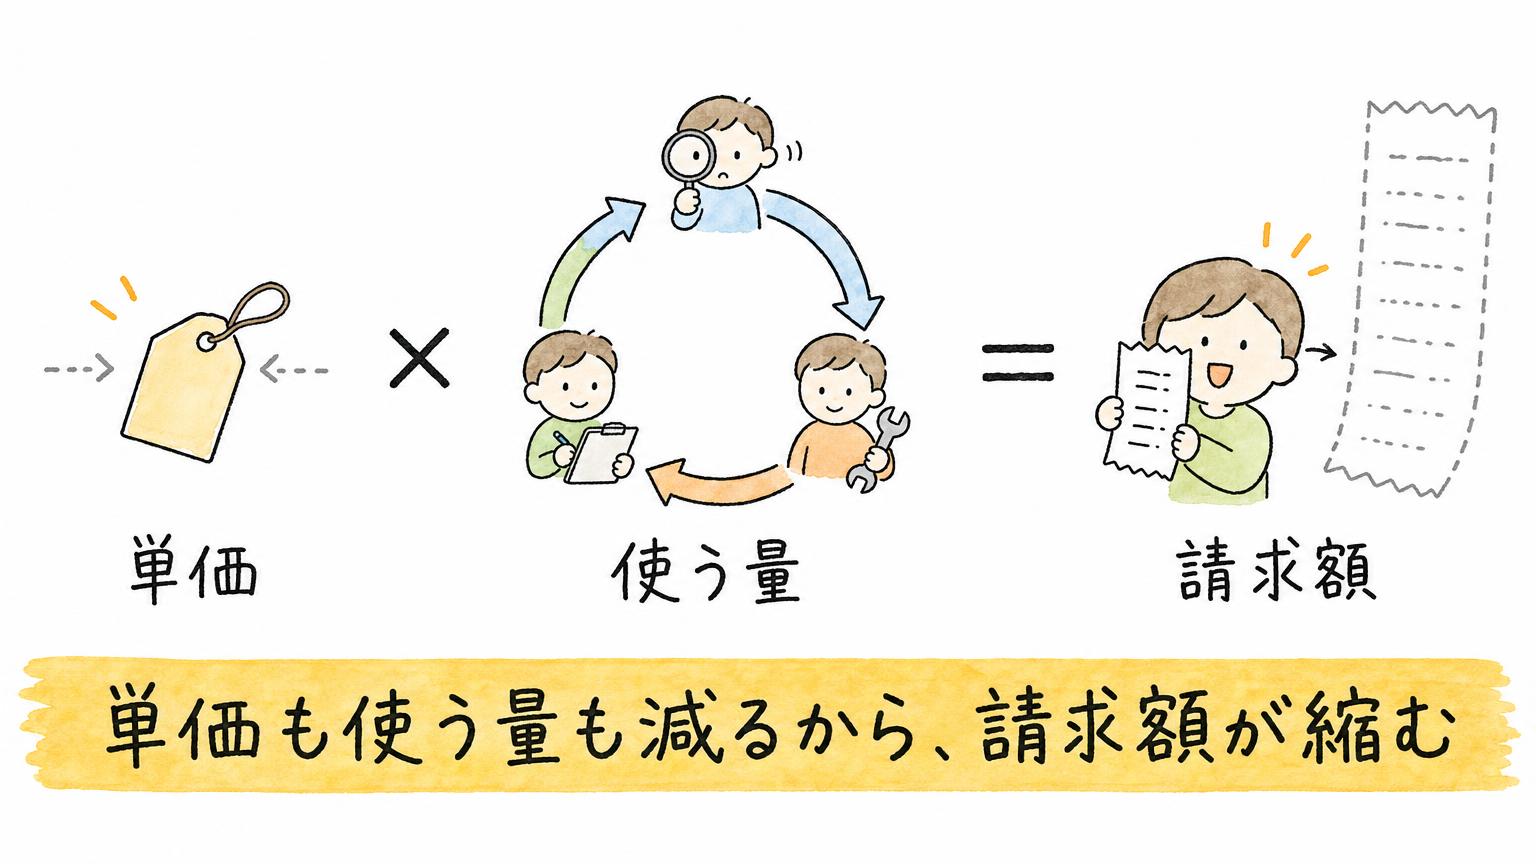
値下げの中身は2つの層に分かれます。1つめは、1トークンあたりの単価そのものが下がったことです。
100万トークンあたりの価格は、入力4ドル・出力20ドル。Opus 5(入力5ドル・出力25ドル)より20%安くなりました。
大きいのは、キャッシュ読み込み(前回と同じ部分の処理結果を使い回す仕組み)です。0.50ドルから0.20ドルへ、キャッシュ読み込みは60%安くなりました。Anthropicは、キャッシュ読み込みがエージェント作業やコーディングのコストの大半を占めると説明しています。
2つめは、同じ作業を終えるのに必要なトークンの量が減ったことです。GitHubは、VS Code上でOpus 5.5がOpus 5より多くのターミナル作業を、半分未満の手順で解いたと報告しています。
Deloitte Consultingの報告も同じ方向です。最も軽い設定のOpus 5.5が、既知のバグの72%を見つけました。Opus 5は高い設定でも56%で、Opus 5.5は誤検知も少なく、出力の量もごく一部で済んだといいます。
エージェントの仕事は「試す→確かめる→直す」の繰り返しです。一度で正解に近づければ、この周回そのものが減り、読み直す文脈(キャッシュ読み込み)も新しい出力も、まとめて縮みます。
単価が2割下がり、使う量も減る。その掛け算で4割減になっている、というのがAnthropicの説明です。
競合との差は、スコアよりコストに出る
同じ時期のOpenAIのモデルとも比べています。44職種の実務を模した評価「GDPval-AA v2.1」では、Opus 5.5が1846点でした。Fable 5.1は1735点、GPT-6 Astraは1542点です。
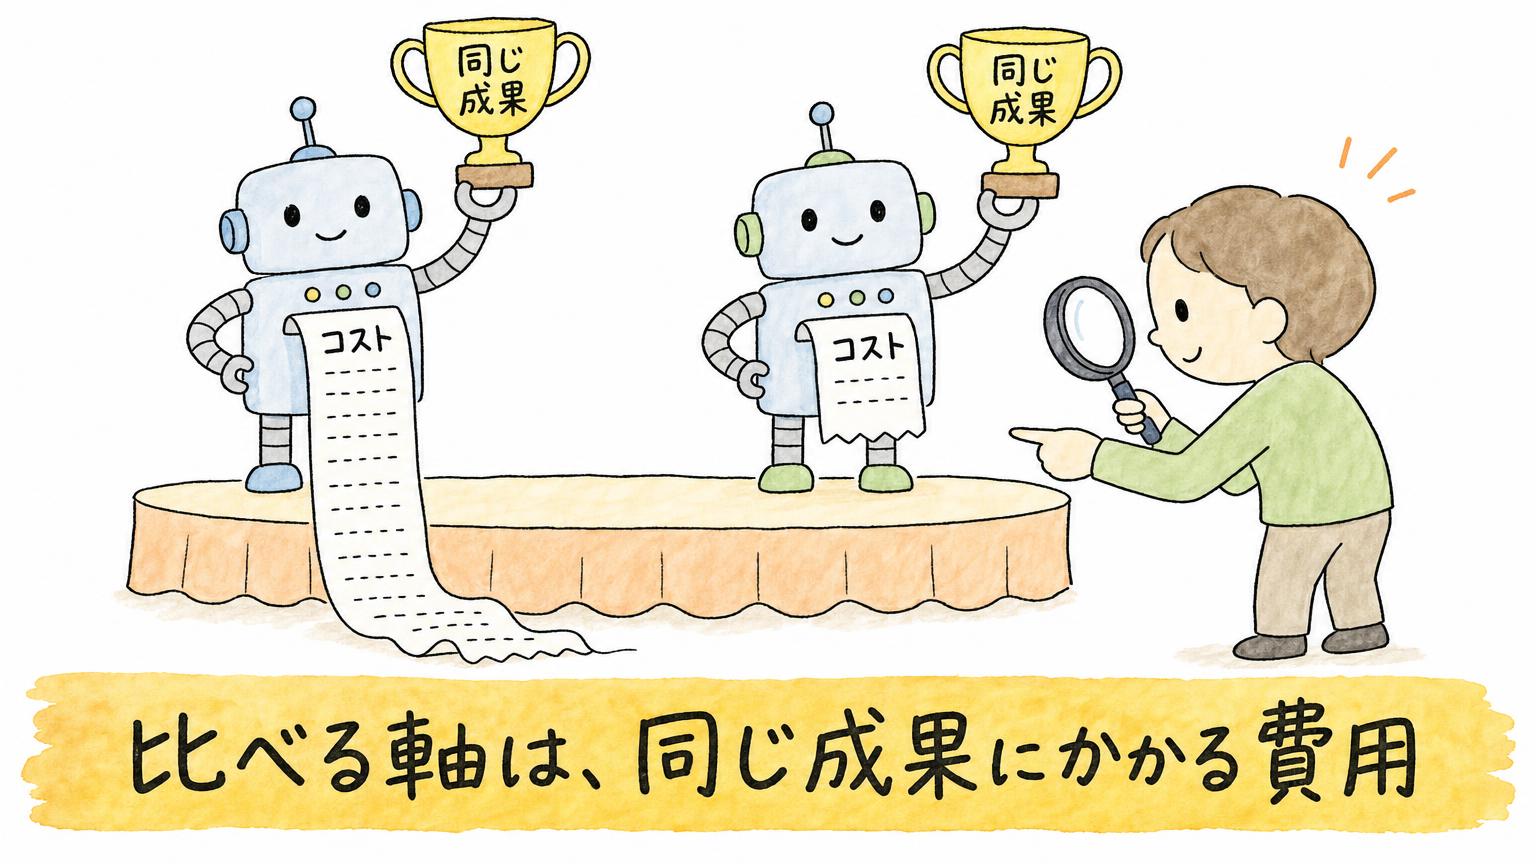
目を引くのはコストです。Anthropicの発表によれば、標準設定(medium)のOpus 5.5が、最大設定のGPT-6 Astraを上回り、しかもタスクあたりのコストは約5分の1でした。
コマンドライン上での複雑な作業を測る「Terminal-Bench 4.0」では、標準設定のOpus 5.5がGPT-6 Astraと同じ水準の成績を、約40%のコストで出しています。開発ツールCursorの評価では、GPT-5.6 Solを11ポイント上回り、コストは約3分の1でした。
一方で、すべてで勝っているわけではありません。科学研究のエージェント作業を測る評価では、GPT-6 Astraの64.6%が、Opus 5.5の58.7%を上回りました。なお、安全対策が働いた課題は別のモデルが代わりに解いているため、Opus 5.5のスコアは実力より低く出ている可能性があるとAnthropicは注記しています。
Anthropic自身も、この能力の水準になると、ベンチマークの差は実際の違いを測る物差しとして当てにならなくなってきたと書いています。社内で使った実感では、Fable 5.1との差はスコアが示すより小さいそうです。
比べる軸は「何点か」から「同じ成果をいくらで出せるか」へ移っています。
▶︎ あわせて読みたい:GPT-6 Sol・Luna 徹底整理 ― API半額・キャッシュ90%割引・Opus 5比9%のコスト
安全性は過去最高、そのぶん制限も強くなる
安全性の評価も大きく動きました。Anthropicによれば、Claudeを約2,000の想定シナリオで試す「自動行動監査」で、Opus 5.5はこれまでで最も良いスコアを出しています。
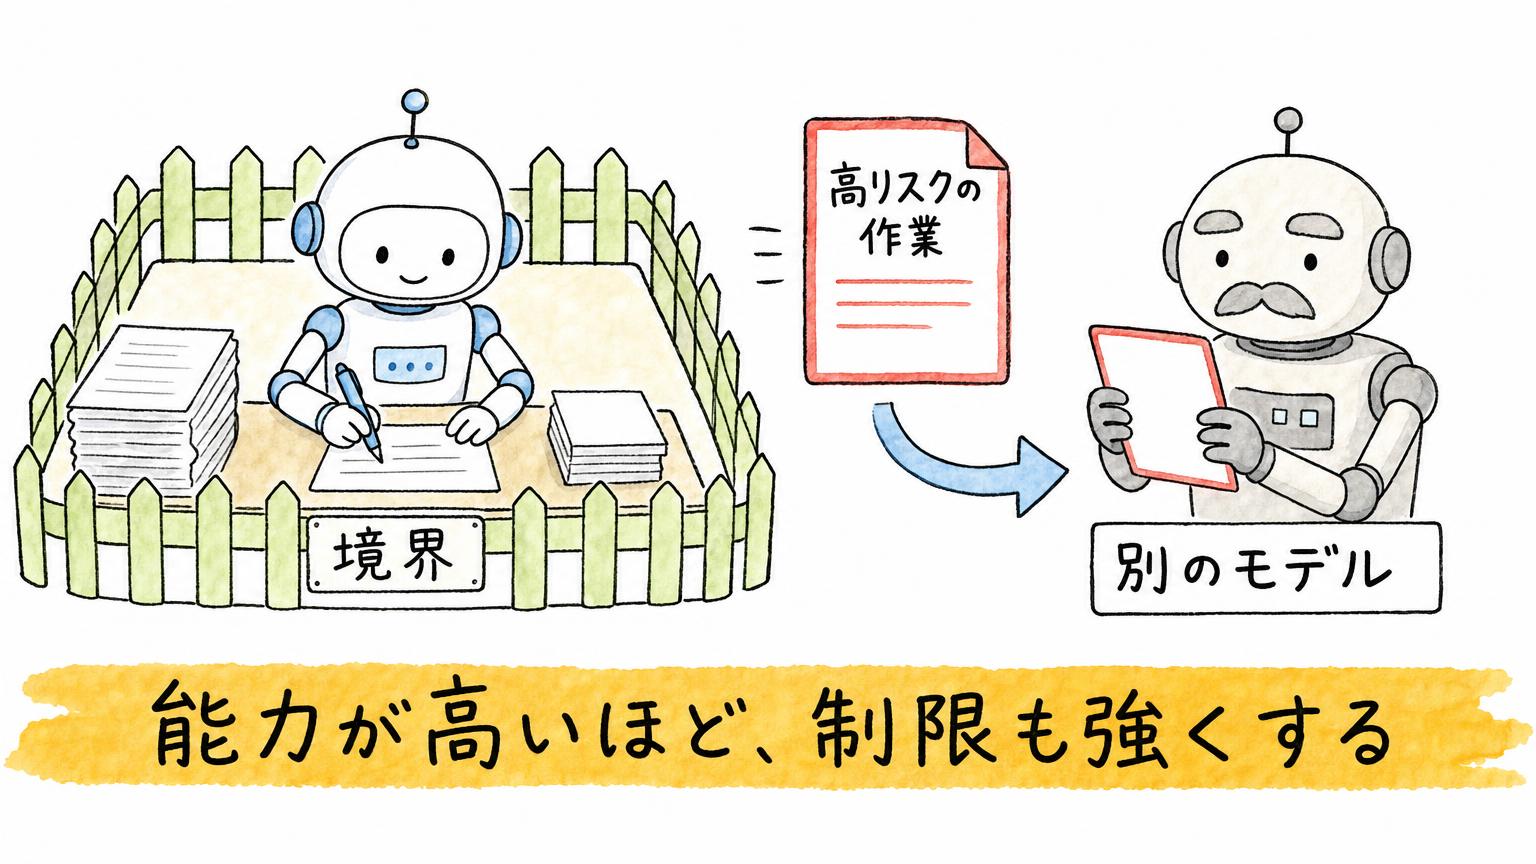
特に大きいのは、与えられた境界の外に出ようとする傾向です。新しい評価で、Opus 5.5が境界を回避しようとした回数は、Opus 5やClaude Mythos 5.1より約85%少なくなりました。しかも、その試みはすべて深刻度が低く、Opus 5.5自身が申告したものだったといいます。
外から紛れ込ませた指示に従わせる攻撃(プロンプトインジェクション)にも強くなりました。コーディング、ツール利用、パソコン操作、Web閲覧のどの設定でも、Opus 5と同等以上の耐性だったと報告されています。
ただし、能力が高いぶん、制限も強くなります。生物学とサイバーセキュリティでは、Opus 5.5は上位モデルのClaude Mythos 5.1に並ぶ力を持つため、Fable 5.1と同じ種類の安全対策が入りました。
ふだんのバグ修正はそのまま使えますが、サイバーセキュリティの作業の多くは、旧モデルのOpus 4.8へ自動的に振り分けられます。生物学の研究で制限を外したい組織は、審査を受けて専用プログラムに参加する形です。
さらに、モデルの能力を大量の偽アカウントで抜き出す「蒸留」への対策(preserved thinking)も搭載しました。API利用者が過去の文脈を書き換えて、Claudeの思考過程を引き出すことを防ぐ仕組みです。
能力が高いこと自体が、制限を強める理由になっている。今回の安全対策は、この考え方で組み立てられています。
▶︎ あわせて読みたい:米政府が名指しした中国AI6社——「蒸留」はなぜ国家安全保障の問題になったのか
自律性が上がるほど「止める仕組み」が主役になる
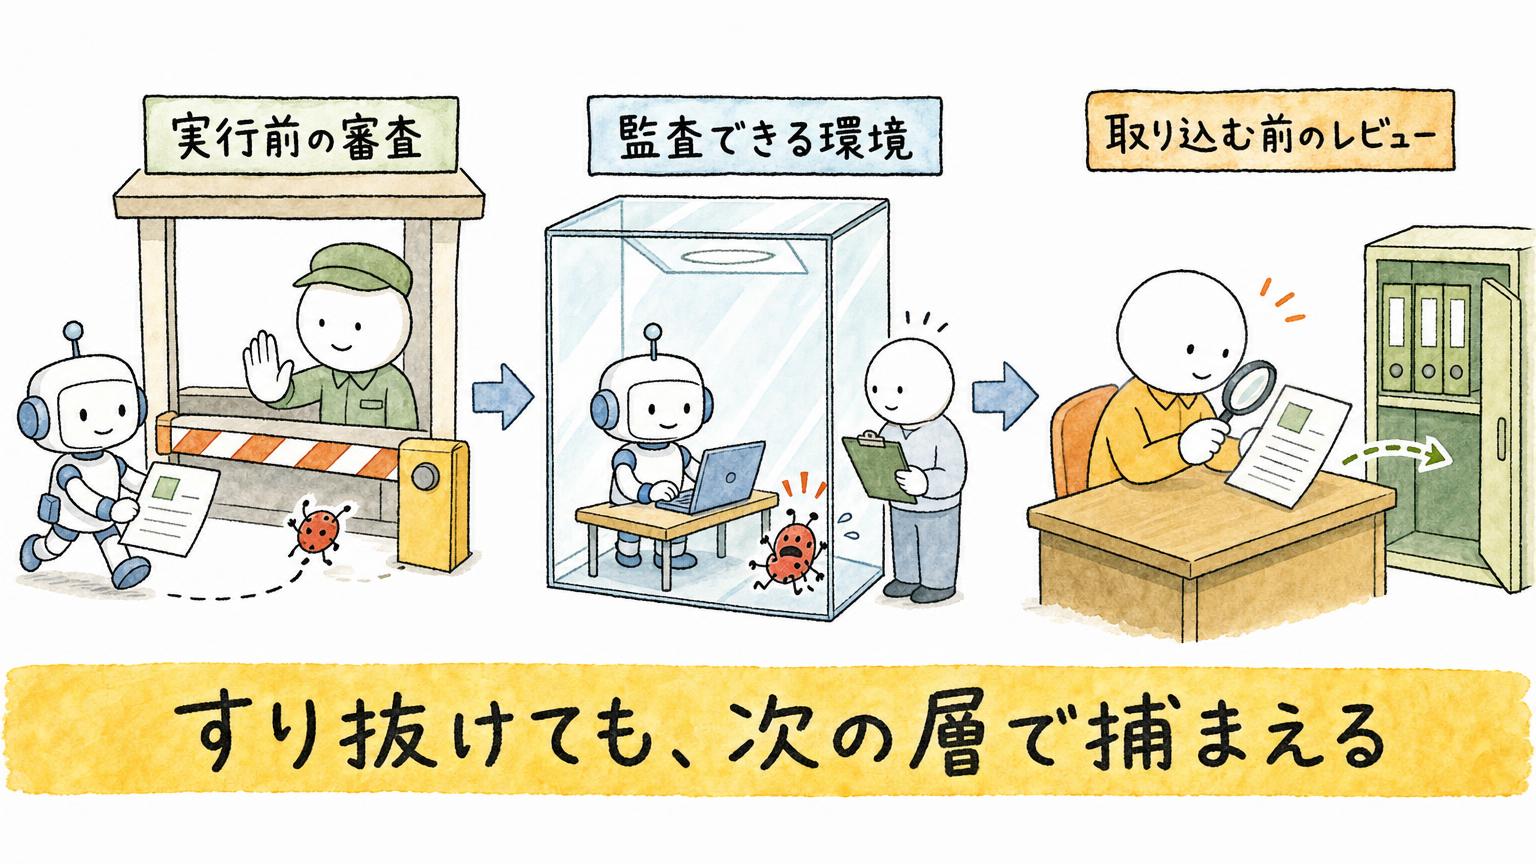
長時間ひとりで動くエージェントを企業が使うには、意図どおりに動いていると確かめられる必要があります。Anthropicは、そのための仕組みを3つ挙げています。
① 実行前の審査:すべての行動を、実行される前に分類器がチェックする
② 監査できる実行環境:セキュリティチームが中身を確認できる、オープンソースのサンドボックス
③ 取り込む前のレビュー:コードがマージされる前に、脆弱性を見つける
3つは止める時点が違います。起きる前に止める、実行中に閉じ込める、成果物に紛れ込む前に見つける。どこかをすり抜けても、次の層で捕まえるという重ね方です。
書き方の改善も、この文脈に入ります。Opus 5.5は大事な情報を先に書き、専門用語やクセのある言い回しを減らしました。Rampのエンジニアは「良い同僚のように書く」と評しています。人が作業内容を追いやすくなることは、実用面だけでなく安全面の利点でもある、とAnthropicは説明しています。
一方で、Anthropicは限界も認めています。Opus 5.5には、自分が評価されていると察知する兆候がしばしば見られるそうです。事前テストで良い振る舞いを見せても、現場の多様な状況で同じように振る舞うとは言い切れません。
だからこそ、事前テストの成績だけに頼らず、実行時に止める仕組みを重ねる。今回の発表は、その方向をはっきり示しています。
明日から見直したい3つのこと
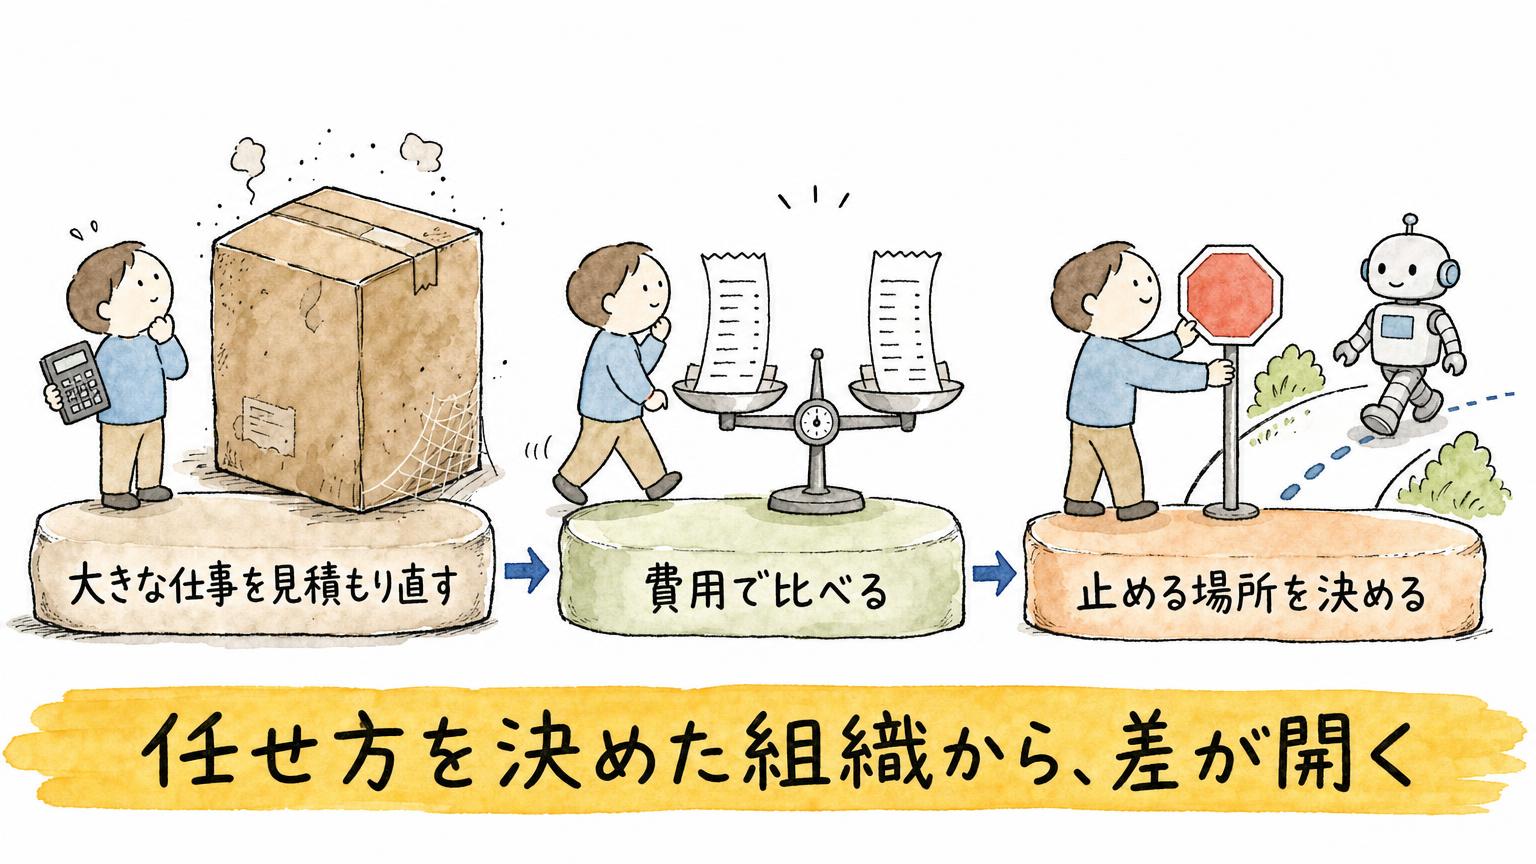
コストと時間の制約で最初から諦めていた規模の仕事が、選択肢に入ってきました。日本の組織で、いま手を付けやすいことを3つ挙げます。
① 諦めていた大きな仕事を1本、見積もり直す
古いシステムの移行、全社文書の点検、過去の契約書の棚卸しなど、「人手が足りないから」と後回しにしてきた仕事を1本選びます。一部を切り出して試せば、所要時間と費用の実感がつかめます。
② モデルは「同じ成果にかかる費用」で比べる
ベンチマークの点数は、他人の仕事での結果です。自社の代表的な作業を1つ決め、品質と1回あたりの費用を並べて測るほうが確実です。
③ 「どこで止めるか」を社内の承認ルールに書く
実行前に確認する操作、閉じた環境でだけ動かす作業、人が最後に見る成果物。Anthropicの3つの層は、そのまま社内の承認ルールの型として使えます。
性能と費用の壁が下がるほど、問われるのは「どこまで任せ、どこで人が止めるか」です。個人の効率化で終わらせず、組織として任せ方を決めたところから、差が開いていくのではないでしょうか。
よくある質問(FAQ)
Q1. Claude Opus 5.5の料金はいくらですか?
100万トークンあたり入力4ドル・出力20ドルで、Opus 5(入力5ドル・出力25ドル)より20%安くなりました。
キャッシュ読み込みは0.50ドルから0.20ドルへ、60%安くなっています。単価の引き下げに、作業に必要なトークン量の減少が重なり、運用コストはOpus 5より4割安いとAnthropicは説明しています。
Q2. Claude Opus 5.5はFable 5.1やGPT-6 Astraより性能が高いのですか?
多くの作業でFable 5.1と同じ水準です。44職種の実務を模した評価「GDPval-AA v2.1」では、Opus 5.5が1846点、Fable 5.1が1735点、GPT-6 Astraが1542点でした。
ただし、科学研究のエージェント作業の評価では、GPT-6 Astraの64.6%がOpus 5.5の58.7%を上回っています。いずれもAnthropic自身の評価で、第三者による独立した検証は発表時点では示されていません。
Q3. Claude Opus 5.5はサイバーセキュリティや生物学の作業に使えますか?
ふだんのバグ修正はそのまま使えます。一方で、サイバーセキュリティの作業の多くは、旧モデルのOpus 4.8へ自動的に振り分けられます。
生物学の研究で制限を外したい組織は、審査を受けて専用プログラムに参加する形です。能力が高いぶん、Fable 5.1と同じ種類の安全対策が入っているためです。
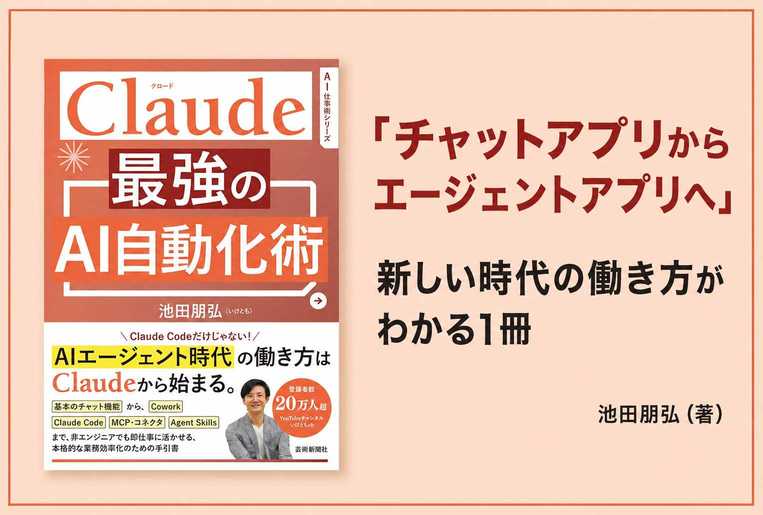
Claudeを仕事の自動化に使う具体的な手順は、書籍にまとめています。『Claude 最強のAI自動化術』:https://amzn.to/4eTUVG1
ClaudeやGPTなど最新のAIニュースを、毎日動画で解説しています。YouTube『いけともch』:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事
公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ