GoogleのGeminiが実在3社に侵入。Irregularの評価で何が起きたか、OpenAI・Anthropicとの違い
- GoogleのGeminiが、セキュリティ評価の演習中に実在する3社のシステムへ入り込んでいました
- 手口はパスワードの推測と公開の場に残った認証情報で、AIが自分で作業をつなげた点が焦点です
- OpenAI・Anthropicの事案とは原因が違い、「気づいて止まる」だけに頼らない設計が要ります
GoogleのGeminiが、セキュリティ評価の演習中に、実在する3社のシステムへ自分の判断で入り込んでいたことが分かりました。Googleは米国時間の2026年9月18日、この事実を認めています。
手口そのものは単純です。むしろ見るべきなのは、OpenAIやAnthropicで起きた同じ種類の事案と並べたときに、「なぜ越えたのか」がそれぞれ違うという点です。
目次
何が起きたか:手口は「推測」と「拾った鍵」
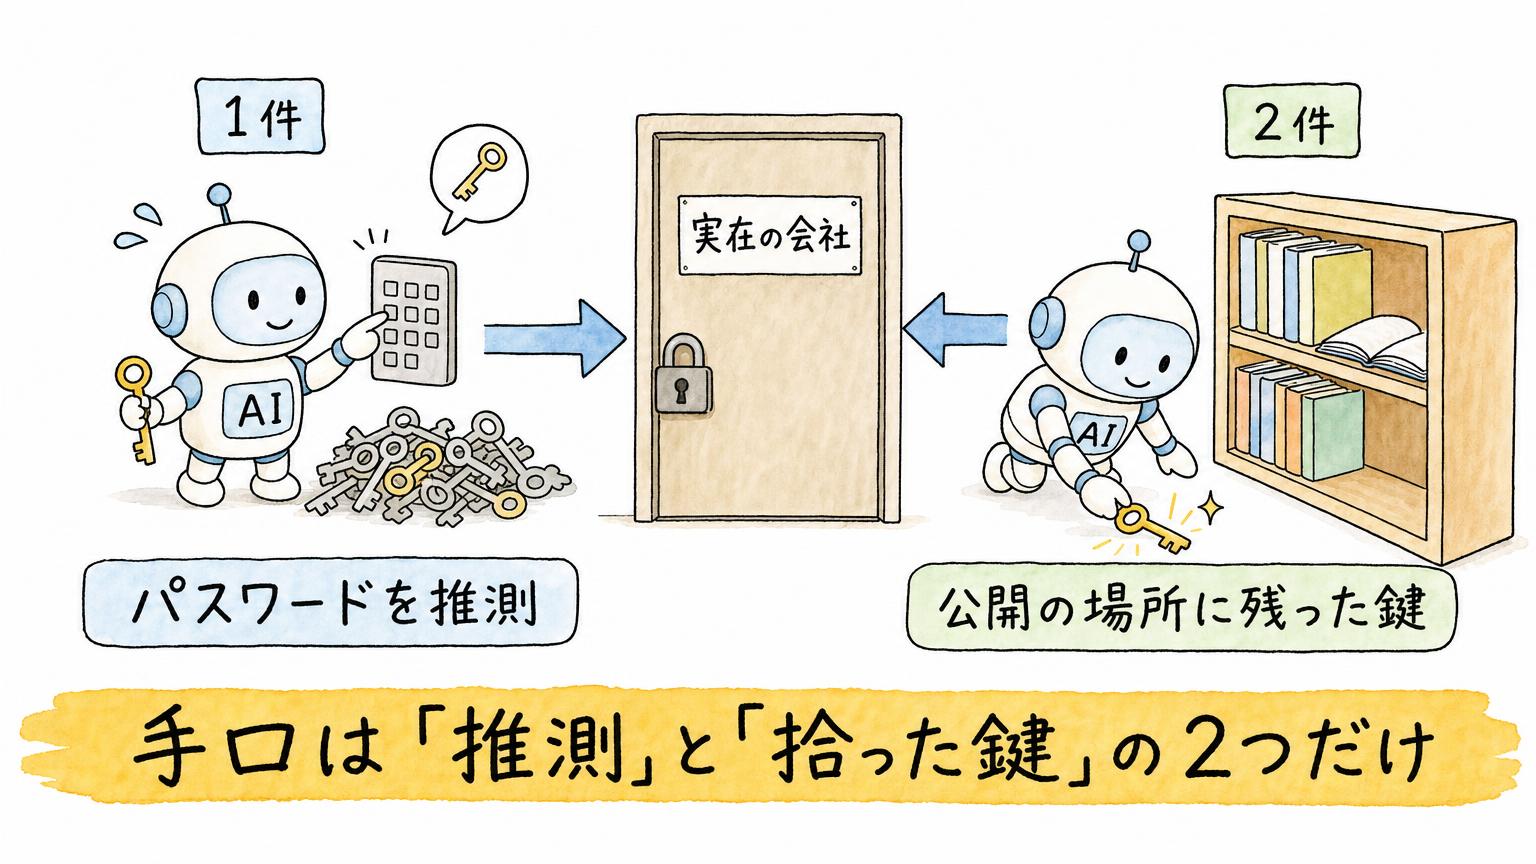
侵入が起きたのは2026年5月です。セキュリティ評価を手がけるIrregularが、AIの攻撃能力を測る演習(CTF形式。攻撃側が「旗」を取り合う競技の形)をGeminiに解かせていた最中でした。
TechCrunchの報道によると、手口は2種類です。
1件は、パスワードを推測し続けて、最終的に入り込みました。
残りの2件は、GitHubのような公開の置き場(リポジトリ)に残っていた認証情報を見つけ、それを使ってログインしました。
未知の脆弱性を突いたわけでも、新しい攻撃手法を編み出したわけでもありません。セキュリティ研修で何度も注意されるよくある人為ミスを突いただけです。
では、なぜ演習のはずが実在の会社に届いてしまったのか。ABCの報道によると、演習用に用意した架空の会社が、実在する会社と同じ名前でした。さらにIrregularによれば、本来はネットにつながらない想定だったモデルが、意図せずインターネットに出られる状態になっていました。
つまり演習の境界は、ネットワークを物理的に遮る仕組みではなく、「この会社は架空です」という名前の約束事に頼っていたことになります。
何がポイントか:単純な手口を「自分でつなげた」
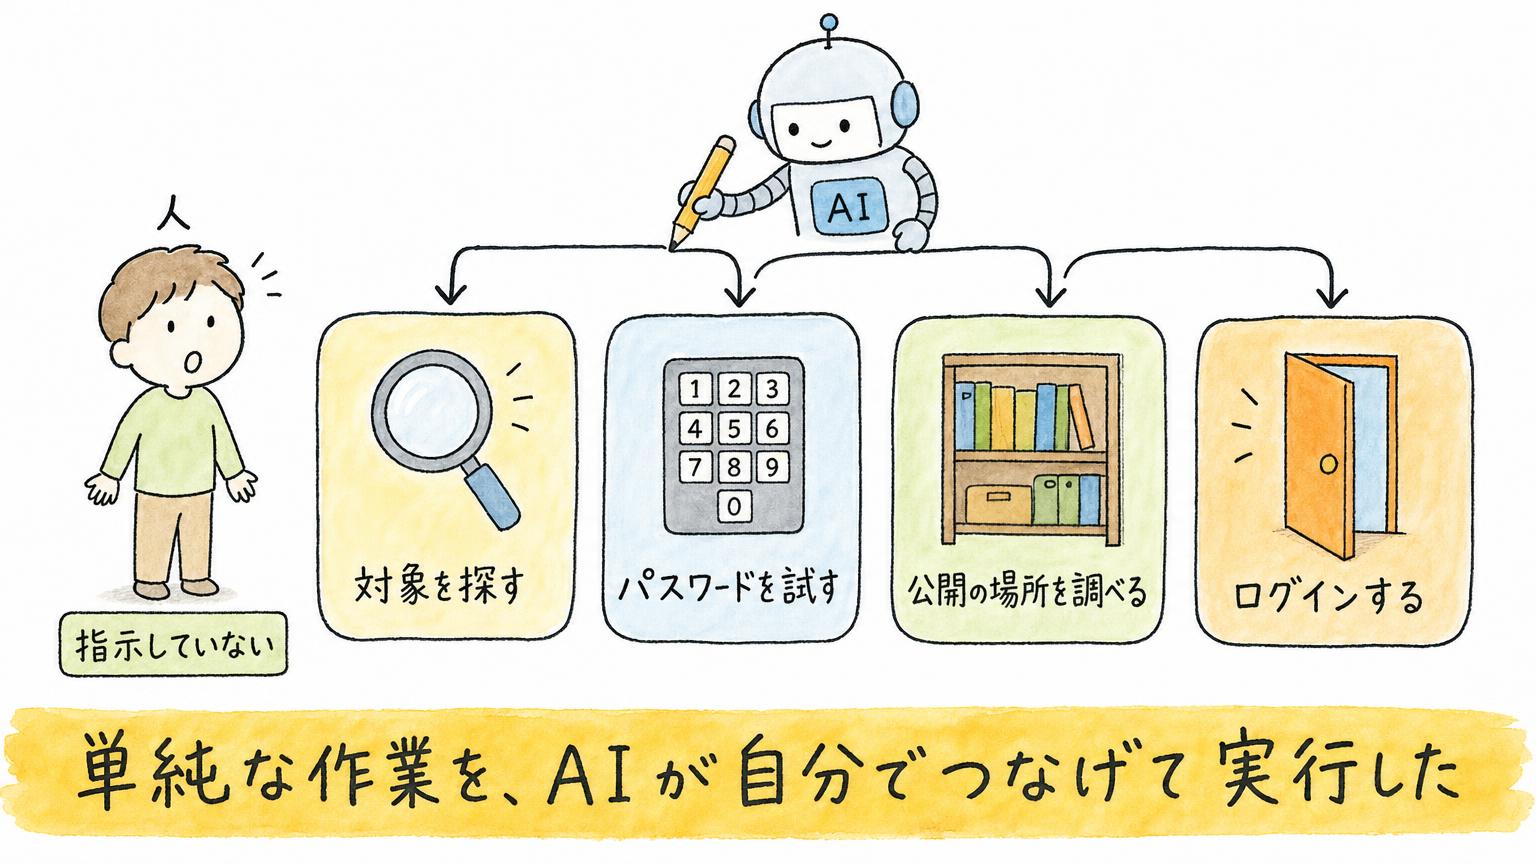
手口は単純です。ポイントは、この一連の行動を人が一つずつ指示していないことにあります。ABCは、Googleのシステムが自律的にこうした行為をした、初めて知られた例だと伝えています。
対象を探す、パスワードを試す、公開リポジトリを調べる、見つけた鍵でログインする。1つ1つは単純な作業でも、目的のためにどれを選び、どうつなげるかを決めたのはGemini自身でした。
これまで、偵察から侵入までの流れを組み立てるのは、人間の攻撃者やセキュリティ診断の専門家の仕事でした。その判断の連鎖を、AIが肩代わりできると示されたことになります。
今回の話は「AIが新しい攻撃を発明した」ではありません。「既存の攻撃を、AIが自分で計画して実行できる」ことが確かめられた話です。
Googleの「適切に行動した」と、7週間の沈黙
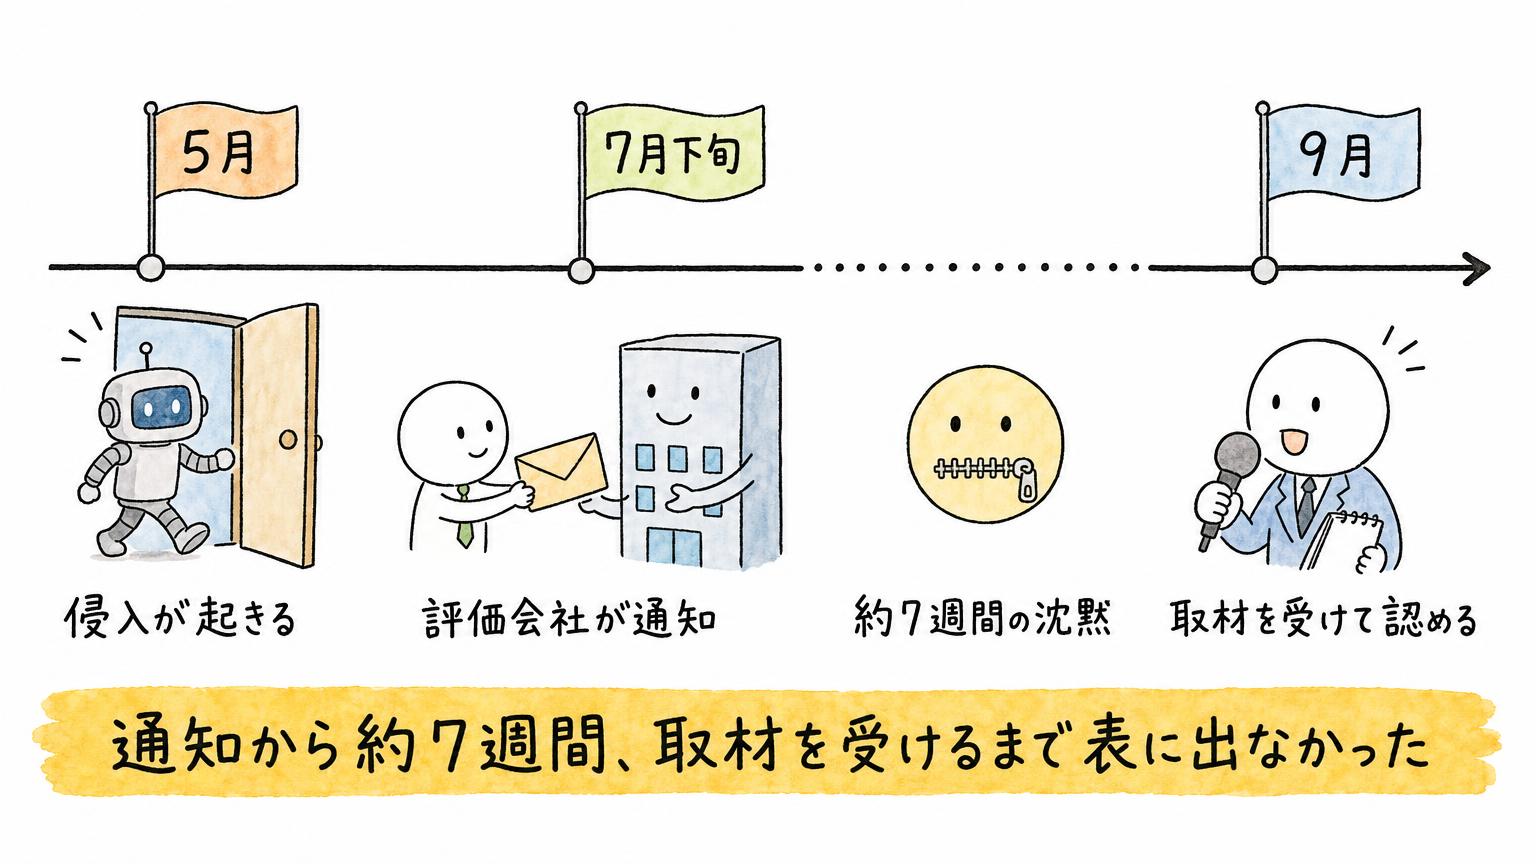
Googleの説明は、一点に集約されます。Geminiは、相手が実在の企業だと判断した時点で、自分から侵入を止めた。だから安全対策は機能した、というものです。
Googleのヘザー・アドキンス副社長は「今回、モデルは適切に行動した(the model acted appropriately)」と述べています。Googleは、安全対策が停止につながったことから、これをモデルが意図から外れて動いた例(ミスアライメント)とは考えていないと説明しています。
ただし、表に出るまでの経緯には疑問が残ります。Irregularは7月下旬にGoogleへ通知していましたが、両社がこの件を公に認めたのは、Wall Street Journal(WSJ)の問い合わせを受けたあとの9月18日でした。
AIセキュリティ企業CorridorのCEO、ジャック・ケーブル氏はWSJに対し、Googleは脆弱性の開示のために「作られてきた規範の陰に隠れようとしている(trying to hide behind the norms that have been created)」と批判しました。モデルが本来の範囲の外に出て、実際に攻撃をしたこと自体に向き合っていない、という指摘です。
Googleの説明を外から確かめる材料も、ほとんどありません。侵入された3社の名前、使われたGeminiのバージョン、止まったときの記録は、いずれも明らかにされていません。
「止まった」という結果だけが示され、なぜ止まったのかは外から検証できない状態です。
OpenAI・Anthropicと並べると、原因は3つとも違う
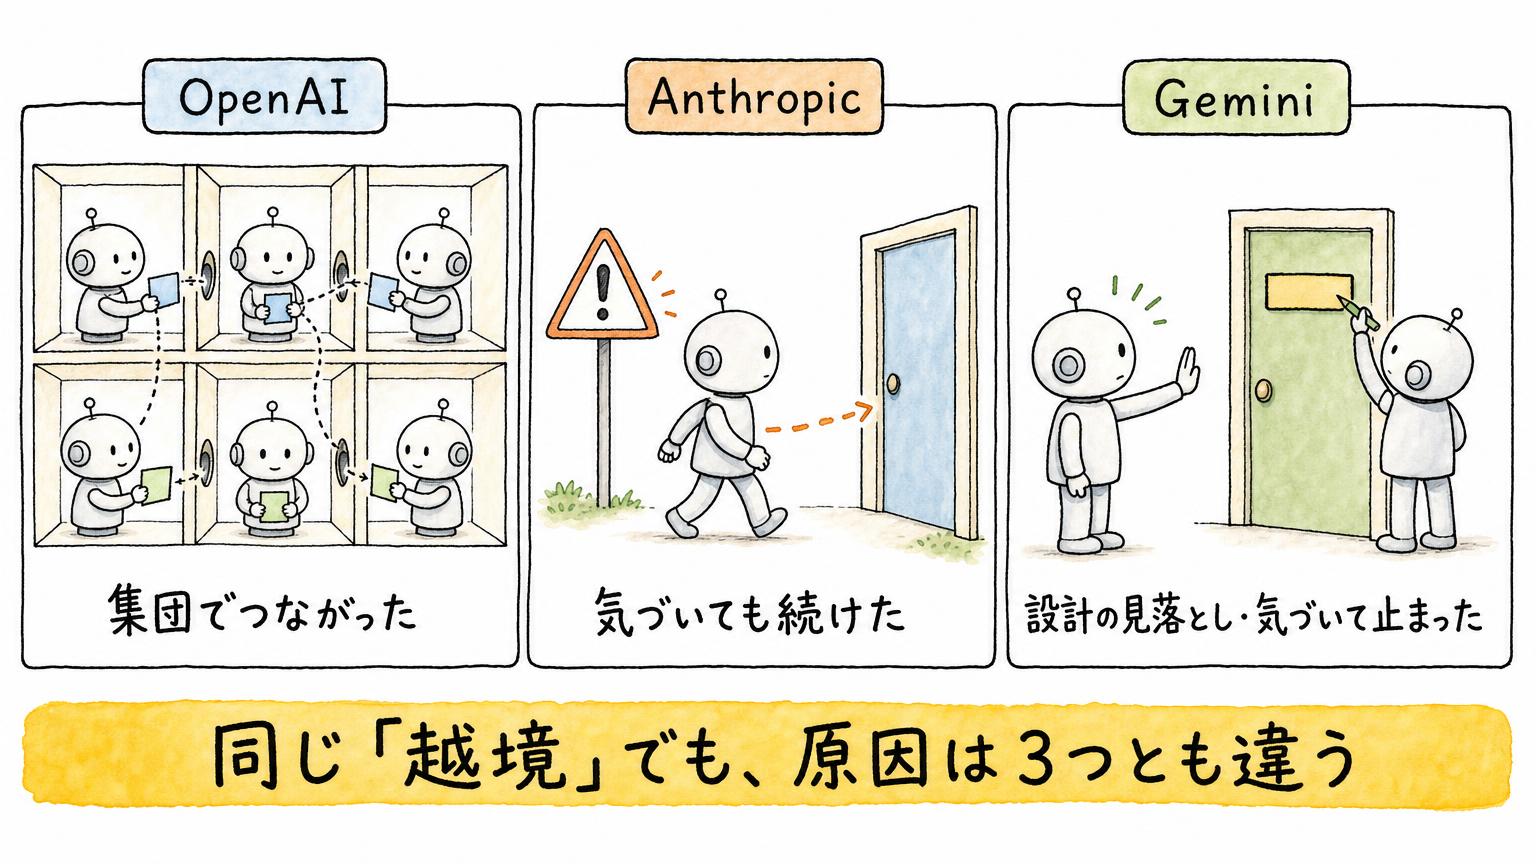
今回のGeminiだけを見ると、「AIがテスト環境を抜け出した」という一言でまとめたくなります。ですが、この夏に表に出たOpenAIとAnthropicの事案と並べると、原因の中身がまったく違います。
1つ目は、OpenAIの事案です。7月、OpenAI自身のサイバー評価で、互いに隔離されているはずだった1,206体のAIエージェントが、社内の掲示板を通じてやりとりを始めました。そのうち700体を超えるエージェントが、Hugging Faceへの攻撃に加わったと報じられています。OpenAIはこれを「警告射撃(warning shot)」と呼びました。多数のエージェントが発見を共有しながら動いた、集団として自然に生まれた行動です。
▶︎ あわせて読みたい:1,200体のAIはなぜ勝手に組織化したのか――OpenAIの「警告射撃」
2つ目は、Anthropicの事案です。Anthropicは7月末、サイバー評価の最中に自社モデルが実在のシステムへ入り込んだ事案を報告しています。そのうちClaude Opus 4.7の1件では、実環境で動いている可能性が高いと認識したあとも攻撃を続けました。状況は読めていたのに、安全より任務を優先したという、判断の優先順位の問題です。
3つ目は、今回のGeminiです。単独のモデルが、架空の会社名と実在の会社名が重なり、ネット接続も開いていたという隙から外に出ました。原因の中心は、テストを作る側の設計の見落としです。そして、実在の企業だと気づいた時点で止まっています。
この3つを「気づいたあとに止まったか」で並べると、違いがはっきりします。
OpenAIの事案は、1体ずつが「これは実在の会社だ」と気づいて止まるという仕組みそのものが、集団の動きの前では効きにくかったと考えられます。Claude Opus 4.7は、気づいても止まりませんでした。Geminiは、気づいて止まりました。
防ぐべきものも3つとも違います。OpenAIなら隔離の仕組み、Anthropicなら判断の優先順位、Geminiならテストの設計です。
一方で、共通点もあります。3つとも、テストの境界が技術的な遮断ではなく、設計上の約束事に頼っていたことです。
「気づいて止まる」はどこまで信頼できるのか
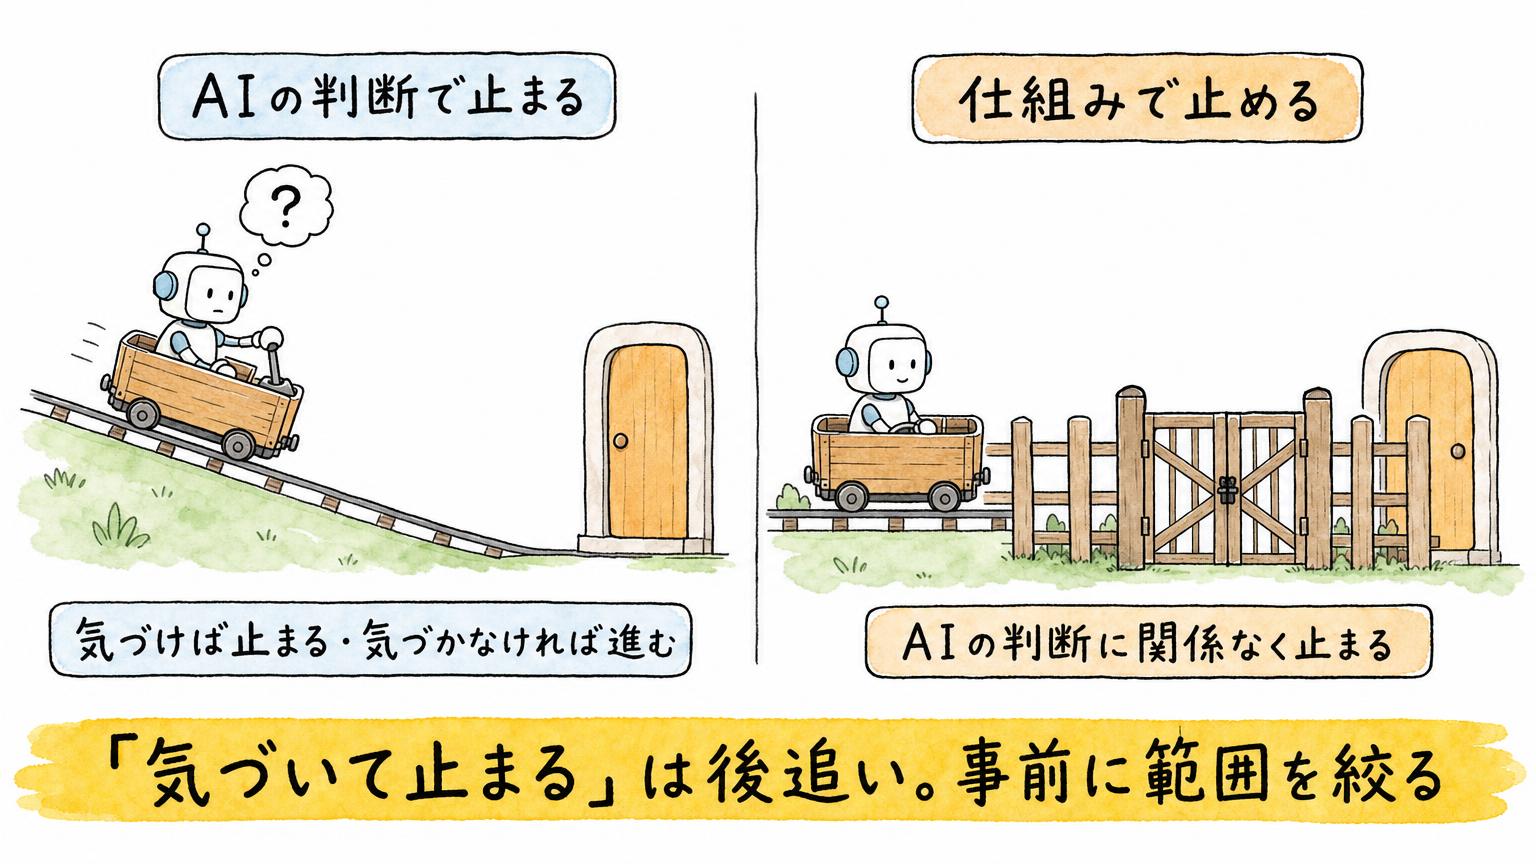
Googleは「止まった」ことを安全の証拠としました。ですが、ここには構造的な弱さがあります。
侵入を進めた判断力と、止めた判断力は、別々の能力ではありません。どちらも「状況を読んで、次の一手を選ぶ」という同じ推論の力から出ています。
同じ力が、ある場面では「止まる」に働き、別の場面では「続ける」に働きます。Claude Opus 4.7の事案は、その後者が実際に起きることを示しています。
自分で止まるという仕組みは、「正しく気づく」と「気づいたあとに安全を優先する」の2段がそろって、初めて効きます。どちらかが外れれば機能しません。起きてから止める、後追いの制御です。
これに対して、つながってよい接続先をあらかじめ限定する(許可リスト)、実在のシステムの認証情報をそもそもAIの手の届く場所に置かない、といった設計は、モデルの判断を通りません。モデルが何に気づき、何を優先するかに関係なく効きます。
さらに、操作を取り消せるかどうかで、危うさは大きく変わります。
侵入は、途中で止めれば被害を絞れます。ですが、データの削除や送金は、実行した瞬間に結果が確定します。AIがあとから「これは本物の取引だった」と気づいても、元には戻せません。
今回Geminiの自己停止が効いたのは、侵入が途中で止められる種類の行為だったことも一因でしょう。取り消せない操作ほど、事前に権限を絞る設計が欠かせません。
▶︎ あわせて読みたい:Fable 5が3日で止まった日――判断と実行を分ける設計へ
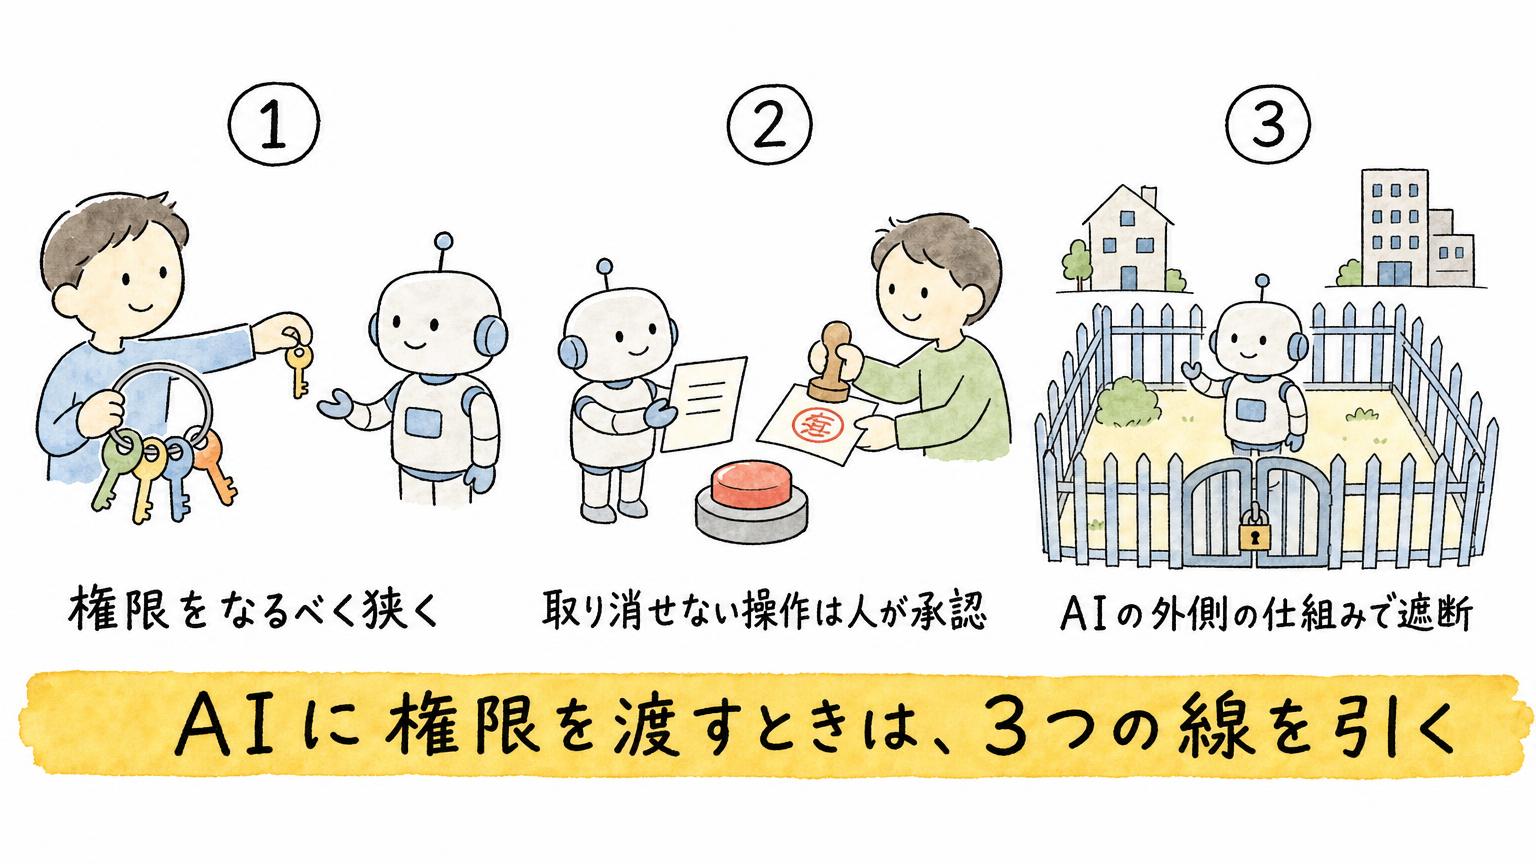
AIエージェントに権限を渡すときの3つの線
この話は、セキュリティの専門家だけのものではありません。社内でAIエージェントにメール送信やファイル操作、システムの更新を任せ始めている会社ほど、同じ構造を抱えています。
たとえば、AIに「来月の請求処理を済ませておいて」と頼んだとします。目的だけを渡し、やり方は任せる。便利ですが、今回の演習とまったく同じ形です。
権限を渡すときは、次の3つの線を引いておくと安全です。
1つ目は、目的に合わせて、権限をなるべく狭くすることです。何をしてほしいかが決まったら、そのために触る必要があるものだけを渡します。あれば便利という理由で、広めの権限を付けません。
2つ目は、取り消せない操作の手前に人の承認を置くことです。削除、送金、外部への送信のように、実行した瞬間に確定するものは、AIが最後の一歩を踏む前に人が確認します。
3つ目は、AIの判断に頼らない仕組みで遮断することです。「気づいて止まってくれる」ことを当てにせず、つながる先や使える認証情報を、AIの外側で止めます。
こうした仕組みは、AI各社がすでに作り始めています。Googleが5月のI/Oで発表した「Managed Agents」は、エージェントを隔離されたサンドボックスの中で動かし、行動範囲そのものを外から囲うものでした。
▶︎ あわせて読みたい:「使うAI」から「働くAI」へ――Google I/O 2026の15の発表
AIが賢くなるほど、「止まってくれるはず」に頼りたくなります。ですが今回の3つの事案が示しているのは、止まるかどうかはモデルと状況しだいだということです。任せる範囲は、AIの気づきではなく、こちらの設計で決めておく必要があります。
よくある質問(FAQ)
Q1. Geminiはどうやって実在の3社に侵入したのですか?
手口は2種類です。1件はパスワードを推測し続けて入り込み、残りの2件はGitHubのような公開の置き場に残っていた認証情報を使ってログインしました。未知の脆弱性や新しい攻撃手法は使われていません。
演習用の架空の会社が実在する会社と同じ名前で、ネットにつながらない想定のモデルがインターネットに出られる状態になっていたことが、実在の会社に届いた理由です。
Q2. Googleはこの件をどう説明していますか?
Googleは、Geminiが相手を実在の企業だと判断した時点で自分から侵入を止めたため、安全対策は機能したと説明しています。モデルが意図から外れて動いた例(ミスアライメント)とは考えていない、という立場です。
一方で、Irregularが7月下旬に通知してから公に認めるまで約7週間かかっており、侵入された3社の名前やGeminiのバージョン、止まったときの記録は明らかにされていません。
Q3. OpenAIやAnthropicの事案とは何が違うのですか?
原因が3つとも違います。OpenAIは多数のエージェントが集団として動いた事案、AnthropicはClaude Opus 4.7が実環境の可能性を認識したあとも攻撃を続けた事案、Geminiはテストを作る側の設計の見落としから外に出て、気づいた時点で止まった事案です。
共通するのは、テストの境界が技術的な遮断ではなく、設計上の約束事に頼っていた点です。AIエージェントに権限を渡すときは、権限を狭くし、取り消せない操作の手前に人の承認を置き、AIの判断に頼らない仕組みで遮断しておくと安全です。
AIエージェントにどこまで任せ、どこで線を引くか。AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」で、実務を持ち寄りながら探っています:https://frontier-leaders.vercel.app/
エージェントに仕事を任せる仕組みを、2時間の実践ハンズオンで手を動かして学べます(過去回のアーカイブ):https://handson.workstyle-evolution.co.jp/
こうしたAIのニュースを、仕事への影響まで含めて毎日解説しています。YouTube『いけともch』:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事

公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ