
「Mythos級AI」は本当に拡散したのか──GLM-5.3の公開で、日本企業のサイバー防御は何を変えるべきか
「Mythos級AI」は本当に拡散したのか──GLM-5.3の公開で、日本企業のサイバー防御は何を変えるべきか
- 「Mythos級」は、欠陥を見つける力ではほぼ本当ですが、攻撃を深く仕上げる力にはまだ差があります。
- 重みが公開され保護も外せるため、最強でなくても入手性の高さが脅威を押し上げます。
- 企業は防御にもエージェントを入れ、届く範囲を絞り、意思決定を速める必要があります。
2026年4月15日、参議院の特別委員会で、安野貴博氏は「Mythos級」のモデルを、早くて数か月、遅くても1年以内にほかの企業やアメリカ以外の企業も開発できる可能性がある、と述べました。
その4か月後の8月14日、中国のZ.aiがオープンモデルのGLM-5.3を発表し、約2週間後に重みを公開しました。安野氏は10月6日のXで、GLM-5.3を「ほぼMythos級のよう」と評価し、4月の発言が実現した形だと述べています。
では、「Mythos級AI」は本当に拡散したのでしょうか。この記事では、GLM-5.3で何が確認できて何が変わったのかを整理し、日本企業が防御の工程をどう組み替えるべきかまで考えます。
「ほぼMythos級」は、見つける力では本当だった
最初に、数字を並べます。
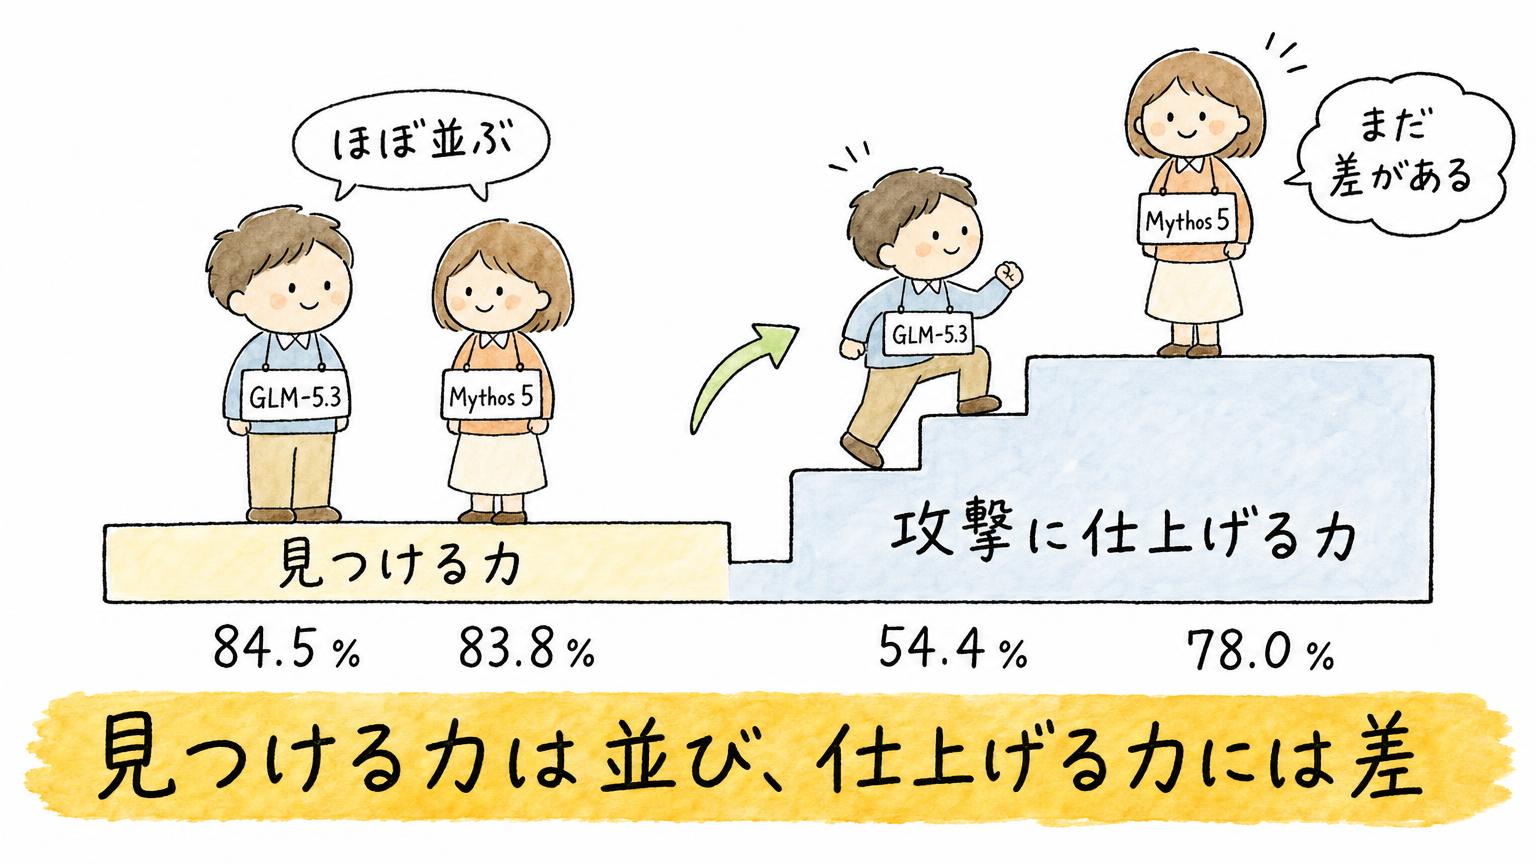
Z.aiの評価では、ソースコードから脆弱性を見つけ、実際に異常を起こして確かめられるかを測るCyberGymで、GLM-5.3は84.5%でした。前のバージョンのGLM-5.2の77.2%から大きく伸び、Mythos 5の83.8%も上回って、比較表の中で最高です。
一方、見つけた欠陥を実際の攻撃に仕上げる段階では、差が残ります。
- ExploitBench(実在の脆弱性を深く推論し、悪用に仕上げる評価):GLM-5.3は54.4%、Mythos 5は78.0%
- ExploitGym(時間をそろえた枠で、悪用の課題をいくつ完了できるか):2時間枠でGLM-5.3は105件、Mythos 5は181件
Z.ai自身が、攻撃の連鎖の先へ進む評価ほどGLM-5.2からの伸びは大きく、同時にMythos 5との差も広い、と書いています。
別の測定でも、近さと差の両方が出ています。Anthropicが9月29日に公表した比較では、攻撃コードを最後まで成立させた回数は、410回の試行のうちGLM-5.3が50回、Mythos Previewが56回でした。この評価では近い結果です。
米国の政府機関NIST(国立標準技術研究所)のCAISIは、9月17日の評価で、GLM-5.3を「これまでに公開された中で最もサイバー能力の高い公開重みモデル」としました。ただし総合指標では、米国の最前線のモデルから約4か月遅れています。
つまり「ほぼMythos級」は、欠陥を見つける力と、一部の攻撃を成立させる力では妥当です。攻撃を深く仕上げる力まで含めると、まだ差があります。「最も強い公開重みモデル」は「世界で最も強いモデル」ではありません。
国内で相次ぐ情報漏えいを、この拡散の結果と見る根拠は、今のところ確認できません。
▶︎ あわせて読みたい:4社の公表を読み比べて分かった、漏えいの被害を決めたもの
同じ基盤モデルのまま、後学習だけで伸びた
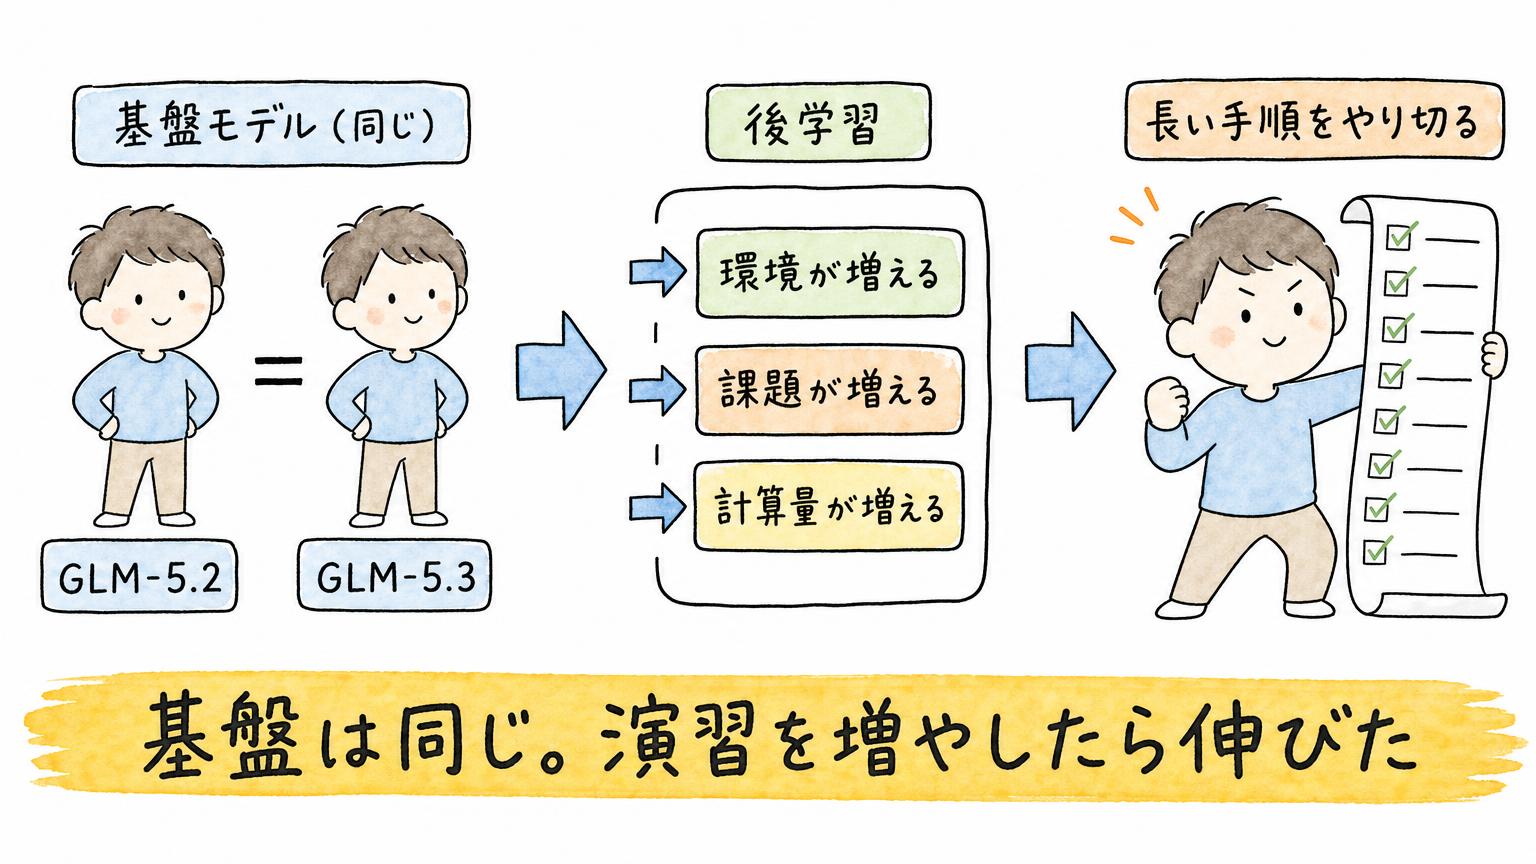
Z.aiは、GLM-5.3でやったのは後学習の拡大だけだと説明しています。基盤モデルはGLM-5.2と同じで、すべての向上は後学習から来たといいます。
後学習とは、基盤モデルが完成したあとに、特定の課題を繰り返し解かせて行動を整える工程です。基盤モデルを知識の同じ新人にたとえるなら、後学習は、採点つきの実戦演習を何倍もこなさせることにあたります。
GLM-5.3では、演習の場にあたる環境が増え、課題の種類が増え、演習に使う計算量が増えました。長い手順を最後までやり遂げ、結果を実行して確かめる演習を積んだことが、コードを書く力だけでなく、攻撃の連鎖をたどる力にもつながったと考えられます。
Z.aiはサイバー能力が想定より速く伸びたと書き、発表のタイトルでも「創発的な(Emergent)サイバー能力」と呼んでいます。
同じ構造は、AnthropicのMythos Previewの評価にもあります。悪用の能力は明示的に訓練したものではなく、コード・推論・自律性が全般に上がった結果として現れたと説明されています。
この構造が意味するのは、防御に役立つ「欠陥を見つけて直す力」と、攻撃に使える「欠陥を悪用する力」が、同じ土台から伸びることです。片方だけを切り離して配ることは難しいと考えられます。
公開重みになると、提供者は止められなくなる
Z.aiは発表の時点で、安全性の評価と強化が終わったら2週間後に重みを公開すると予告しました。NISTの記録でも、その2週間後に重みが公開されています。
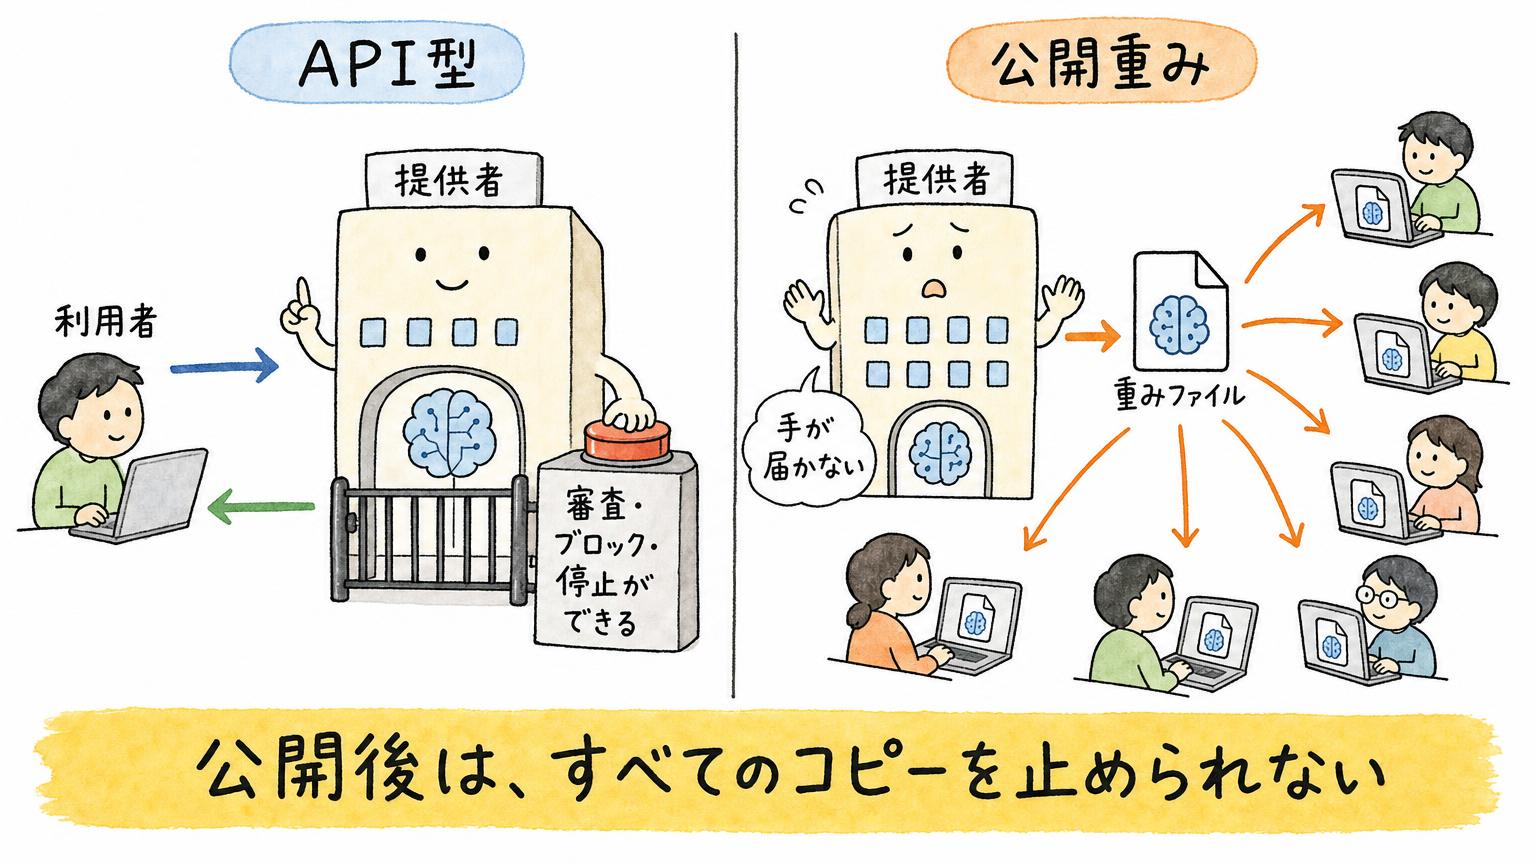
重みの公開は、APIで提供されるモデルとは決定的に違います。APIでは、モデル本体が提供者の側にあります。利用者は要求と応答をやり取りするだけなので、提供者は本人確認、用途の審査、出力のブロック、ログの監視、停止を続けられます。
公開重みでは、利用者がモデルをダウンロードし、自分の計算機で動かします。設定も、追加の学習も、保護の仕組みも、利用者が変えられます。
Anthropicの模擬試験では、GLM-5.3の保護を回避できた割合は64〜100%でした。
- 偽の事情を設定して頼む手法:64%
- 思考の書き出しを先に入れてしまう手法(事前入力):92%
- 重みそのものを書き換えて拒否の振る舞いを外す手法:100%
最後の手法は、重みが公開されていないClaudeには使えません。実際、GLM-5.3では、公開から数日のうちに、保護を外した版が複数の開発者によって公開されました。
数字はAnthropicが模擬環境で測った値で、現実の攻撃での成功率ではありません。
それでも、構造は変わりません。提供者が一度つけた保護を、すべてのコピーに対して更新・監視・停止することはできないのが、公開重みの境界です。
対照的に、Anthropicは強い能力ほど、提供の形を絞っています。2026年10月6日の発表によると、一般に提供するモデルにはサイバー作業の大半を止める保守的な保護を置き、審査を通った組織には、防御、認可済みの侵入テスト、検証済みの限られた組織向けの特別用途と、3つの階層でアクセスを広げています。
能力が高いほど、本人確認、対象、監視を強くする。この設計は、重みを手放した時点で取れなくなります。
▶︎ あわせて読みたい:Anthropicが検知した「7つのAI悪用パターン」で見えた、サイバー攻防の構造
最強でなくても、入手できれば脅威は増える
NISTの評価では、GLM-5.3は米国の最前線から約4か月遅れています。では、脅威は小さいのでしょうか。小さいとは言えません。
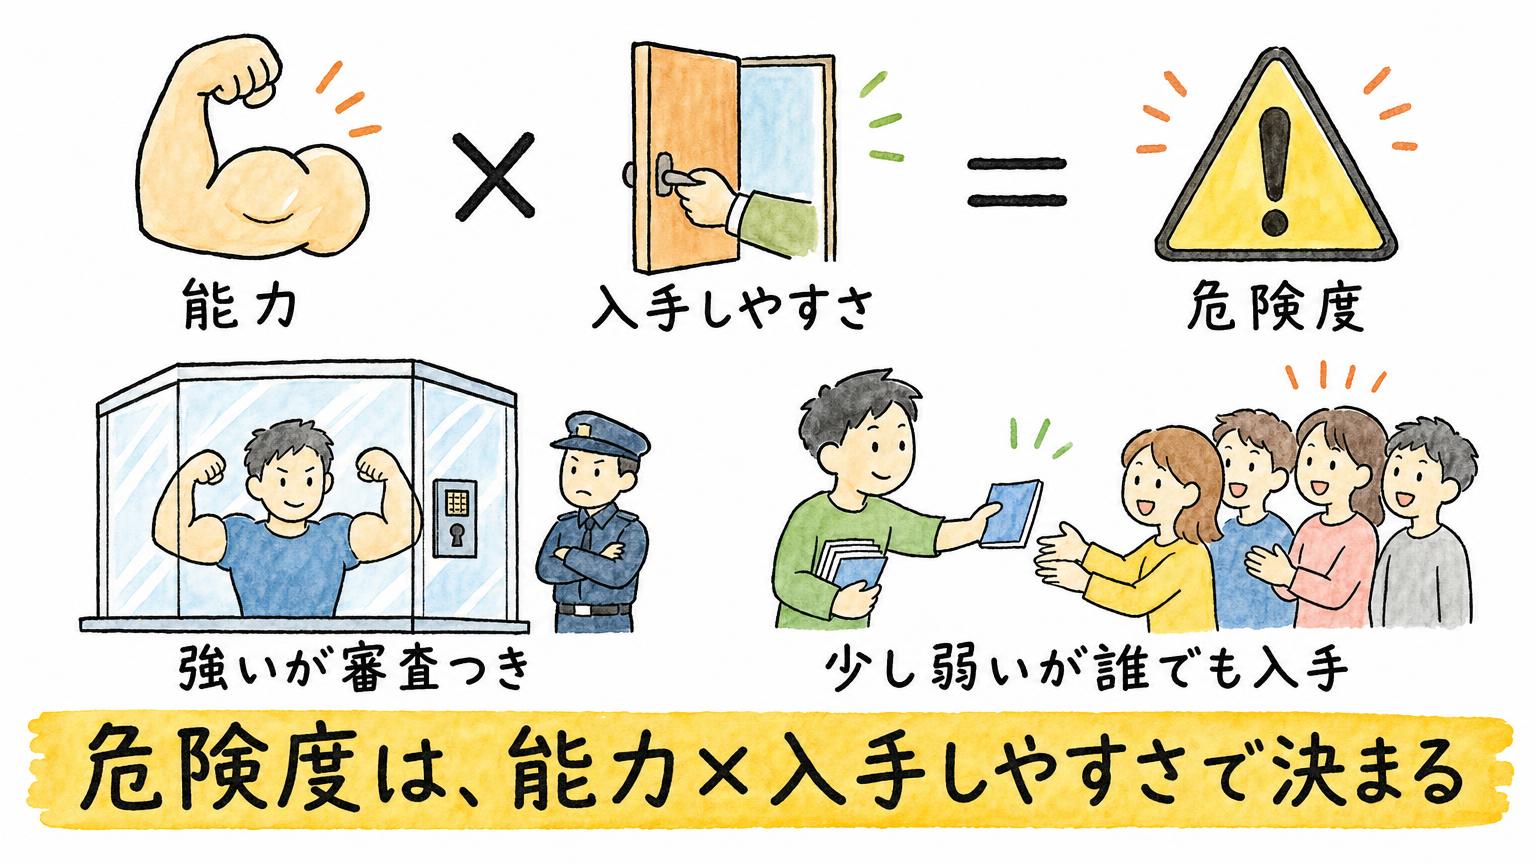
攻撃者にとって重要なのは、最高得点かどうかより、入手できるか、何度でも試せるか、保護を外せるか、特定の標的に合わせて調整できるか、です。能力が少し低くても、入手の制約が大きく下がれば、実際に使える攻撃能力の総量は増えます。
逆に、強いモデルでも、厳しい審査・監視・隔離のもとで少数の防御組織だけが使うなら、悪用される面は小さくなります。危険度は、能力と入手性の掛け算で決まります。
入手しやすさは、防御側にも同じように働きます。Anthropicも、この水準のモデルは防御側が使うこともできるとして、防御側には敵対者と少なくとも同等の最先端モデルを持たせるべきだと述べています。
だから論点は、公開の是非だけではありません。公開の可否は政策の話で、企業が今日から動かせるのは、攻撃者より先に、防御側が検査・修正・封じ込めの工程へこの能力を組み込めるかどうかです。
防御の詰まりどころは「見つける」から「止めて直す」へ移る
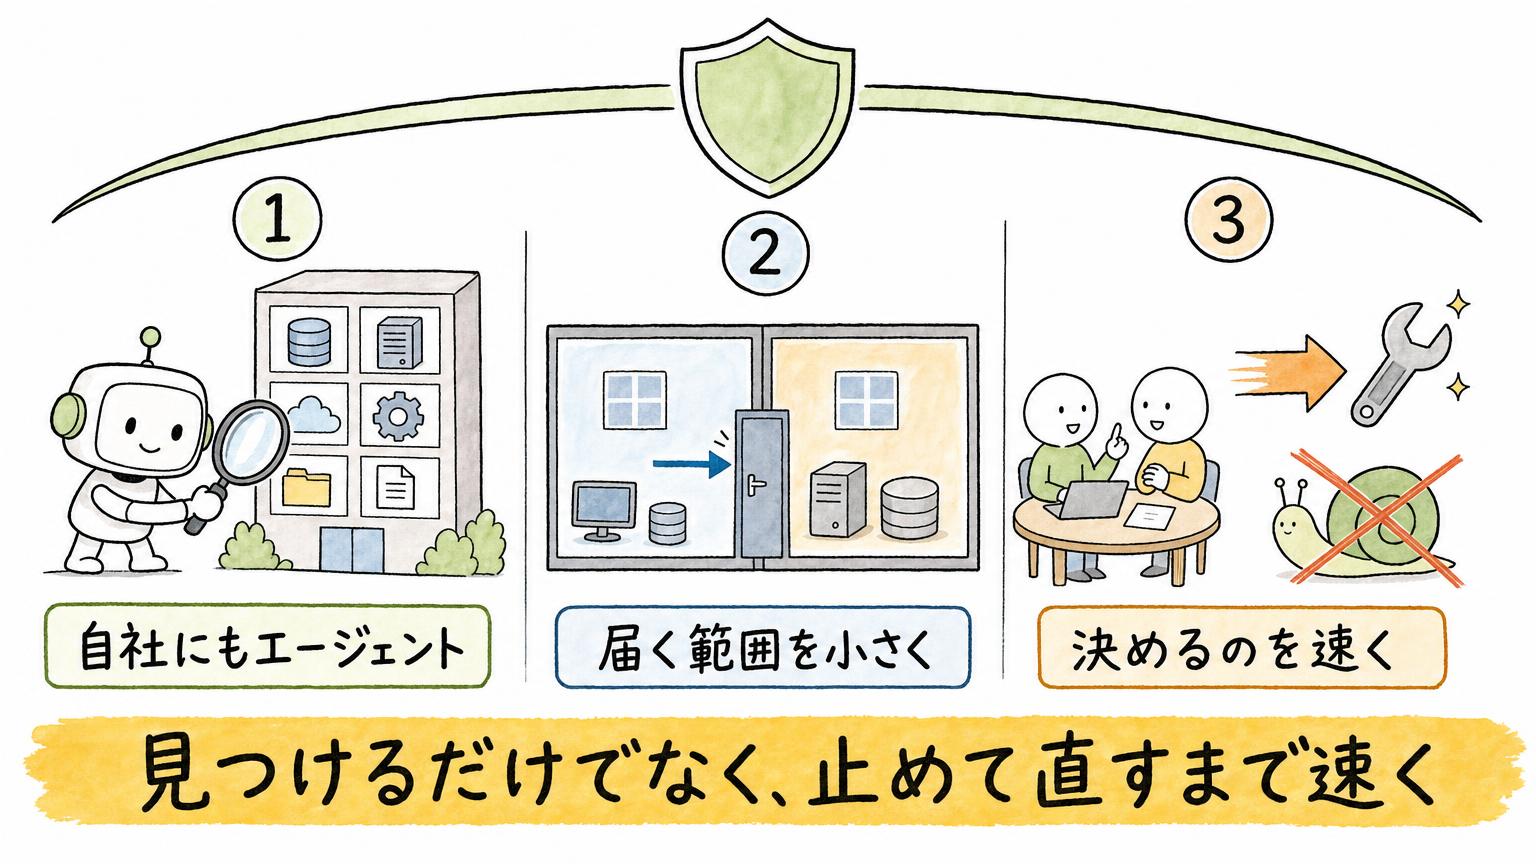
企業の対応は、いくつかあります。
AIが脆弱性の候補を大量に見つけ、再現と悪用まで繰り返せるなら、攻撃側が試せる回数は増えます。防御側が、年1回の診断、手作業の再現、月単位の修正会議という流れのままだと、入口の発見だけ速くしても、検証・優先付け・修正の段階で滞留します。新しい詰まりどころは、「見つけられるか」から「見つけたものを確かめ、止め、直せるか」に移ります。
1つ目は、自社の防御にも、エージェントを導入することです。エージェントが社内のコードやシステムを確認できれば、外から狙う攻撃者と同じ目線で自社を点検でき、システム同士のつながりといった内部の事情も見えてきます。見つかった欠陥は、そのまま修正まで進められます。
人間の対応だけで、すべてを見て回ることは現実的ではありません。よほどのセキュリティチームと予算がなければ無理です。エージェントなら、数十〜数百ドル規模の費用でも、かなりの範囲を点検できるはずです。
AIには、候補の検出、再現、影響範囲の整理、修正案の作成を任せ、人は、対象と権限の確認、重大度の判定、修正の承認を担います。
すでに道具は出ています。Claude Codeには自動セキュリティレビューがあり、コードの脆弱性を見つけ、検出後は修正の実装まで依頼できます。OpenAIのCodex Securityも、GitHubのリポジトリに接続して脅威モデルを作り、隔離環境で検証して、修正案を提案します(研究プレビュー)。
防御にエージェントを使わない企業は、無装備で戦場に突撃する竹槍の兵士に近い状況です。
2つ目は、すぐ直せない間は、届く範囲を小さくすることです。管理系と業務系を分け、外向きの通信を必要な先だけに絞り、資格情報の有効期間を短くし、重要な操作に追加の承認を置きます。欠陥を消す対策ではなく、侵入されたあとに別の資産へ移ったり、データを持ち出したりする工程を止める対策です。
Anthropicも、エージェントを動かす環境の設計で、行動を一つずつ見張るより、できることの範囲を先に絞る方針を取っています。通信は既定で拒否し、認証情報は実行環境に入れず、被害の範囲を抑えることを設計の問いにしています。
3つ目は、組織の意思決定の体制も変えることです。AIで分析したあとに、どれをどう対策し、どう直すのか。しっかり考えることは重要です。ただ、それを月1回の役員会のような速度で進めていては、攻撃側にまったく合いません。
攻撃側の速度はどんどん上がっていて、守備側の意思決定の遅さを待ってはくれません。現場の判断で、直せるものはどんどん直していける体制へ。それが必須になります。
そのために、あらかじめ決めておくことがあります。侵害の影響が大きい資産の持ち主と、停止する権限を持つ人。脆弱性の発見から封じ込めまでの連絡経路と時間の目標。そして、委託先やクラウド事業者を含めた演習です。測るものも、検出件数ではなく、発見から人の検証、暫定の封じ込め、恒久修正までの時間、つまり自社の露出時間に変えます。
セキュリティ危機が、エージェントモーメントを生む
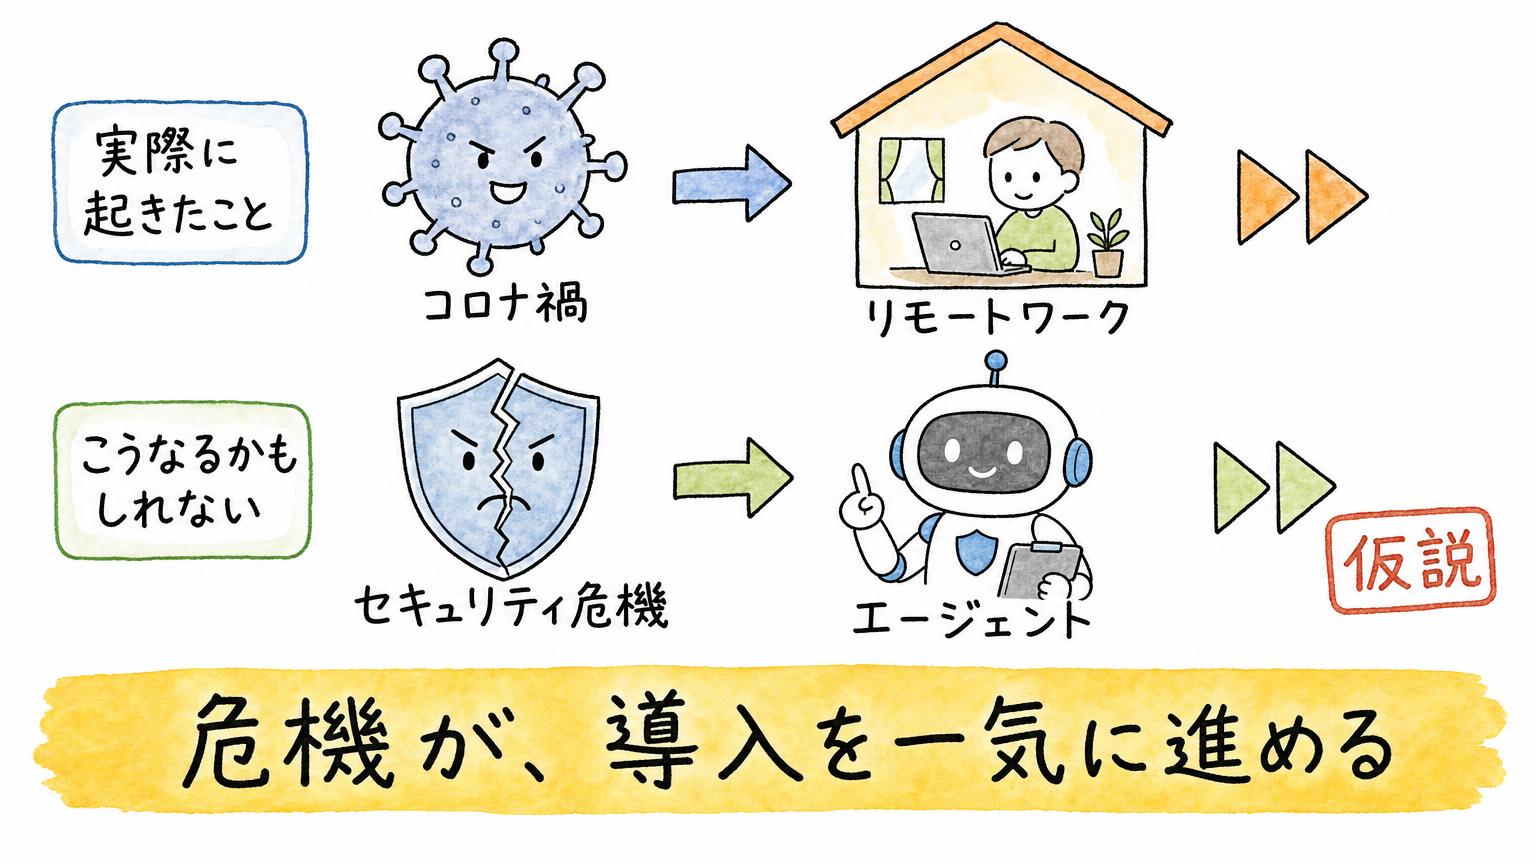
コロナ禍は、リモートワークのモーメントを生みました。マイクロソフトのサティア・ナデラ氏は2020年4月、2年分のデジタル変革が2か月で起きたと語りました。出社できないという外からの制約が、便利だが先送りできた技術を、事業を続けるための選択に変えたのです。
同じことが、サイバー脅威とエージェントの間で起きる可能性があります。攻撃の速度と入手性が上がると、防御側のエージェント導入が、「便利だから」から「事業を続けるために」へ変わる。これは確認済みの事実ではなく、仮説です。この転換点を、「エージェントモーメント」と呼ぶことにします。
防御のためには、コード、外に公開している資産、クラウドの設定、権限、運用ログを横断して見渡す必要が出ます。この接続と運用の実績ができると、開発、保守、障害調査といった次の用途の導入負担も下がります。防御で何を確認し、どの修正を承認し、結果がどう変わったかの記録は、エージェントに任せる範囲を決める材料にもなります。
ただし、必要なのは防御に関わる全体像であって、顧客データの全件や本番を変える権限を渡すことではありません。広く読む権限と、本番を変更する権限は分けます。
全社員が同時に使い始める必要もありません。経営者や少数の担当者から、会社の状態を把握して動けるエージェントの利用が広がる、という見立てです。
中小企業にとっては、大きな調査チームがなくても検査を始めやすくなる点が追い風です。分かれ目になるのは利用料金ではなく、資産の整理、接続の設定、結果の確認と修正という手間を、どこまで小さくできるかです。
出社制限のように一斉に見える制約ではないので、広がり方は、業種、被害の経験、取引先からの要求によって、段階的になるでしょう。
守備にも、エージェントを雇う時代へ
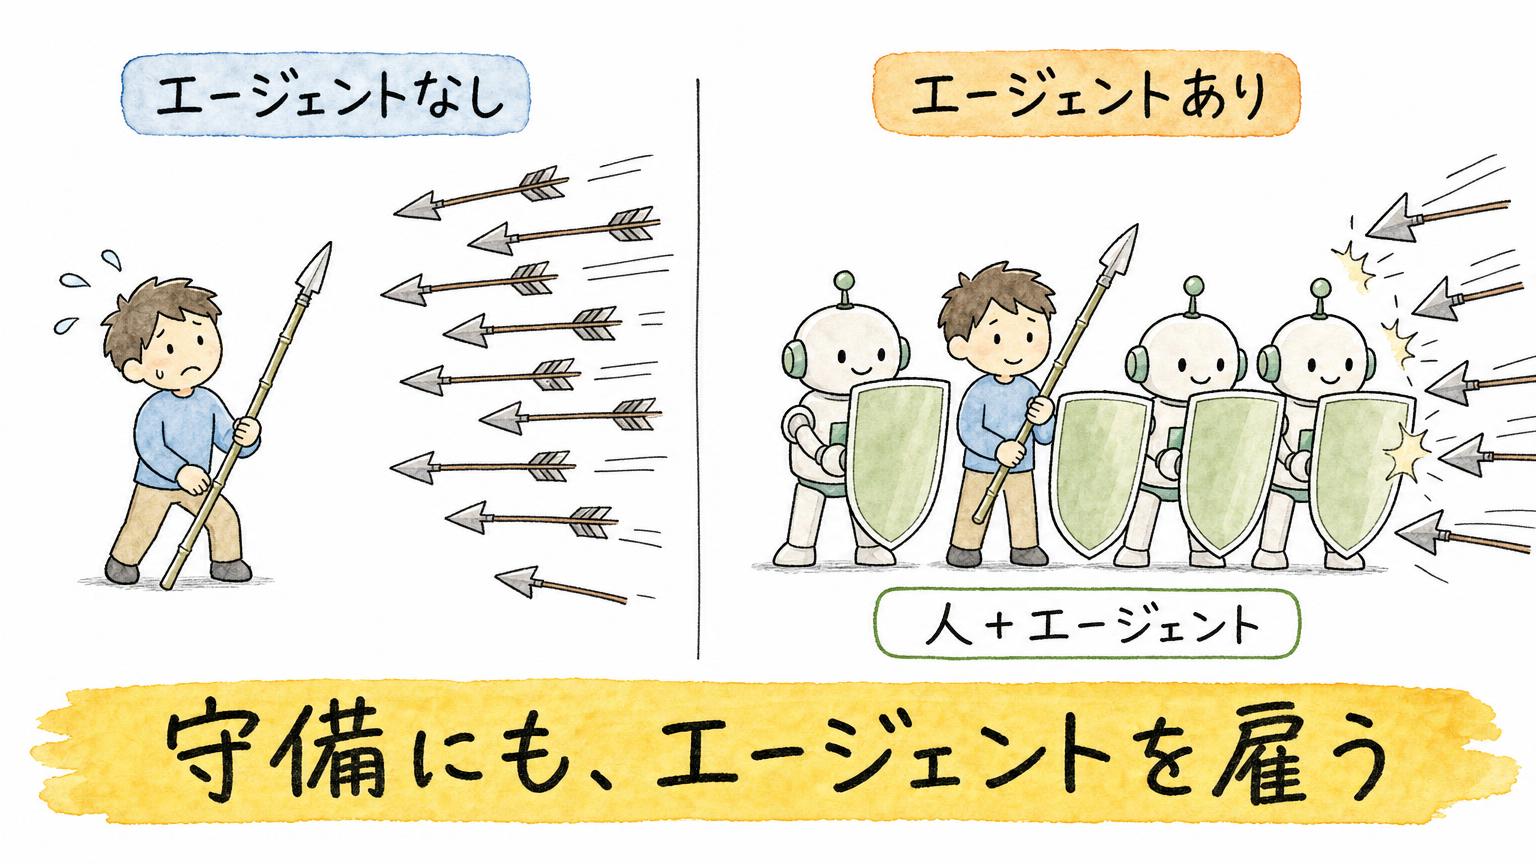
「Mythos級AI」は本当に拡散したのか。答えは、見つける力ではおおむね「はい」、深い悪用ではまだ「差がある」。そして、誰でも入手できる形になったという点では、はっきり「はい」です。
攻撃側の速度は、これからも上がります。人の手と月単位の会議だけで受け止める守り方は、すでに合わなくなりつつあります。
自分たちも守備としてエージェントを雇い、ガードの体制を整えていくこと。それが、すべての企業にとって不可欠になっていくでしょう。
よくある質問(FAQ)
Q1. GLM-5.3は本当に「Mythos級」なのか?
欠陥を見つける力では妥当です。CyberGymでGLM-5.3は84.5%、Mythos 5は83.8%でした。一方、悪用に仕上げるExploitBenchではGLM-5.3が54.4%、Mythos 5が78.0%で、深い悪用にはまだ差があります。
Q2. 公開重みのモデルは、APIで提供されるモデルと何が違うのか?
モデル本体が利用者の手元に渡る点が違います。APIなら提供者が審査・ブロック・停止を続けられますが、公開重みでは利用者が設定や保護の仕組みを変えられ、提供者はすべてのコピーを止められません。Anthropicの模擬試験では、GLM-5.3の保護を回避できた割合は64〜100%でした。
Q3. 日本企業は、防御で何から変えればよいのか?
3つあります。自社の防御にもエージェントを入れて点検から修正まで進めること、すぐ直せない間は届く範囲を小さくすること、そして月単位の会議に頼らず現場で直せる意思決定の体制に変えることです。
AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」で、変わる攻撃と防御の実務を持ち寄りながら探っています:https://frontier-leaders.vercel.app/
2時間で、AI活用術を実践のハンズオンで学べます(過去回のアーカイブ):https://handson.workstyle-evolution.co.jp/
YouTube『いけともch』では、AIニュースを毎日解説しています:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事

公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ