拡散型LLM「Mercury 3」の速さが効く場面と効かない場面——Inceptionの料金・精度を整理
- Inceptionが拡散型LLM「Mercury 3」を発表し、規模は初代の40倍超、文脈は100万トークンに広がりました。
- 速度は毎秒1,068トークンでほぼ横ばいですが、精度が上がり、人が結果を待つ場面で速さが効きます。
- 通常料金は入力0.20ドル・出力0.70ドルで、割引を外して見る必要があり、課題で勝ち負けも入れ替わります。
10月19日、Inceptionが拡散型の言語モデル「Mercury 3」を発表しました。拡散型とは、文章を一語ずつ左から書き進めず、粗い下書きをブロックごとに並列で書き直して仕上げる方式です。
規模は初代の40倍超、文脈は100万トークンになりました。速度は毎秒1,068トークンです。
では、この速さは仕事のどこで効くのか。答えは、人が結果を待っていて、何度も確かめたい場面です。僕も自分用のニュース分析アプリに入れて、日々使っています。
拡散型の現在地:規模・文脈・速度
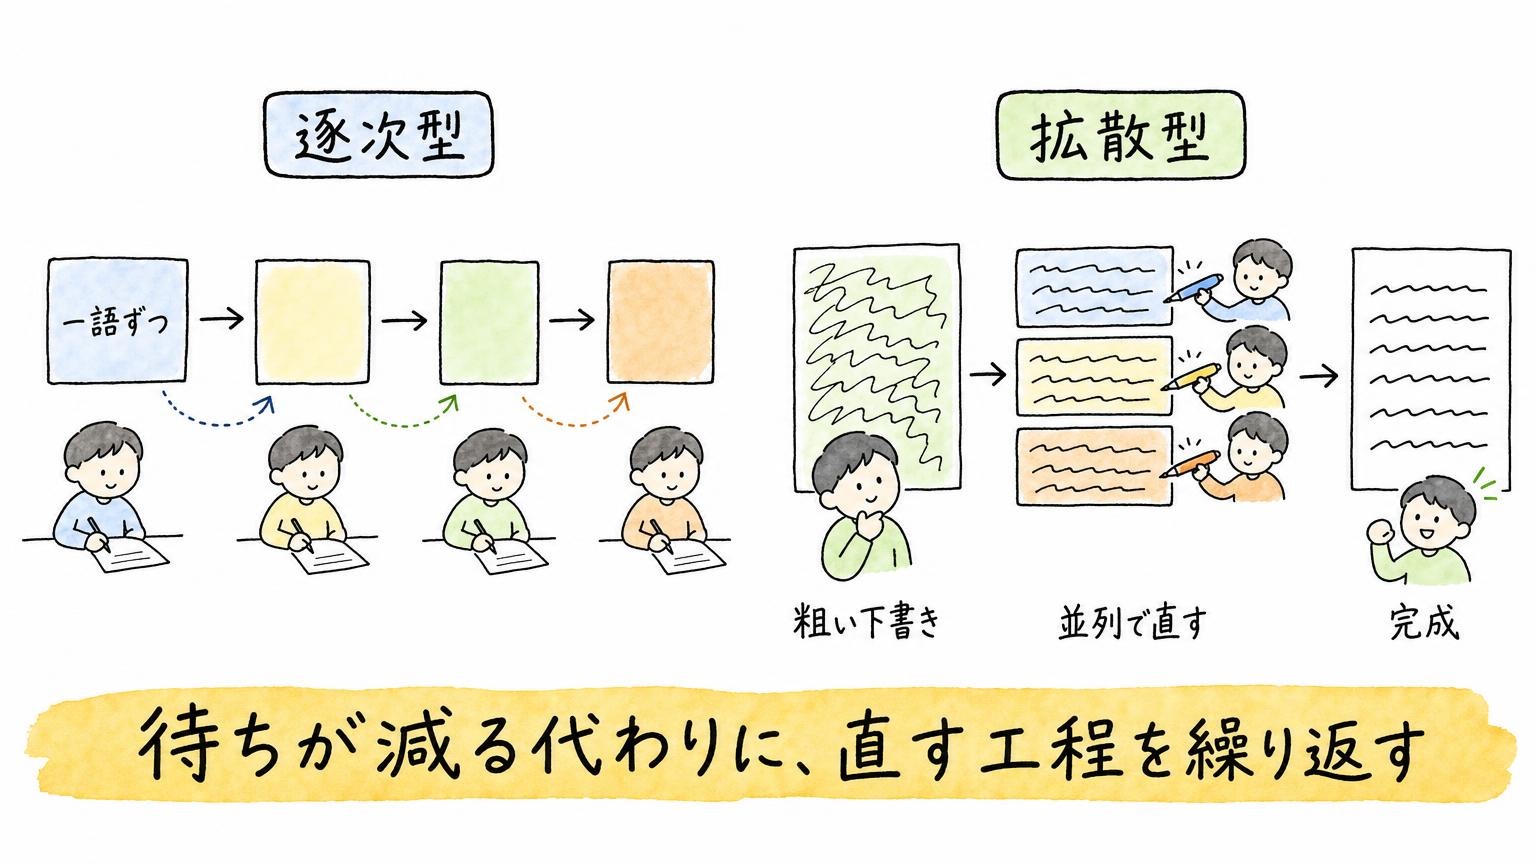
逐次型のモデルは、直前の一語を確定させてから、次の一語を予測します。拡散型は、粗い出力を作ったうえで、複数の箇所をまとめて何度も直します。待ちが減る代わりに、直す工程を繰り返すのが特徴です。
▶︎ あわせて読みたい:Mercury 2.5は何ができたのか——拡散型の仕組みと弱点を整理した前の記事
Mercury 2.5からの更新は、速さの上積みではありません。速度は毎秒1,107から1,068トークンへ、ほぼ横ばいです。
変わったのは精度です。前の版は速くても粗すぎて、実務では使いにくい印象でした。今回は、文章でも、スライドなどのアウトプットでも、それなりの品質が出ます。
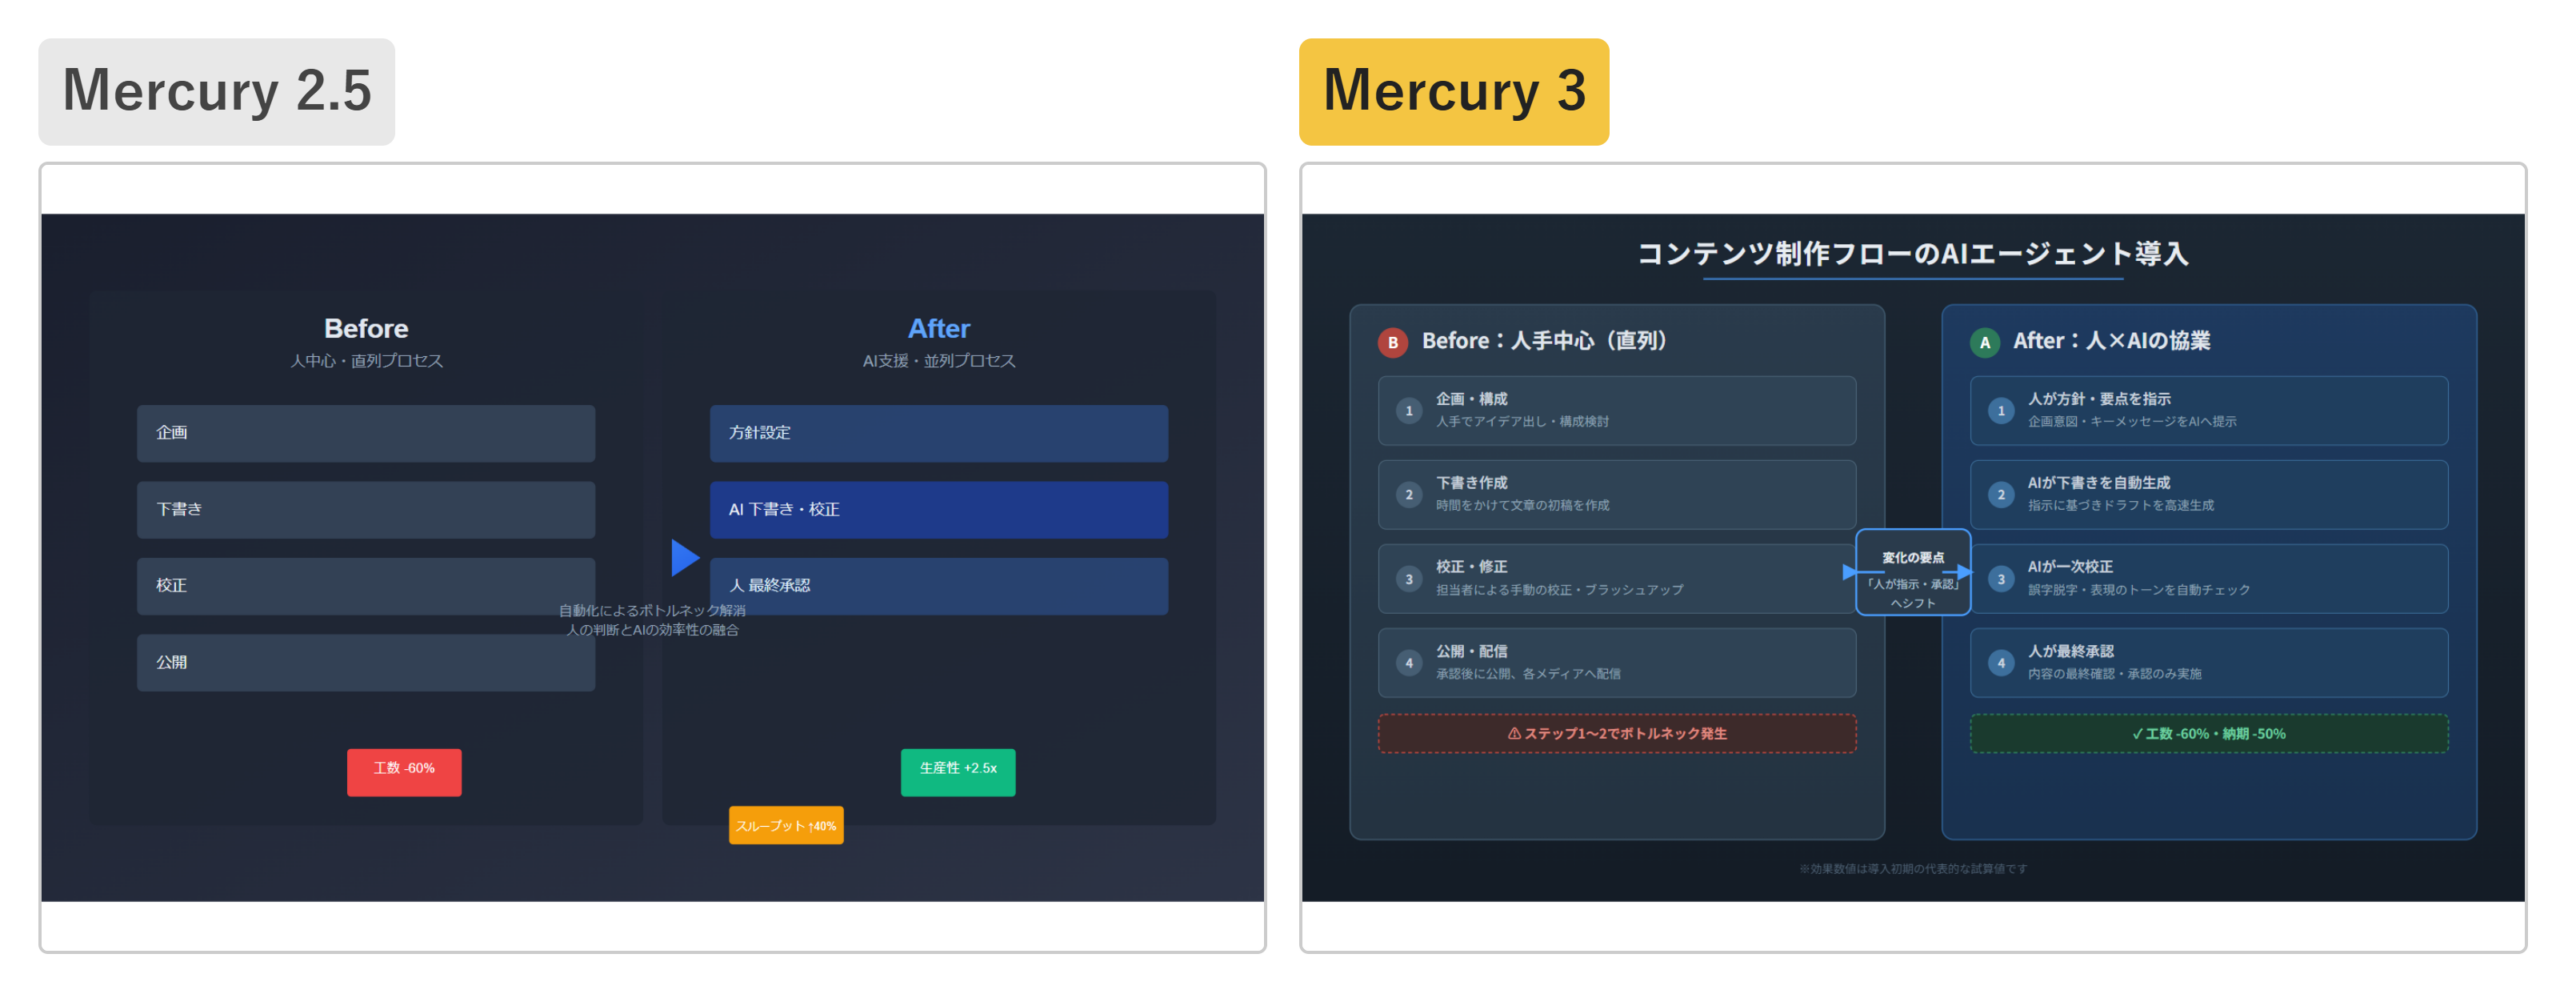
▲ 左がMercury 2.5、右がMercury 3の出力(課題:ビフォーアフターの図)
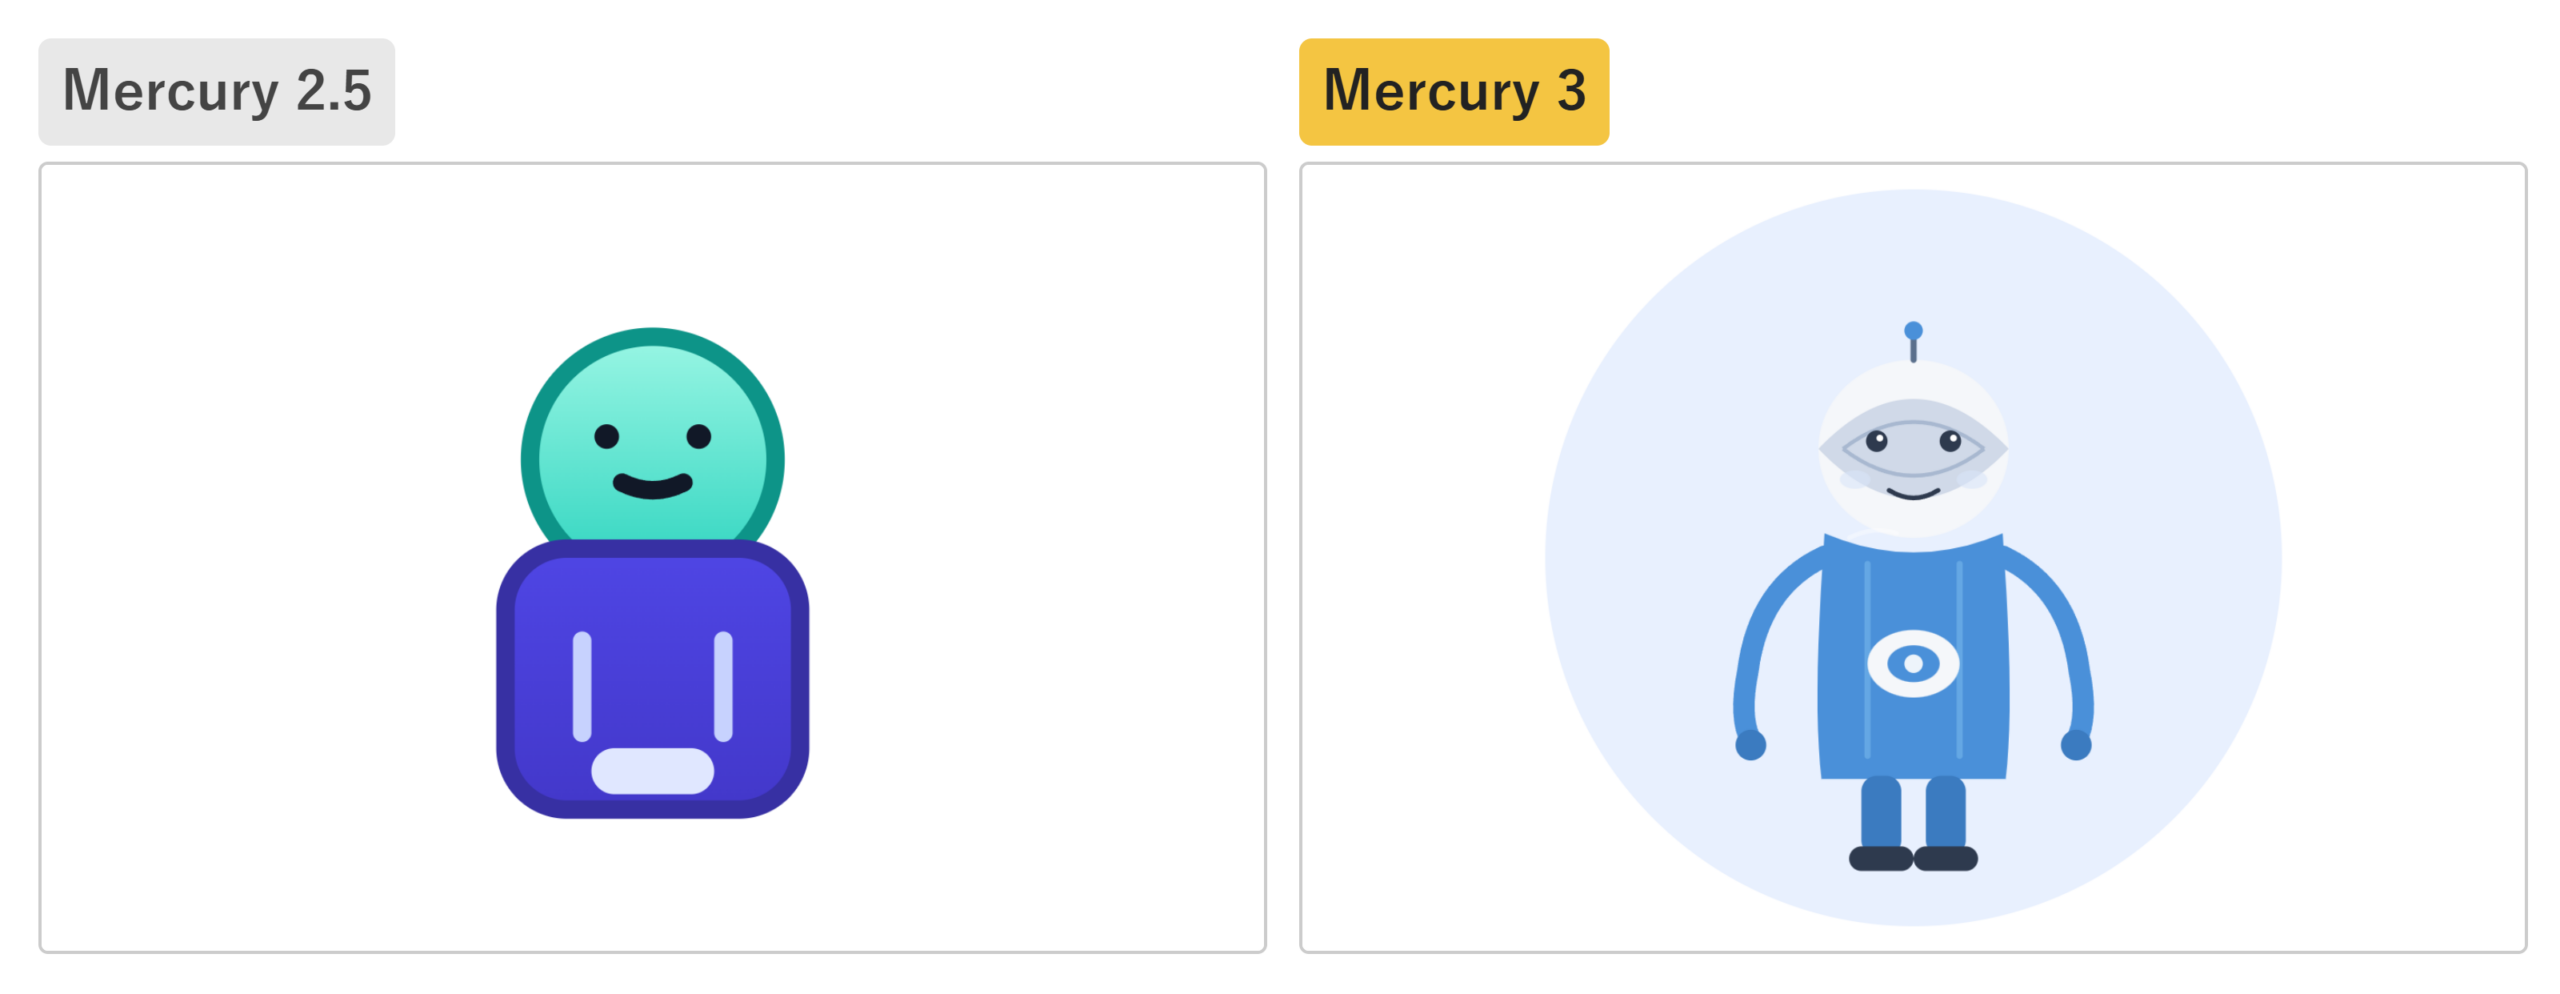
▲ 同じく、課題はロボットのアイコン。2.5は下端が切れ、3は頭から足まで収まっています
どちらも、AIモデルの比較ツールに残っている一回の出力です。Mercury 3にも文字の重なりなどの粗は残りますが、前の版よりは、手直しして使える形に近づいています。
枠も広がりました。文脈は26万から100万トークンへ約4倍になり、出力できる量の上限も倍になりました。速さを保ったまま、精度と扱える仕事を広げた更新です。
使い方は、Inception自身のAPIのほか、OpenRouterなど複数のサービスから、OpenAI互換のAPIで呼べます。
競合との比較:勝つ課題と、負ける課題
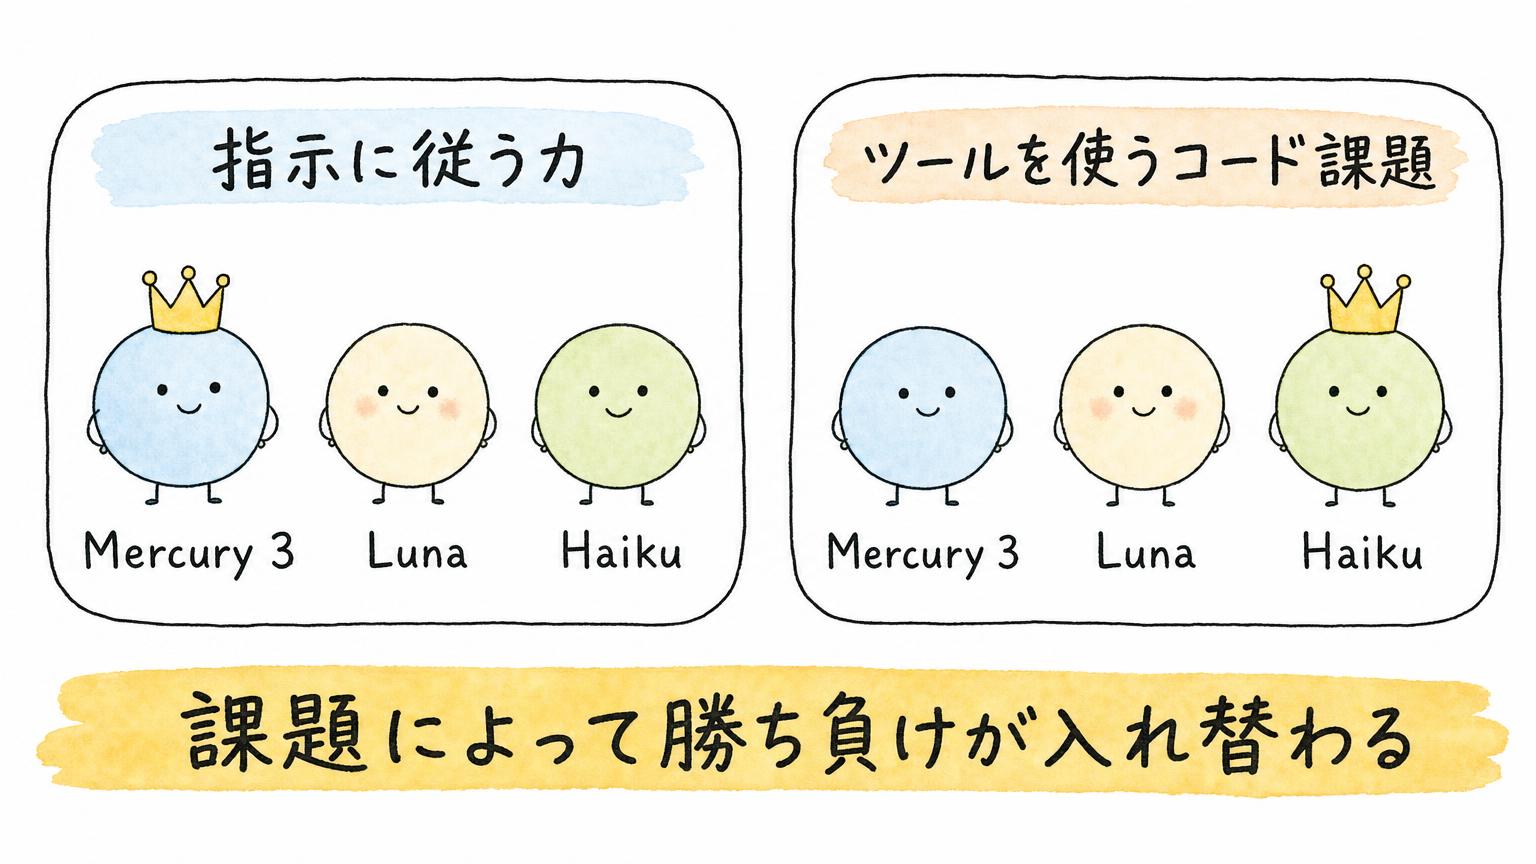
Inceptionは、GPT-6 LunaとClaude Haiku 5.5との比較を、3つとも同じ設定で出しています。数字はInceptionが自社で測った値です。
指示に従う力のテストでは、Mercury 3が約77%、Lunaが約62%、Haikuが約55%でした。
実際のコード課題を解くテストや、検索のテストでも、LunaとHaikuの両方を上回っています。
一方、逆転する課題もあります。ツールを使いながらコード課題を最後まで解くテストは、Haikuが上です。長文から必要な情報を取り出すテストも、LunaやHaikuが上回る項目があります。
小さくて速いモデルの中では、指示に従う力と実際のコードで頭ひとつ抜けている一方、課題によって勝ち負けが入れ替わる。これが比較の読み方です。
「4〜8倍速い」という表現にも注意が要ります。これは生成速度の比で、仕事全体の完了時間の比ではありません。
速さが効く場面:待たずに確かめる使い方
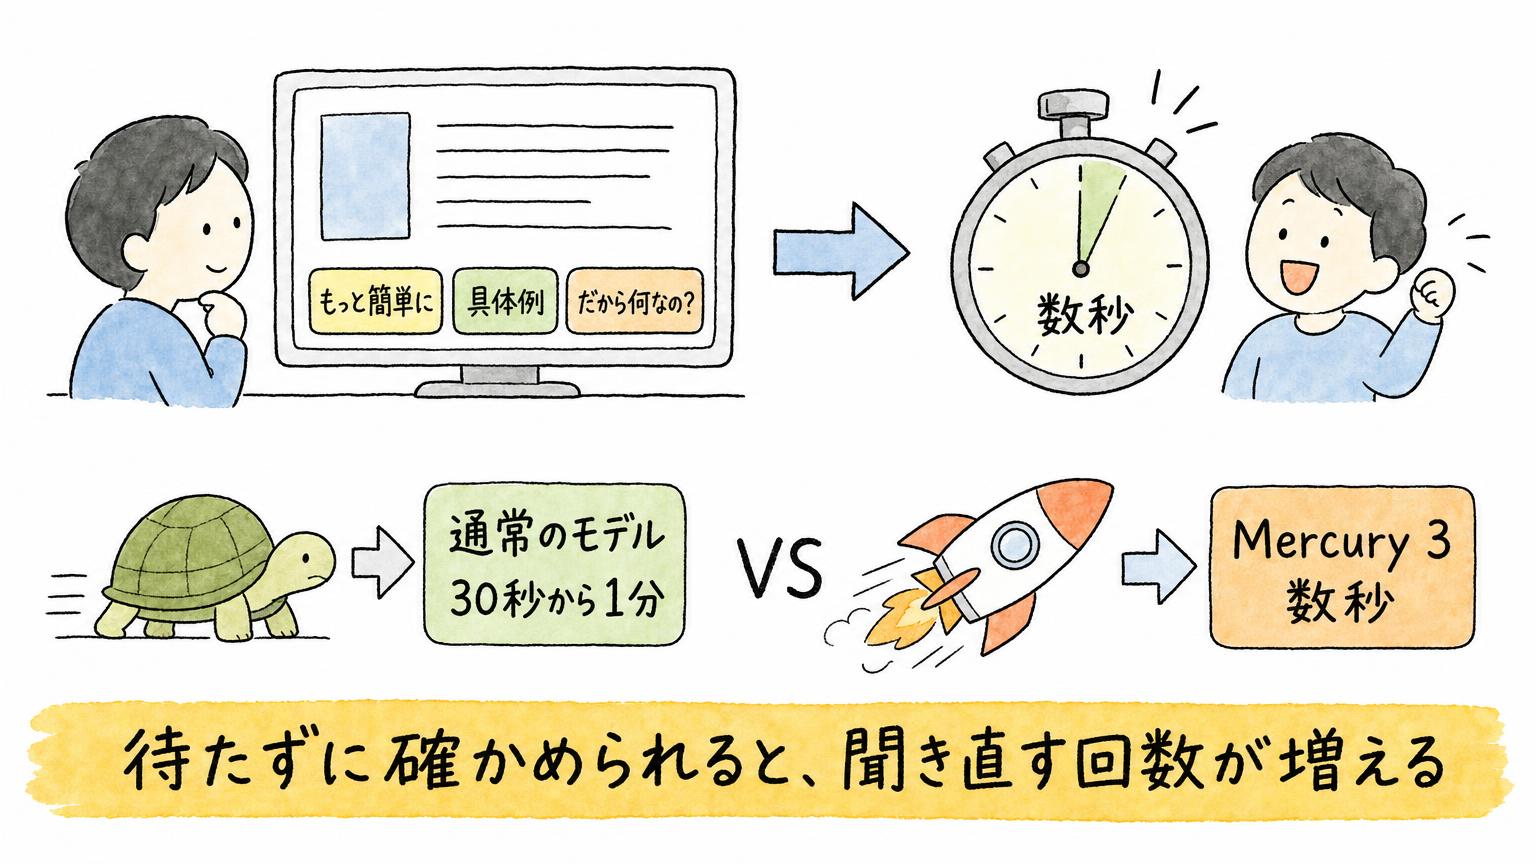
効くのは、一回の応答が速くなって、確かめる動作を何度も重ねられる場面です。
僕は自分用のニュース分析アプリに、Mercury 3を使った三つのボタンを付けました。解説を読んでいて気になる箇所で押せる、「もっと簡単に」「具体例」「だから何なの?」です。
押すと、数秒で回答が返ります。「具体例」は、先にウェブ検索をしてから文章を作りますが、それでも待たされません。通常のモデルで検索つきの回答を作ると30秒から1分かかるので、読みながら気軽には押せませんでした。
前の版では、レベルが低すぎて使えませんでした。今回は、さすがにLunaには及ばないものの、妥当な内容が出てきます。パッと使う用途なら実用に耐える水準です。
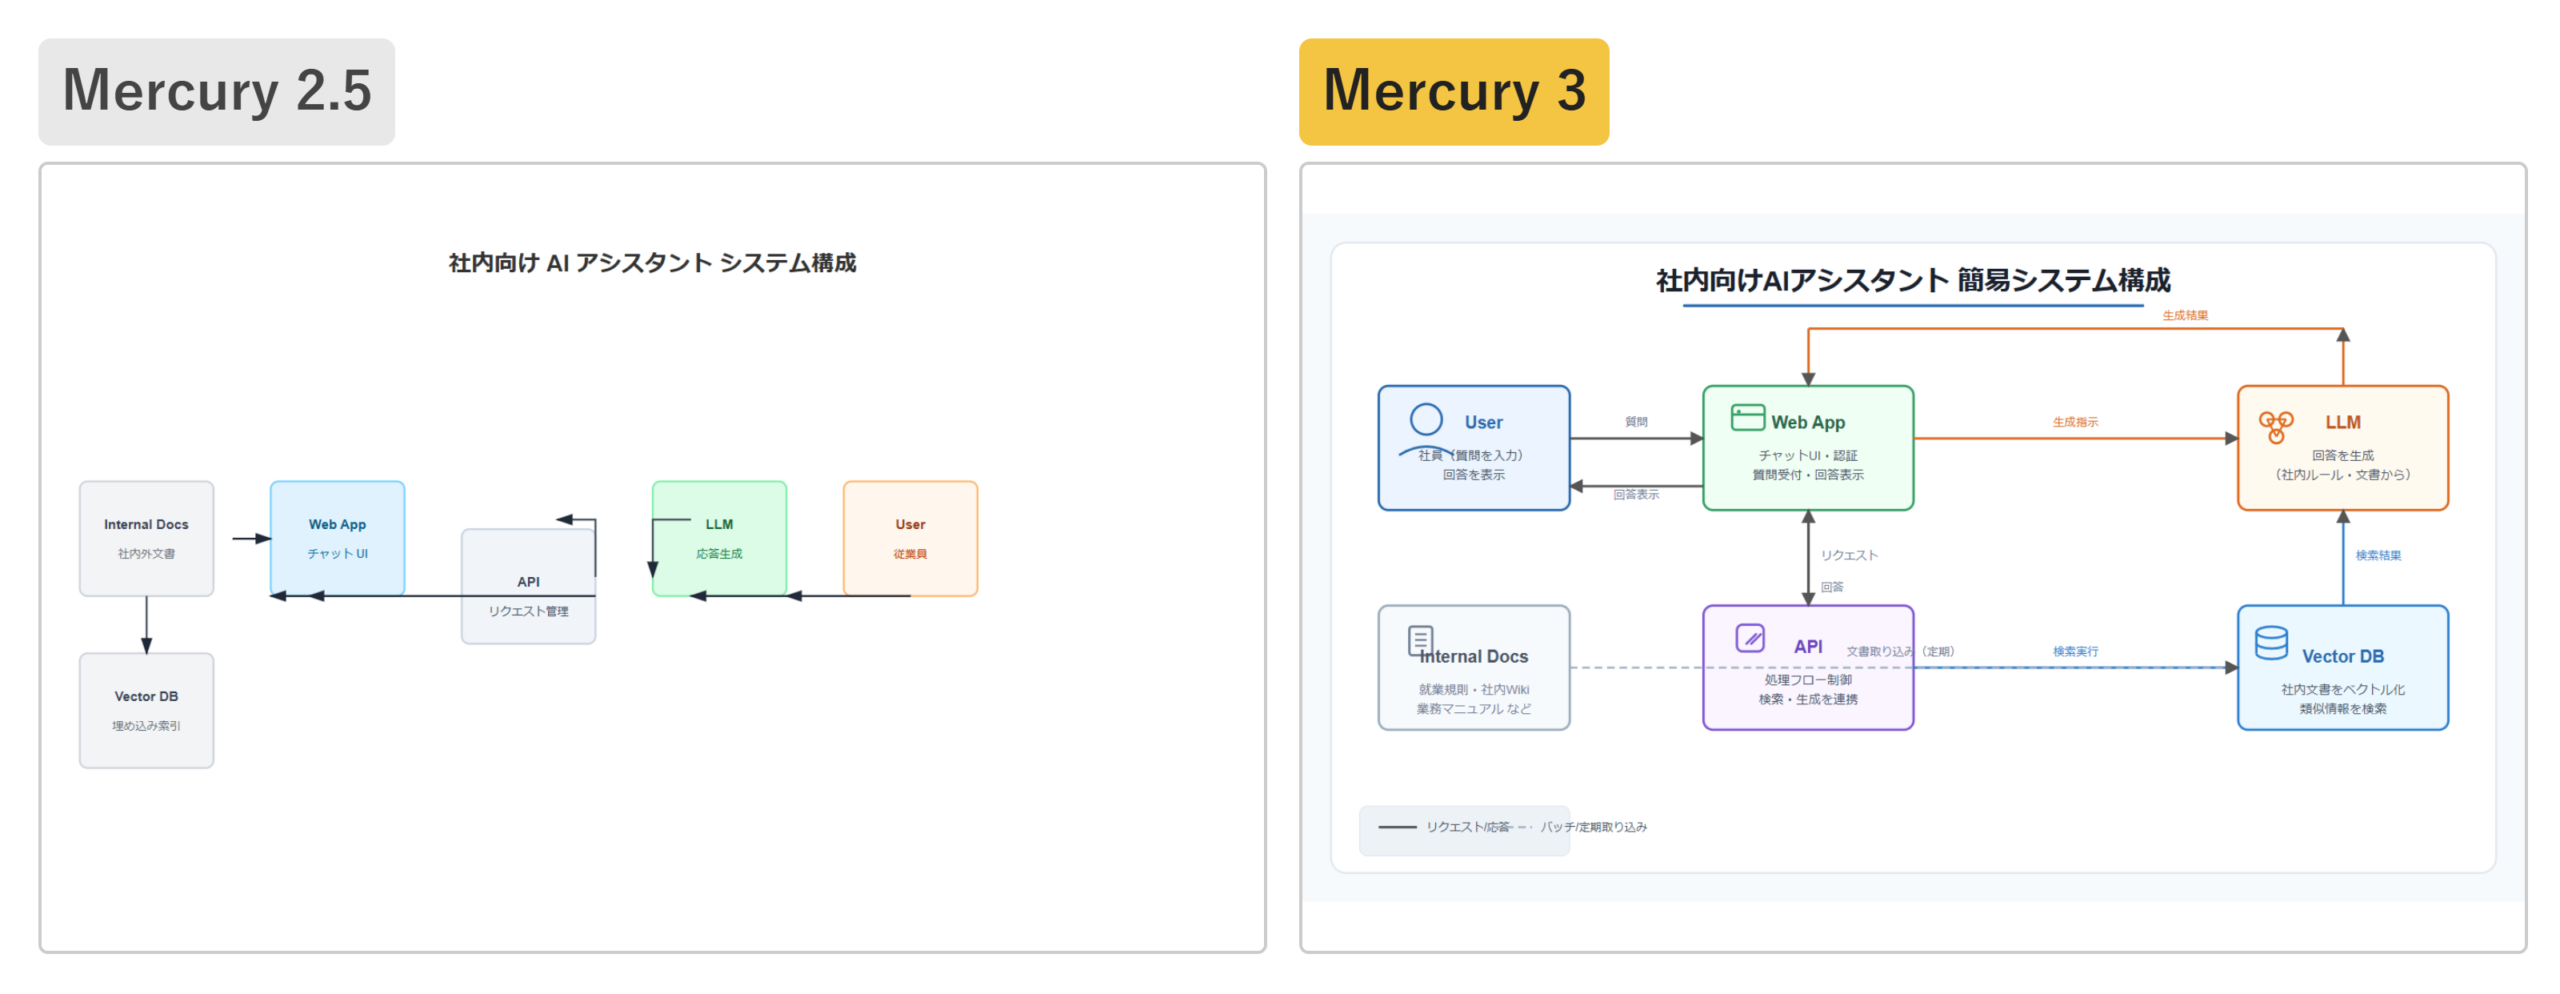
▲ 左がMercury 2.5、右がMercury 3の出力(課題:システムの構成図)
しかも、めちゃくちゃ速く表示されます。情報を集める途中の「考える待ち時間」がなくなり、確かめられることが広がったと感じています。
学習アプリのRevisionDojoも、ヒントや採点結果が約1秒で返ると説明しています。人が画面の前で結果を待つ仕事で、速さの価値が出ています。
速さが効かない場面:時間をかけて任せる仕事
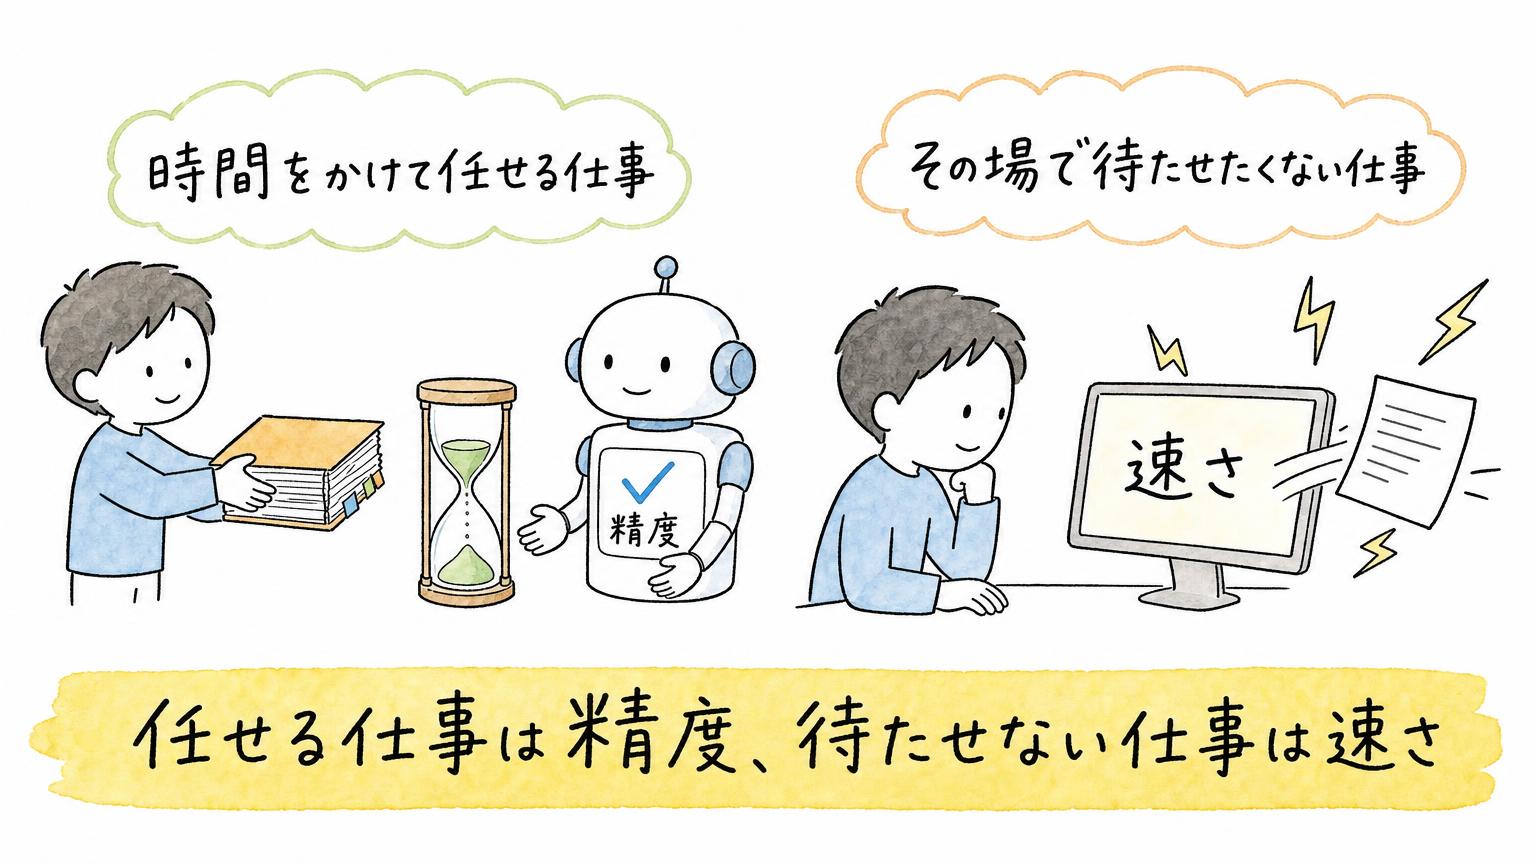
逆に、ある程度時間をかけて任せてよい仕事では、速さより精度が大事です。
長い資料を扱う仕事が、その典型です。100万トークン入ることと、必要な情報を正確に取り出すことは、別の話です。資料を丸ごと渡す方法と、関係箇所だけを検索して渡す方法を、同じ正解条件で比べるのが確かです。
コード課題でHaikuが上だったように、やり直しが増えると、完了までの時間は逆転します。一回の生成が速くても、最終の成功までの時間で見る必要があります。
一方、リアルタイムでパッと処理したい場面では、拡散型の重要度が高くなります。任せる仕事は精度の高いモデルに、待たせたくない仕事は拡散型に。この使い分けが現実的です。
料金と移行:割引を外して見る数字
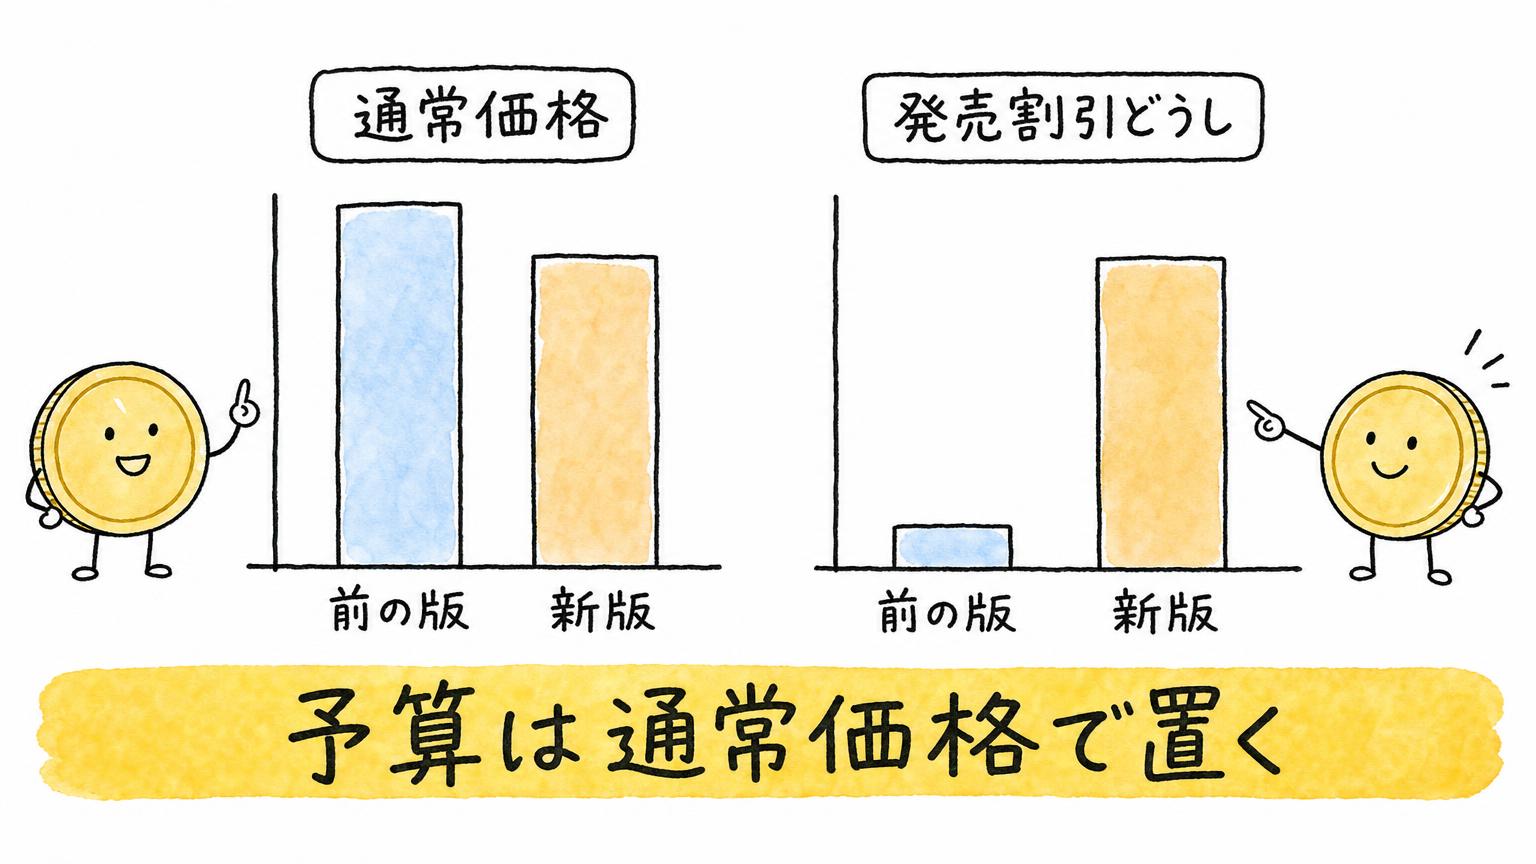
通常料金は、100万トークンあたり入力0.20ドル、出力0.70ドルです。発売記念で当面は半額ですが、終了日は発表されていません。
前の版と通常価格で比べると、出力が少し安くなっています。ただし前の版は、発売時に80%引きでした。割引同士で比べると、新版のほうが高いことになります。継続の予算は、通常価格で置くのが安全です。
▶︎ あわせて読みたい:呼ぶ回数が多い処理に軽量モデルを置く——Haiku 5.5の3つの使い所
移行では、推論の既定値に注意してください。前の版は中程度のmediumですが、新版は、軽めのlowが既定です。モデル名だけを替えると、推論の量も変わります。
旧版は新規提供が終わり、10月19日より前から使っていた人は、11月15日まで使えます。期限内に、切り替えを済ませる必要があります。
結び:速さを活かす線引き
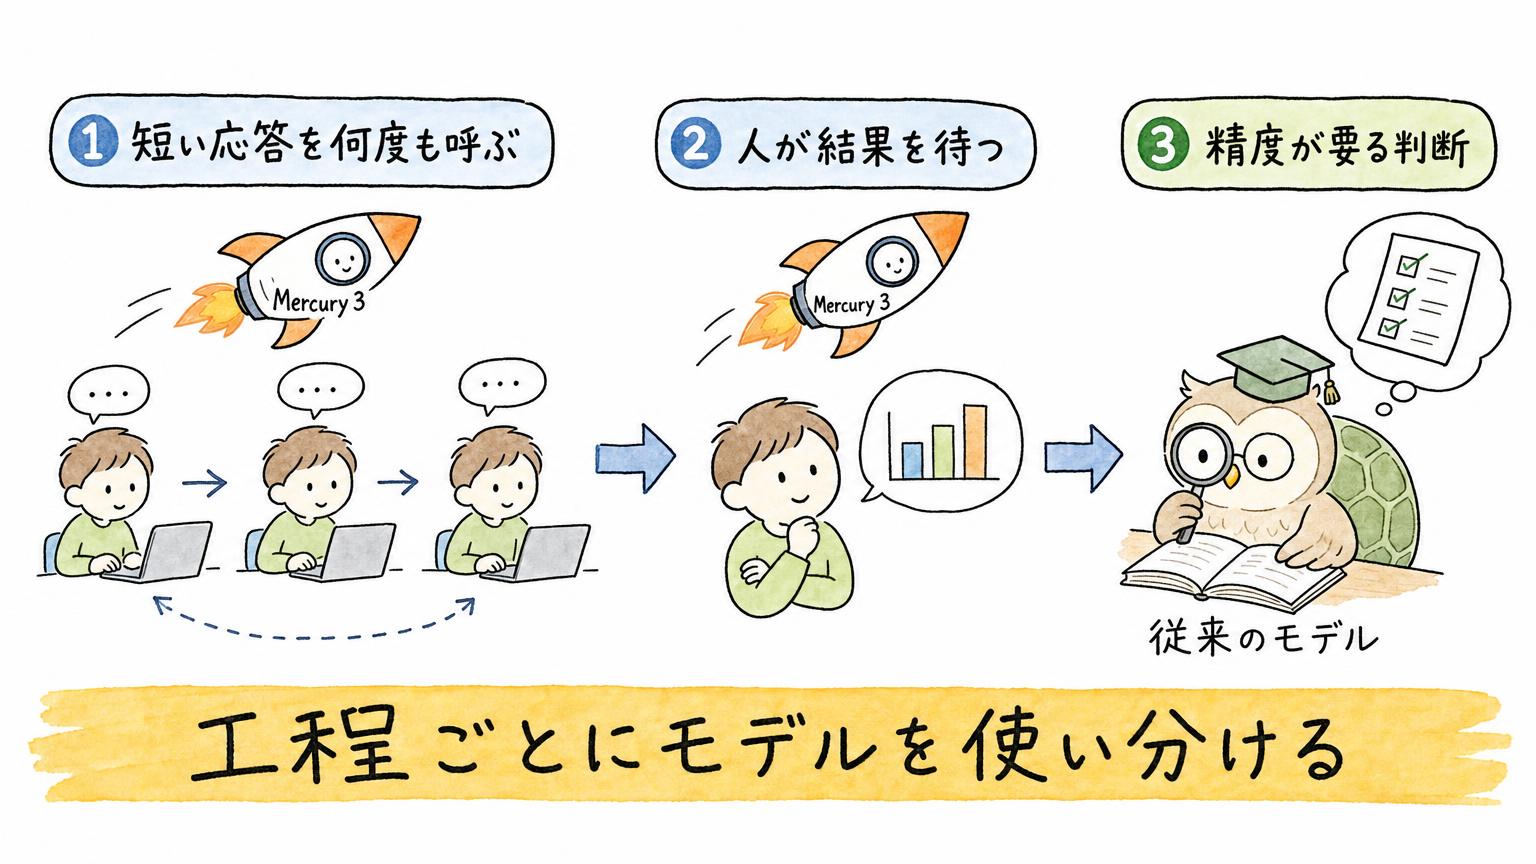
速いモデルが仕事を変えるのは、答えの質より、確かめる回数です。数秒で返る道具があると、人は気になった時点で聞き直せます。
全部をMercury 3に任せる必要はありません。人が待つ工程と、短い応答を何度も呼ぶ工程から任せ、精度が要る判断は従来のモデルに残す。この線引きが、使い方の核心です。
拡散型は「速いが粗い」という見方を、更新する段階に来ました。待ちが成果を左右する工程から、じわじわと広がっていくでしょう。使う側は自分の処理で速さと成功率を測り、アプリを作る側は、速さを「待たせない画面」に変える設計が問われます。
よくある質問(FAQ)
Q1. Mercury 3の速さは、どんな仕事で効きますか?
人が結果を待っていて、何度も確かめたい場面です。筆者の自分用ニュース分析アプリでは、Mercury 3を使った3つのボタンが数秒で回答を返します。通常のモデルで検索つきの回答を作ると30秒から1分かかるので、読みながら気軽には押せませんでした。
Q2. Mercury 3の料金はいくらですか?
通常料金は、100万トークンあたり入力0.20ドル、出力0.70ドルです。発売記念で当面は半額ですが、終了日は発表されていません。前の版は発売時に80%引きだったため、割引同士で比べると新版のほうが高くなります。継続の予算は通常価格で置くのが安全です。
Q3. 前の版(Mercury 2.5)から移行するときの注意点は?
推論の既定値が、前の版の中程度のmediumから、新版では軽めのlowに変わります。モデル名だけを替えると、推論の量も変わります。旧版は新規提供が終わり、10月19日より前から使っていた人は11月15日まで使えます。
AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」。新しいモデルを、自分の仕事に組み込んで確かめる場です:https://frontier-leaders.vercel.app/
2時間で、自分専用のアプリをAIで作る実践ハンズオン(過去回のアーカイブ):https://handson.workstyle-evolution.co.jp/
Mercury 3の実演も入れた、週次のAIニュース解説動画(YouTube『いけともch』):https://www.youtube.com/watch?v=cWnuhBXVWeQ&t=1069s
■合わせて読みたい
■関連記事
人気記事RANKING
-

【初心者向け】Stable Diffusionをローカルで使う方法完全ガイド|テキストから画像生成を自分のパソコンで始める手順
-

PHP重大脆弱性2件の更新対応と、裏側でAIが担った役割:個人と企業が整えるべき備え
-

Rakuten AIを実際に使ってみた感想:商品検索の速度と連携機能を徹底レビュー
-

Copilot Studio VS Code拡張機能で業務効率化を実現!開発者向けライブコーディング環境の導入と活用法
-

DeNA「AI活用100本ノック」の中身を9パターンに分類|職種別の使いどころ
カテゴリー
- 主要AIサービス (114)
- 画像生成AI (86)
- 動画生成AI (114)
- 音楽・音声生成AI (28)
- AI開発・効率化ツール (153)
- AIのビジネス活用 (197)
- 教育×AI (19)
- AIの知識&トレンド (222)
- いけともサブチャンネル (420)
- AIエージェント時代の働き方 (1)
タグ
Agent V3
AI字幕
AI字幕ツール
Alibaba
Amazon Seller Assistant
Amazon Seller Central
AP2
ATOS
ByteDance
CAG
Cognition AI
Comscore
cotomi Act
DAW
DevOps
Gemini Advanced
GUGA
HeyGen
HunyuanImage
HunyuanImage-2.1
IndexTTS2
JR東日本
NEC
OpenAI Platform
Oracle
Perplexity Search API
Qwen3-Next
Replit
SeeDream
SongBloom
Stargateプロジェクト
Suno Studio
Thinking Machines
インコンテキストラーニング
カスハラ
コネクタ
ステム分離
ソフトバンクグループ
データセンター
パナソニックコネクト
事故対応
動画解析AI
暗黙知
決定論性
鉄道運行管理
公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ