
Claude Fableに研修一式を丸投げ、約6時間で仕上がった実例と公式の2つの数字
- Fable 5.2は、外注案件の納品水準を測る評価で約41%と、Opus 5.5の約2倍に伸びました
- 研修一式を丸投げしたところ、約6時間で85〜90点の成果物が出て、任せる単位が一件まるごとに広がりました
- 約41%は6割近くがまだ届かない数字でもあり、確認方法を決めて人が検収する前提は変わりません
AnthropicのAI「Claude」の新しいモデル「Fable 5.2(フェイブル)」が、11月9日に発表されました。公式の比較表では、他のモデルより飛び抜けて高い数字が2つあります。1つは、仕事を納品できる水準まで仕上げる力を測る「Remote Labor Index(リモート・レイバー・インデックス)」。もう1つは、ロボットの操作を試す「RoboDojo(ロボドージョー)」です。
どちらも、作って終わりではなく、確かめて、うまくいかなければやり直す力が問われる評価です。その力が伸びると、AIに頼める仕事の単位が変わります。手順を細かく渡す作業から、一式をまとめて任せる「丸投げ」へ。
実際に、研修の材料を一括で渡してみたところ、約6時間で最後までやり切り、手応えは85〜90点でした。スライドを作るだけでなく、デモを動かして確かめ、直すところまで含めた依頼です。
発表の要点と得意・不得意
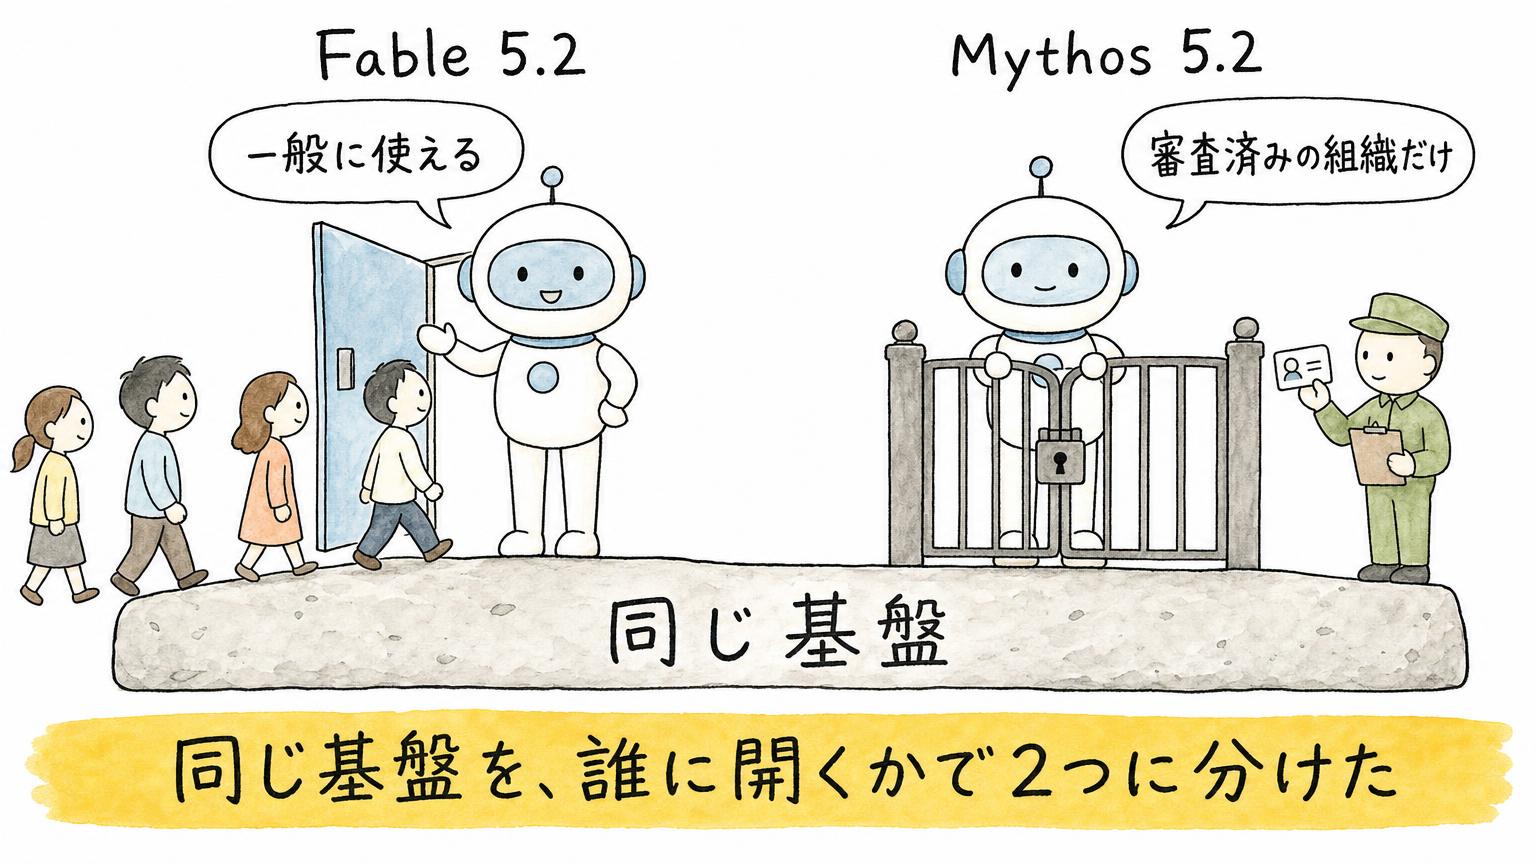
Anthropicの公式発表によると、Fable 5.2は、一般に使える最上位モデルです。同じ基盤から、サイバーや生命科学の用途を審査した組織だけに開く「Mythos 5.2」も、同時に出ています。違いは賢さではなく、誰にどの仕事まで開くかです。
得意不得意も、公式の表に出ています。コード修正の評価では首位ですが、業務フローを操作する評価ではGemini 4 Carbonが上でした。最上位だから全部で勝つ、という話ではありません。
突き抜けた2つの数字
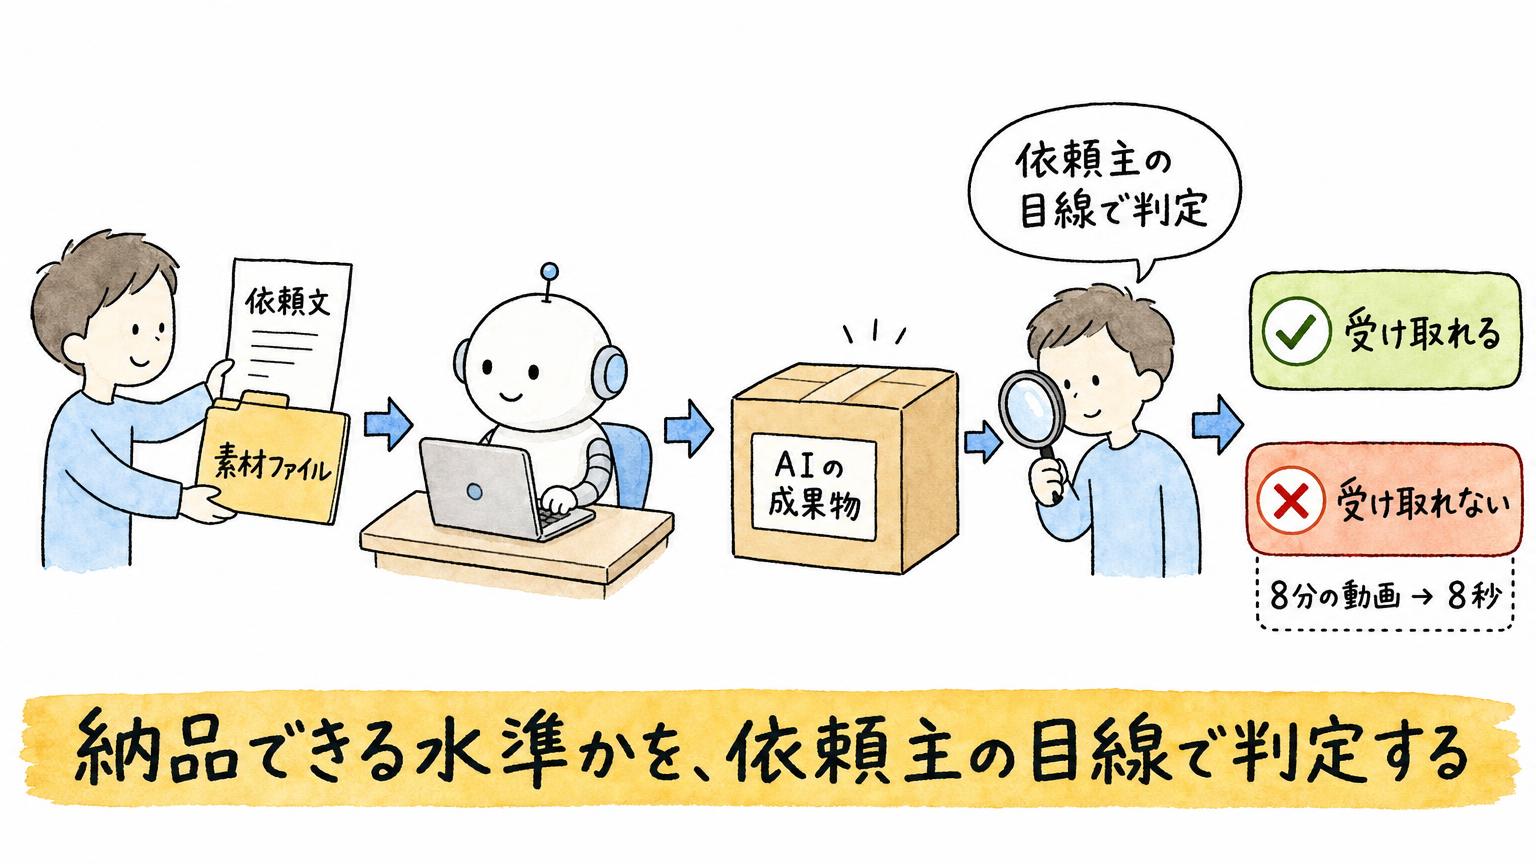
公式の比較表で差が大きかったのは、次の2つの評価です。
「Remote Labor Index」は、フリーランスの市場から集めた実際の外注案件で、依頼主がそのまま受け取れる水準かを判定します。論文によると、人間が1件にかける時間の中央値は約11.5時間。ゲーム開発、動画、立体モデルの制作など、一件ずつが重い仕事ばかりです。
たとえば、レトロゲーム用の効果音づくり、広告やロゴの制作、手描きのスケッチをもとにした間取り図、といった依頼です。1件は、依頼文、渡された素材のファイル、人間の専門家が作った納品物の3点でできています。AIの成果物は、人が「合理的な依頼主なら、その仕事として受け取れるか」を見て判定します。論文には、8分の動画を頼んだのに8秒の動画が返る、指定のスケッチと合わない間取り図が出る、といった失敗の例が載っています。
- Fable 5.2:約41%
- Opus 5.5(オーパス):約21%
- GPT-6 Astra:約21%
- Fable 5.1:約18%
「RoboDojo」は、カメラ画像を見ながら模擬の2本腕ロボットを操作し、課題を達成する評価です。Anthropicが最大の設定で、社内で走らせた数字を公表しています。
- Fable 5.2:約65%
- Opus 5.5:約39%
- GPT-6 Astra:約30%
- Fable 5.1:約28%
2つに共通するのは、一発で当てる力ではなく、見て、動かして、うまくいかなければやり直す力でしょう。RoboDojoは模擬環境の話で、事務仕事の成績ではありません。
とはいえ、約41%は、6割近くの案件はまだ納品水準に届かないという数字でもあります。
実例:研修一式の丸投げ
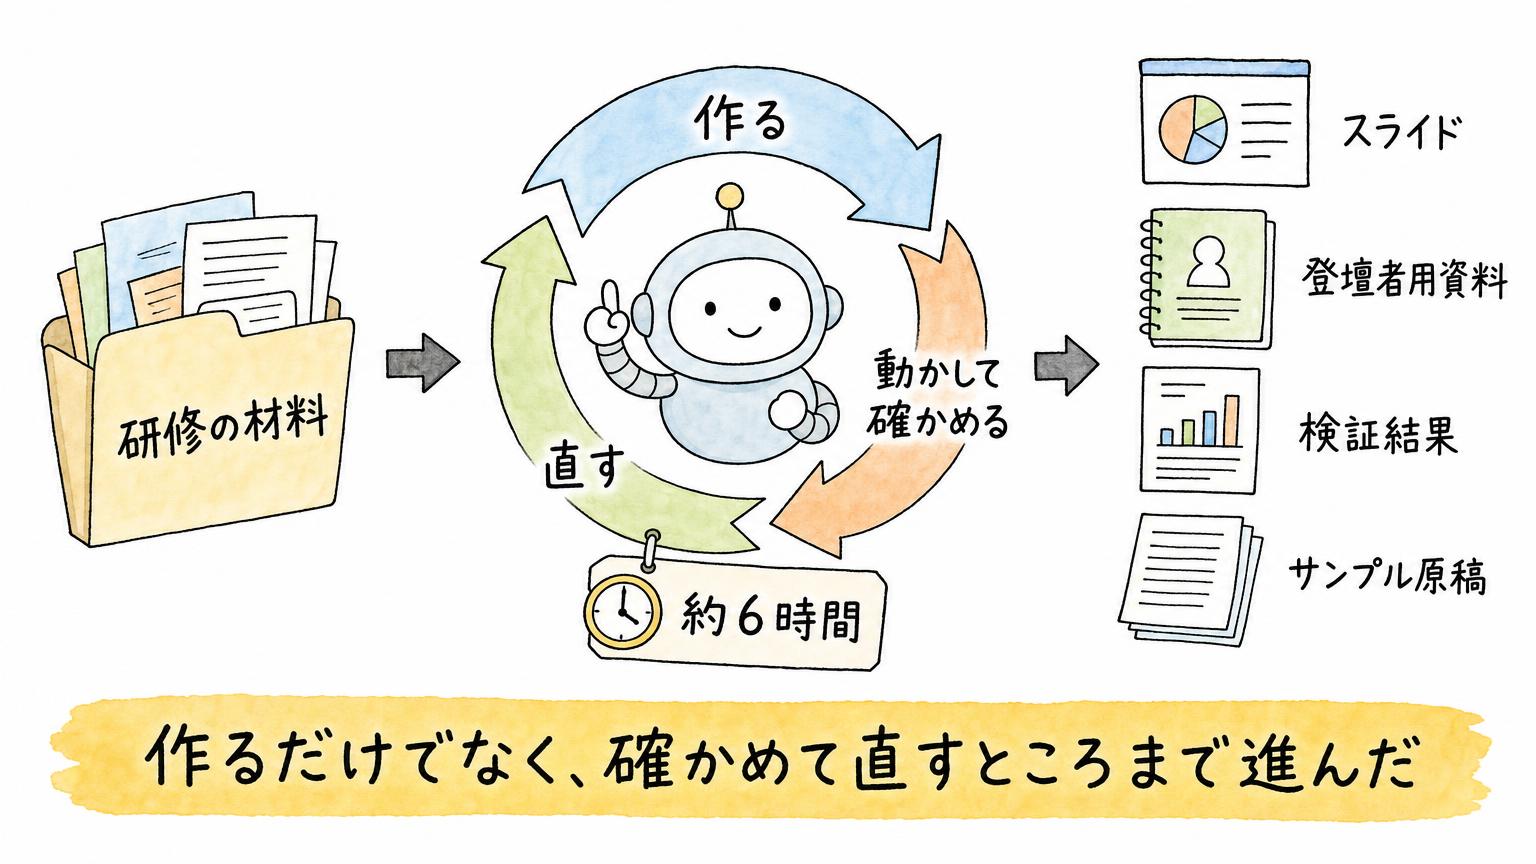
数字は、実際の手応えと同じ方向を向いていました。
研修の材料を、そのまま一括で渡してみました。頼んだのは、スライドだけではありません。デモ用データの用意から、ブラウザでの実行・検証、画面キャプチャ、問題の修正まで頼みました。
Fable 5.2は、約6時間かけて、完了まで進めてくれました。届いたのは、スライドに加えて、登壇者用の資料、スライドの検証結果、サンプル原稿の数々です。感覚としては、85点から90点。
大きいのは、スライドの出来そのものより、AIが確かめて直す作業まで進めたことです。
7月に前の最上位モデルの使い方を書いたとき、「10回のやり取りより1回の丸投げ」と整理しました。今回は、その丸投げの単位が、作業から一件まるごとへ広がった印象です。
▶︎ あわせて読みたい:Claude最強AI「Fable 5」いつ使う?どう使う?——従量課金時代の使い分け決定版
丸投げが成り立つ3つの条件
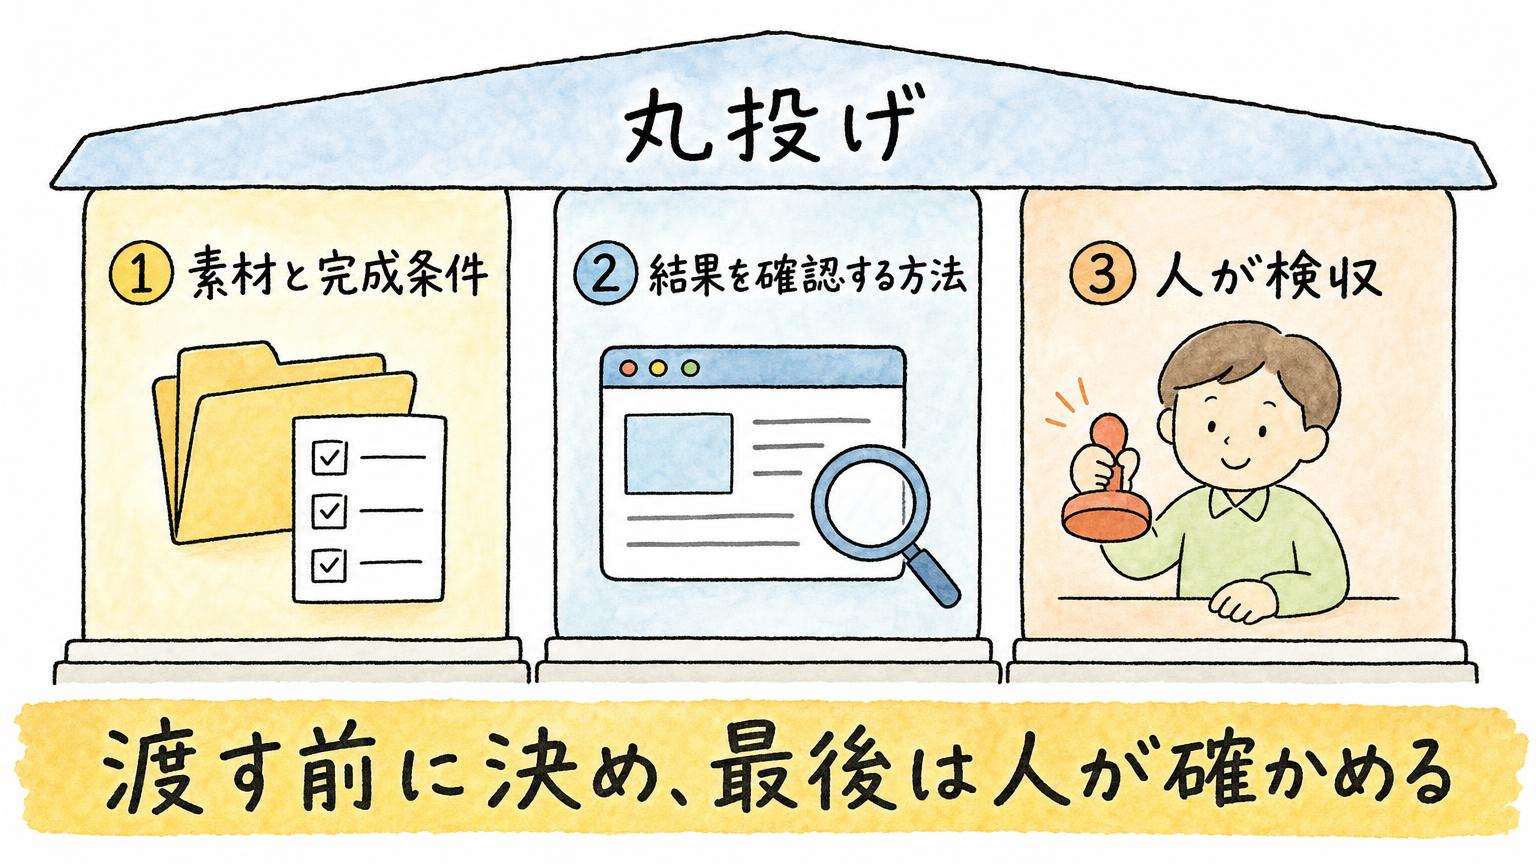
一件まるごと任せるために必要な条件は、3つあると考えています。
①素材と完成条件を先にそろえる。 何を渡し、何が出来れば完成かを先に決めておきます。完成の形が決まっていれば、AIは途中で迷いません。
②結果を確認する方法がある。 ブラウザで動かす、画面で見る、期待値と照合する。この方法が、AIに「やり直す」きっかけを与えます。データベースの集計では、他の2つのモデルは動いても期待額の5〜8倍を返し、Fable 5.2は期待どおりでした。実行できることと、数字が正しいことは別です。
電子機器の設計実験でも同じ構図でした。設計はAI、実物の製作と試験は人が担い、3機種とも回路を直さずに動いています。ただし試作品の段階で、認証はまだで、量産向けには設計されていません。
③人が検収する。 85点を90点以上にする最後の部分は、人の仕事です。元データとの照合、解釈の確認、そして手直しを含めた時間で効果を測ること。デモが本当に再現できるか、数字や事例が正しいかは、登壇する人が最後に確かめます。見るのは、さきほどの失敗例のように、頼んだ長さに届いているか、渡した指定と合っているか、という依頼主の目線です。
▶︎ あわせて読みたい:Claudeチャットの Docs・Slides・Design・Cowork を9ケースで実機検証。作れたものと、人が見るべき場所
費用と使い分け
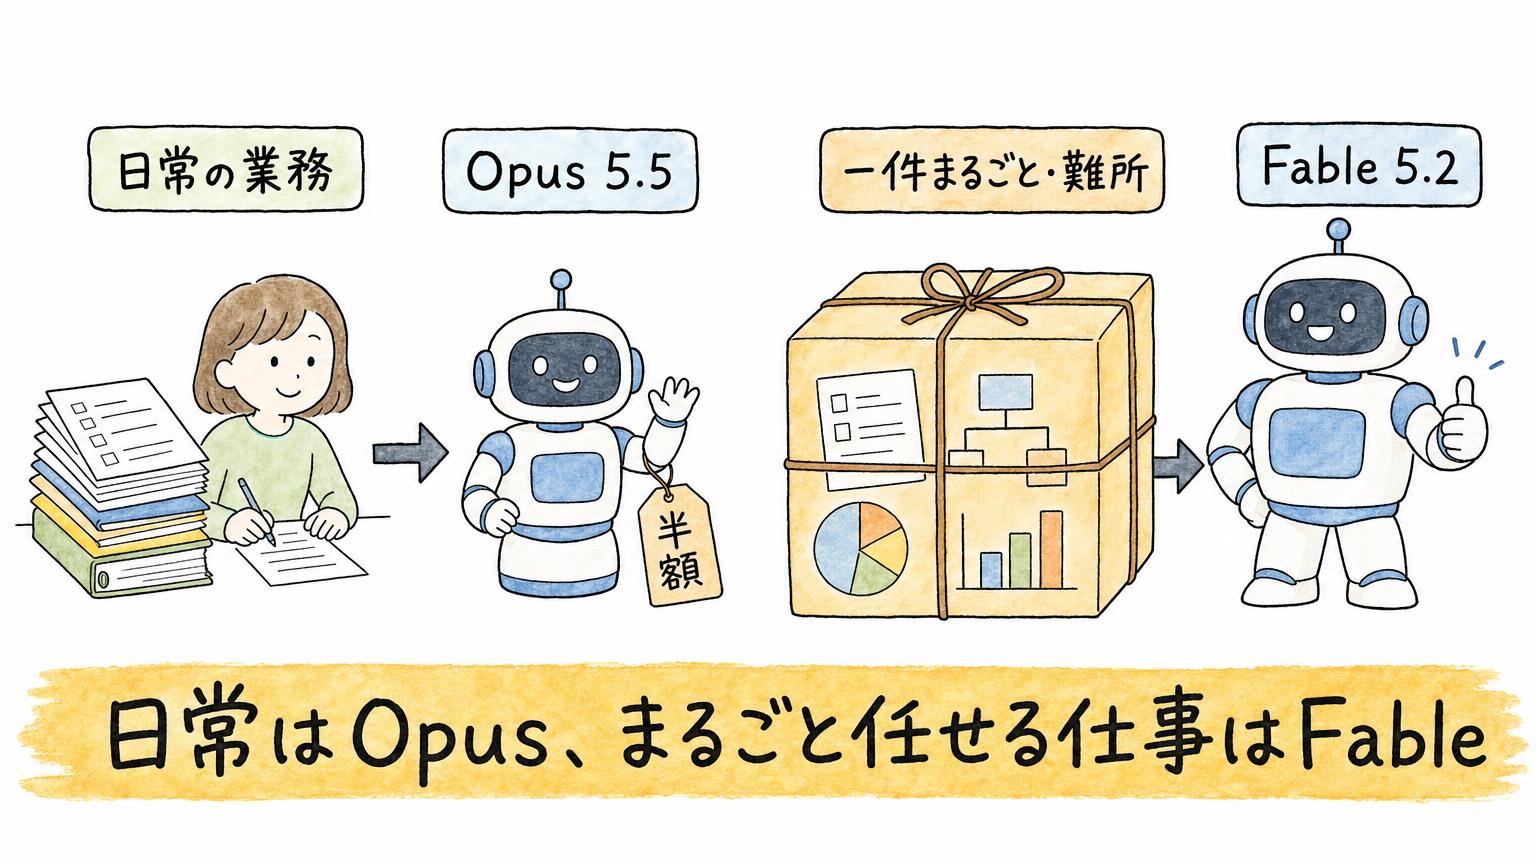
単価は前の版から約2割下がりました。それでも公式の勧めは、大半の業務はOpus 5.5から始めること。こちらは半額です。日常はOpus、一件まるごと任せたい仕事や難所にFable 5.2、という分け方が現実的でしょう。
費用は、思考量の設定でも変わります。外部の評価機関の集計では、最も深く考える設定の費用は1課題あたり5.1の約2倍でした。使うトークンの量も増えていました。一方、Anthropicの報告では、思考量を下げた設定で、コード修正の評価をOpusの最高成績に近い水準で解き、費用は約半分でした。
最上位モデルが全体を仕切り、簡単な作業を小さいモデルに任せる構成も使えます。Anthropicの社内評価では、最上位モデル単独の構成より費用は半分以下になり、精度は少し下がりました。
社内資料を渡すなら、経路にも注意が要ります。クラウド経由で東京・大阪のリージョンから呼び出せても、処理は海外を含む世界規模の経路のみで、国内完結ではありません。
渡し方の変化:手順から完成条件へ
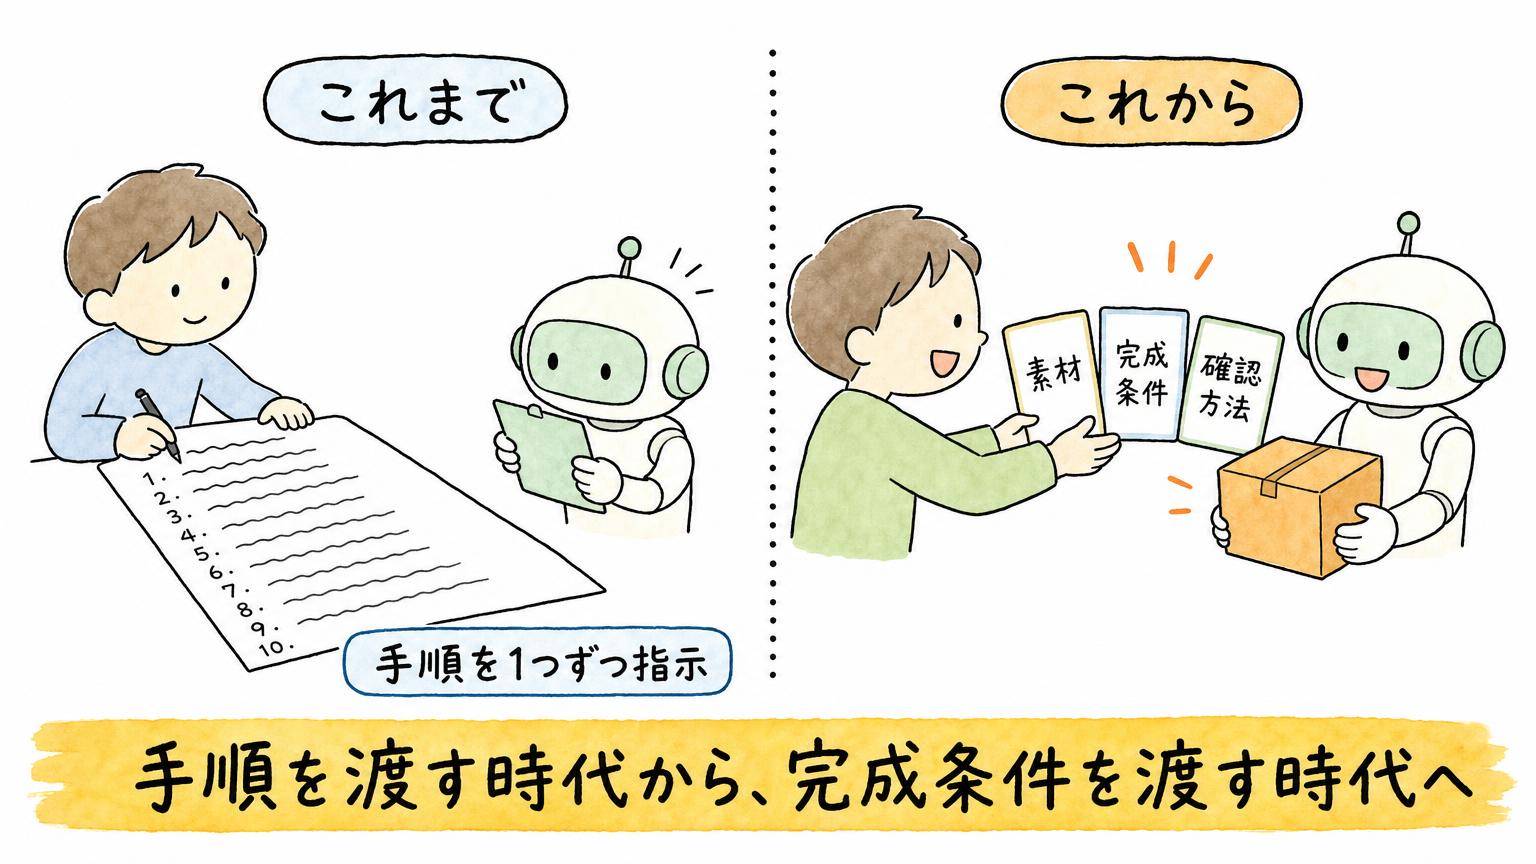
日本の職場では、作業を細かい手順に分けて渡すのが普通です。AIにも同じ渡し方をすると、手順を考える手間が人に残ります。5.2で見えてきたのは、素材と完成条件を渡し、結果を確認する方法を決めて、あとは任せる形です。
受ける側にとっては、作業量ではなく、完成条件を聞き出す力と、検収の責任が価値になるでしょう。発注する側は、素材を整え、何をもって完成かを書く力が問われます。
一件まるごと任せられる仕事は、まだ限られます。約41%という数字も、それを物語っています。それでも、確認方法を先に決めた仕事から順に任せていけば、人の時間は、手を動かすことから、判断と検収へ移っていきます。早く試して、任せる範囲を広げた人から、仕事の時間の使い方が変わっていくでしょう。
よくある質問(FAQ)
Q1. Fable 5.2とOpus 5.5は、どう使い分ければよいのか
日常の業務はOpus 5.5、一件まるごと任せたい仕事や難所にFable 5.2という分け方が現実的です。公式も大半の業務はOpus 5.5から始めることを勧めており、Opus 5.5は半額です。Fable 5.2の単価は前の版から約2割下がりました。
Q2. Remote Labor Indexの約41%は、何を表す数字なのか
実際の外注案件で、依頼主がそのまま受け取れる水準に達した割合です。Fable 5.2は約41%、Opus 5.5とGPT-6 Astraは約21%、Fable 5.1は約18%でした。逆に言えば、6割近くの案件はまだ納品水準に届いていません。
Q3. 日本のリージョンから呼び出せば、処理は国内で完結するのか
完結しません。クラウド経由で東京・大阪のリージョンから呼び出せても、処理は海外を含む世界規模の経路のみで、国内完結ではありません。社内資料を渡すときは、この経路を前提に判断する必要があります。
一件まるごと任せる仕事を、どう設計するか。AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」で、実務を持ち寄りながら探っています:https://frontier-leaders.vercel.app/
2時間で、AI活用術を実践のハンズオンで学べます(過去回のアーカイブ):https://handson.workstyle-evolution.co.jp/
毎週のAIニュースを、動画で追えるYouTube『いけともch』:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事

人気記事RANKING
-

Gemini 4 Carbonは何に向く?Fable 5.2に近い品質を約6分の1の費用で出す、資料照合の強み
-

AIで写真を編集する方法|FLUX.1 Kontextの実践プロンプト10種と失敗5例
-

FaceFusionでフェイススワップを完全マスター|初心者からプロまで使える詳細ガイド
-

PwC予測:2035年のAI進化で企業組織が根本変革へ
-

ComfyUI完全ガイド – プロダクションレベルのパイプラインを作るテクニック
カテゴリー
- 主要AIサービス (114)
- 画像生成AI (87)
- 動画生成AI (114)
- 音楽・音声生成AI (28)
- AI開発・効率化ツール (153)
- AIのビジネス活用 (198)
- 教育×AI (19)
- AIの知識&トレンド (239)
- いけともサブチャンネル (420)
- AIエージェント時代の働き方 (1)
タグ
Agent V3
AI字幕
AI字幕ツール
Alibaba
Amazon Seller Assistant
Amazon Seller Central
AP2
ATOS
ByteDance
CAG
Cognition AI
Comscore
cotomi Act
DAW
DevOps
Gemini Advanced
GUGA
HeyGen
HunyuanImage
HunyuanImage-2.1
IndexTTS2
JR東日本
NEC
OpenAI Platform
Oracle
Perplexity Search API
Qwen3-Next
Replit
SeeDream
SongBloom
Stargateプロジェクト
Suno Studio
Thinking Machines
インコンテキストラーニング
カスハラ
コネクタ
ステム分離
ソフトバンクグループ
データセンター
パナソニックコネクト
事故対応
動画解析AI
暗黙知
決定論性
鉄道運行管理
公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ