Claude Sonnet 5.5とOpus 5.5の違いは?費用が最大30%下がる理由とeffortの選び方
Claude Sonnet 5.5とOpus 5.5の違いは?費用が最大30%下がる理由とeffortの選び方
- Claude Sonnet 5.5は、範囲の明確な日常業務向けの標準機として、2026年9月28日にAnthropicが公開しました。
- 単価はSonnet 5と同じでも、同社のテストではタスク1件あたりの費用が最大30%下がり、出力は30%以上速くなりました。
- 速度と費用の数字はAnthropic自身のテストによるもので、第三者の独立検証は発表時点では示されていません。
2026年9月28日、Anthropicが「Claude Sonnet 5.5」を公開しました。Claude 5.5ファミリーの2つ目のモデルです。
単価が同じで、なぜ費用が下がるのか。上位のOpus 5.5があるなかで、どう使い分けるのか。モデル選びの4つの軸で整理します。
目次
Sonnet 5.5は「範囲の明確な日常業務」向けの標準機
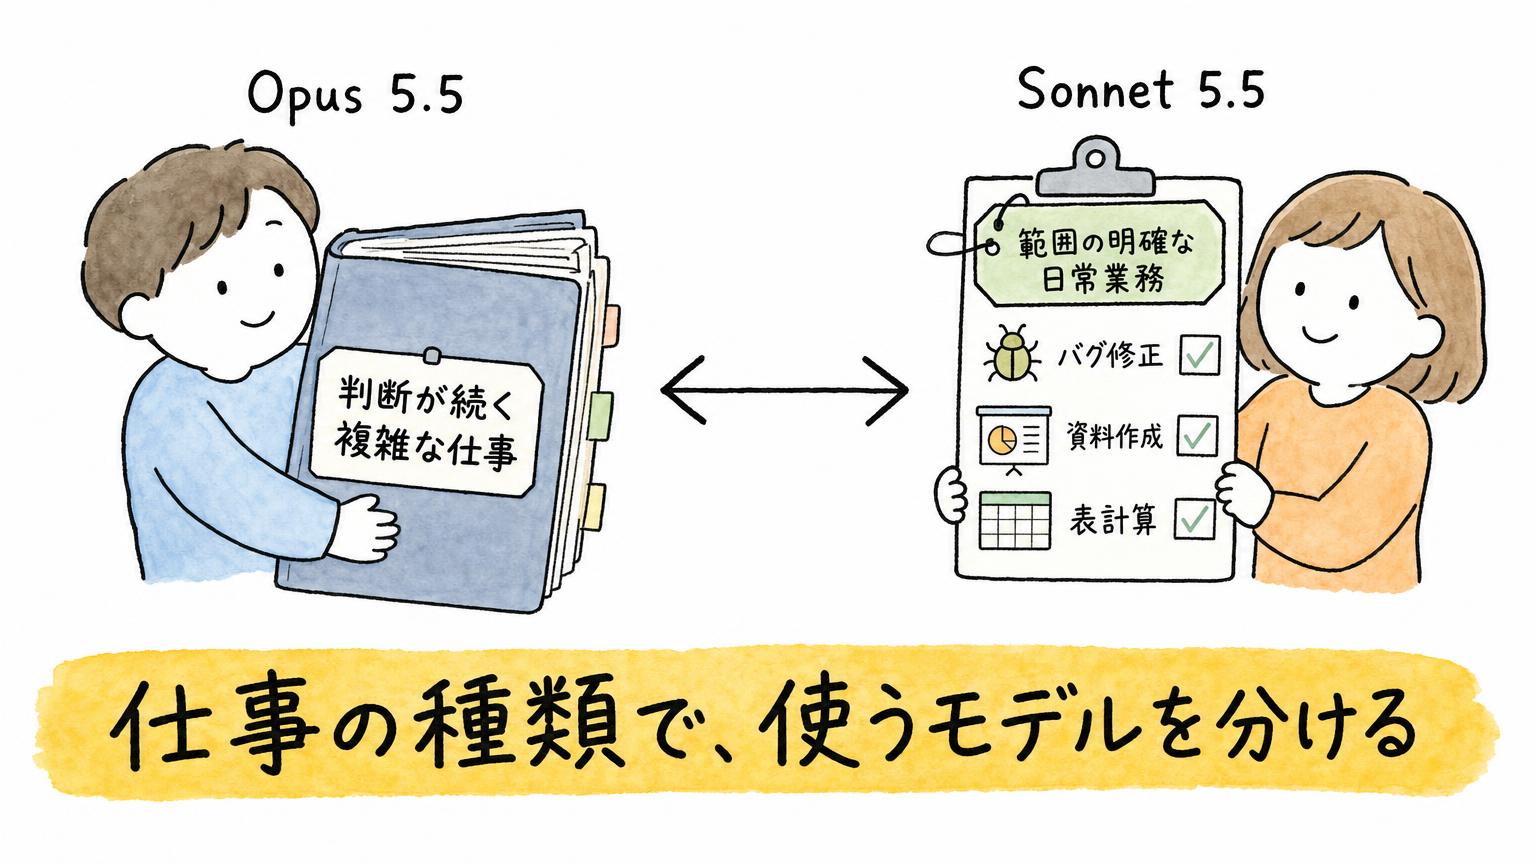
AnthropicはSonnet 5.5を、バグ修正や、文書・スライド・表計算の資料づくりといった「範囲の明確な日常業務」に強いモデルと位置づけています。複雑で、慎重な判断が続く仕事を担うのは、同じ5.5ファミリーのOpus 5.5です。
発表の要点は3つあります。出力はSonnet 5より30%以上速く、100万トークンあたりの価格は入力2ドル・出力10ドルでSonnet 5と同じ。そのうえで、同じ仕事に必要なトークンが減り、タスク1件あたりの費用は最大30%低くなったといいます。
Anthropic自身、Sonnet 5.5は同社のモデルの能力の最前線を押し上げるものではないと述べています。位置づけは、複雑な仕事向けのOpus 5.5を補う、より速く低コストなモデルです。
公開の仕方は、Anthropicの方針と重なります。Anthropicは、能力が一定の水準に達したら保護策も引き上げるという考え方を、Responsible Scaling Policyとして公開し、改訂を重ねてきました。Sonnet 5.5はサイバー関連の能力が前モデルから大きく伸びたため、Opus 5.5と同様の保護策を付けて出しています。
大量処理や低コストの用途向けの「Haiku 5.5」も、今後数週間のうちに加わる予定です。
なお、この記事の速度と費用の数字は、Anthropic自身のテストと早期利用企業の報告によるものです。この2つについて、第三者による独立した検証は、発表時点では示されていません。
Terminal-Bench 4.0は10.3%から70.6%へ
Sonnet 5.5の発表は、Sonnet 5から約3か月後の更新です。Sonnet 5は6月30日の発表で、「これまででもっともエージェント的なSonnet」とされ、計画を立て、ブラウザーや端末のようなツールを使いながら自律的に動けると説明されていました。FreeとProの初期設定のモデルにもなりました。
つまり、5.5になって初めて仕事を進められるようになったわけではありません。すでに任されていた種類の仕事を、どこまでやり切れるかが変わりました。
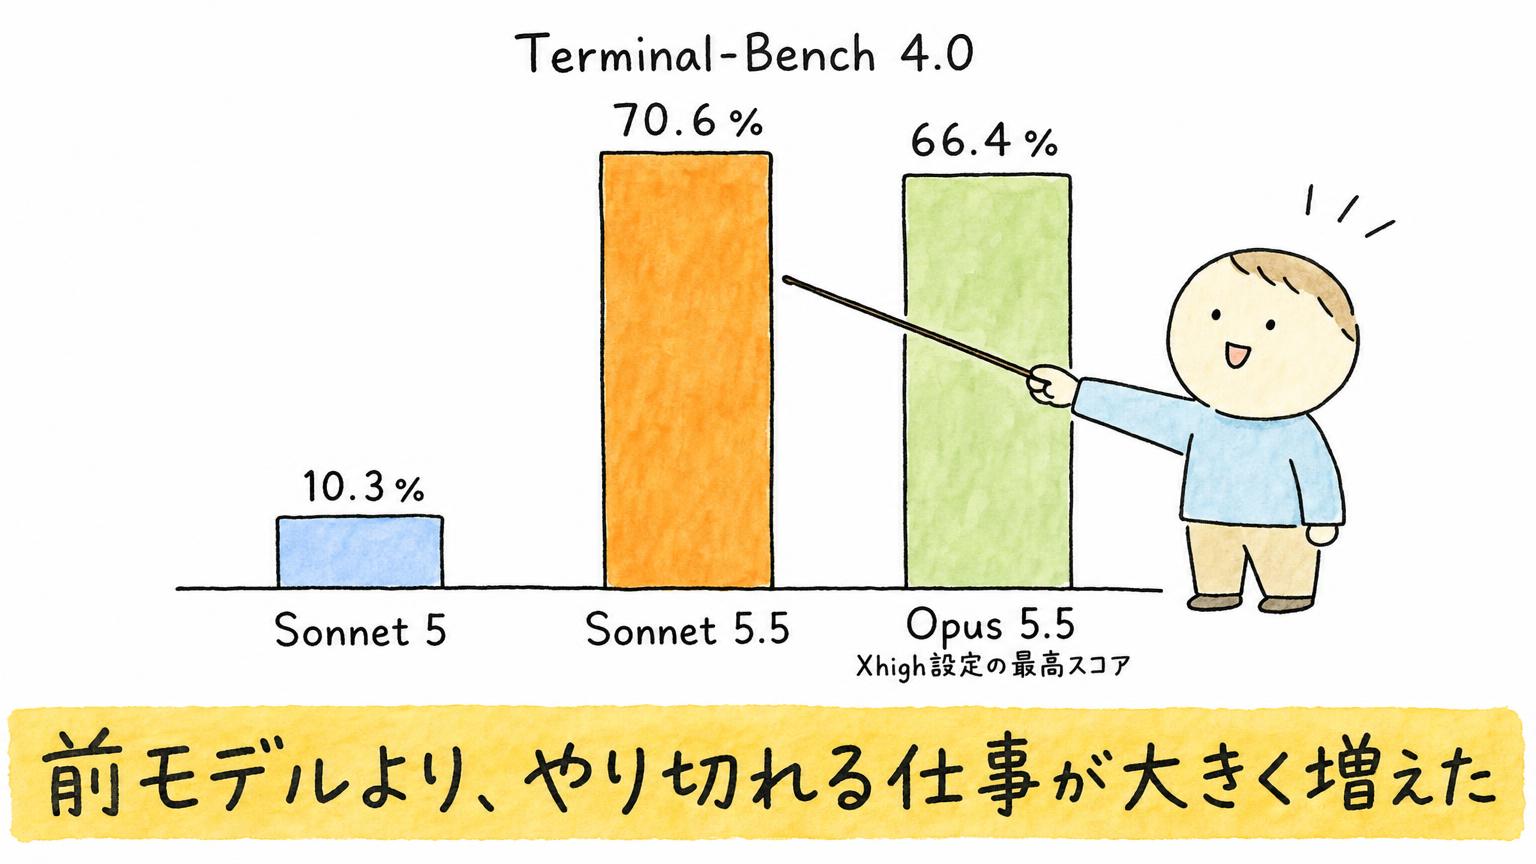
コマンドライン上で、複雑な複数ステップの業務をどこまでこなせるかを測る評価「Terminal-Bench 4.0」では、Sonnet 5.5が70.6%、Sonnet 5が10.3%でした。Opus 5.5は66.4%です。
読み方には注意が要ります。Opus 5.5の66.4%は、「Xhigh」設定で走らせた同モデルの最高スコアで、Sonnet 5.5の設定は表に書かれていません。Sonnet 5が10.3%にとどまった理由も、発表では説明されていません。
それでも、差の大きさは見逃せません。Claudeアプリの初期設定であるMediumで走らせたSonnet 5.5は、Sonnet 5の最高スコアを大きく上回り、タスク1件あたりの費用は10分の1未満だったと、Anthropicは説明しています。
実際のCursorの利用場面から作った評価「CursorBench 4.0」でも、Sonnet 5.5は55.5%で、Sonnet 5の34.1%を大きく上回りました。Opus 5.5は57.8%です。
早期テスターは、コードベースを理解する速さと、ツール呼び出しをまとめて手順を減らす点を挙げています。前モデルから変わったのは、同じ種類の作業を「やり切れる割合」と「進め方」です。
ただし、Terminal-BenchでOpus 5.5を上回っても、複雑で自由度の高い仕事ではOpus 5.5のほうが明確に強いと、Anthropic自身が書いています。ここが、次の軸につながります。
軸1:役割はOpus 5.5の代わりではない
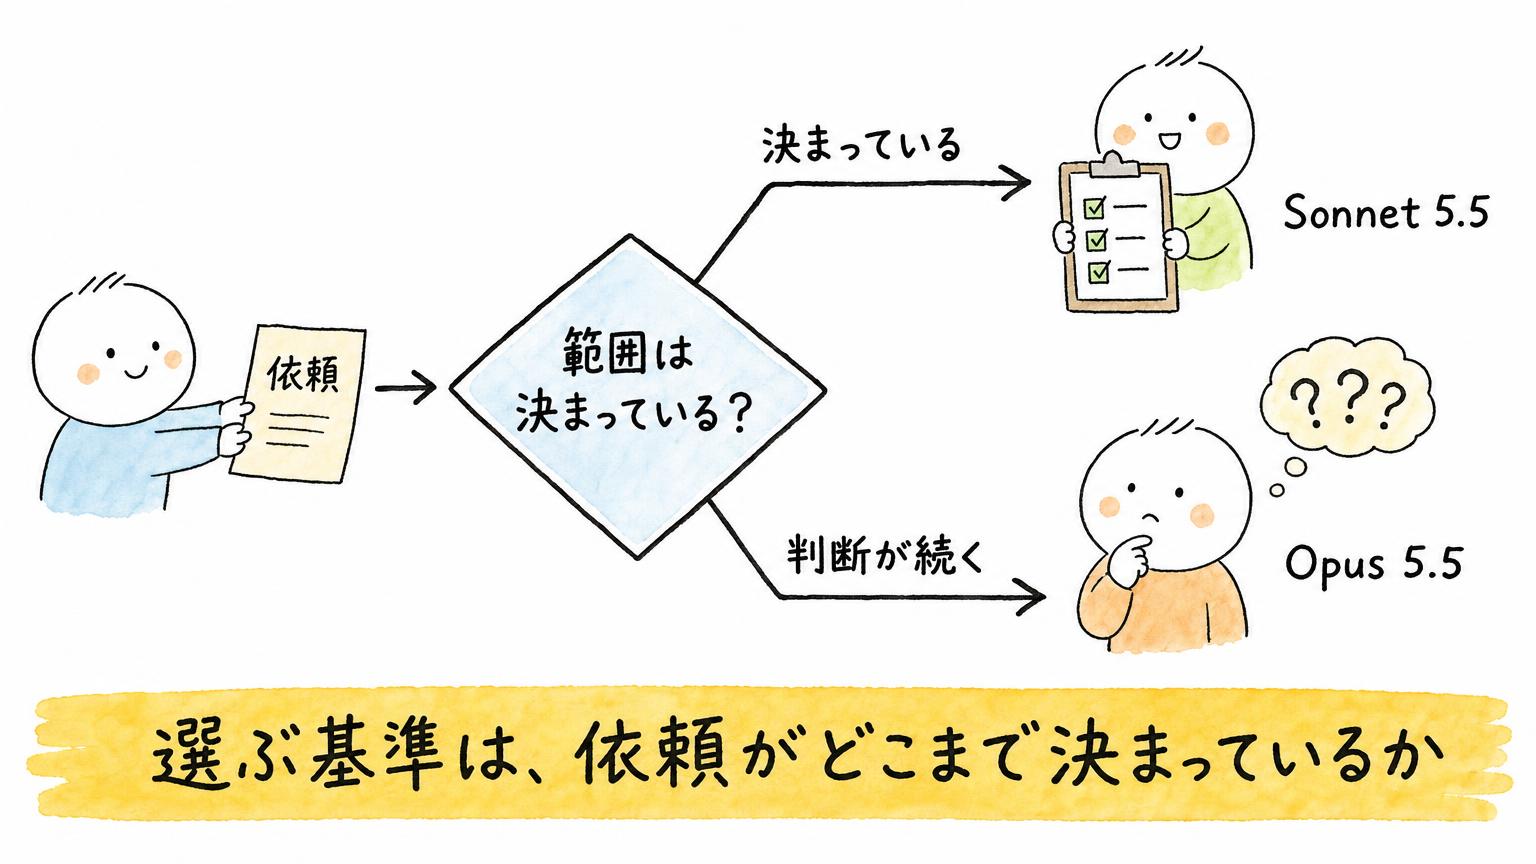
Anthropicは、Sonnet 5.5が強いのは「範囲の明確な日常業務」、Opus 5.5が強いのは「慎重な判断が続く複雑な仕事」と分けています。ベンチマークの点数で差が小さくても、社内テストと外部テスターの結果では、複雑で自由度の高い仕事はOpus 5.5が明確に強いそうです。
点数の差は確かに小さく見えます。44職種・9業界の実務を模した評価「GDPval-AA」では、Sonnet 5.5が1844点、Opus 5.5が1846点で、差は2点でした。Sonnet 5は1449点です。なお、評価を実施したArtificial Analysisの公開前の環境には、構造化出力を使う依頼の応答を悪化させうるバグがあり、5.5の点数を低く見せた可能性があると、Anthropicは注記しています。影響があっても小さいと見ているそうです。
資料づくりの例もあります。Anthropicの社内テストでは、上場企業の決算資料と電話会見の書き起こし、スライドのテンプレートを渡し、10枚の事業レビューを作らせました。2人の専門家は、初稿をそのまま送れる水準と判断したそうです。
Epic GamesのCOO、ダニエル・ヴォーゲル氏は、早期テストでSonnet 5.5が、システム設計の監査やデータフローのレビューで上位モデル並みの基準を満たしたと語っています。数万行のコードにわたるゲームの仕組みの設計も扱い、数時間かかる作業をこなし、細かい指示を減らしても結果を出したそうです。
なお、「30%以上速い」のは出力が生成される速さです。仕事全体の所要時間が3割縮むという意味ではありません。入力の準備や、人の確認にかかる時間は別です。
選ぶ基準は、モデルの上下ではなく「依頼がどこまで決まっているか」です。決算資料から10枚の報告書を作る、既知のバグを直す、といった範囲の決まった仕事はSonnet 5.5。方針が固まっていない新規事業の検討のように、判断が続く仕事はOpus 5.5という分け方になります。
▶︎ あわせて読みたい:上位のOpus 5.5は何が変わったのか――コスト4割減の中身を読む
軸2:費用は単価ではなく「使う量」で決まる
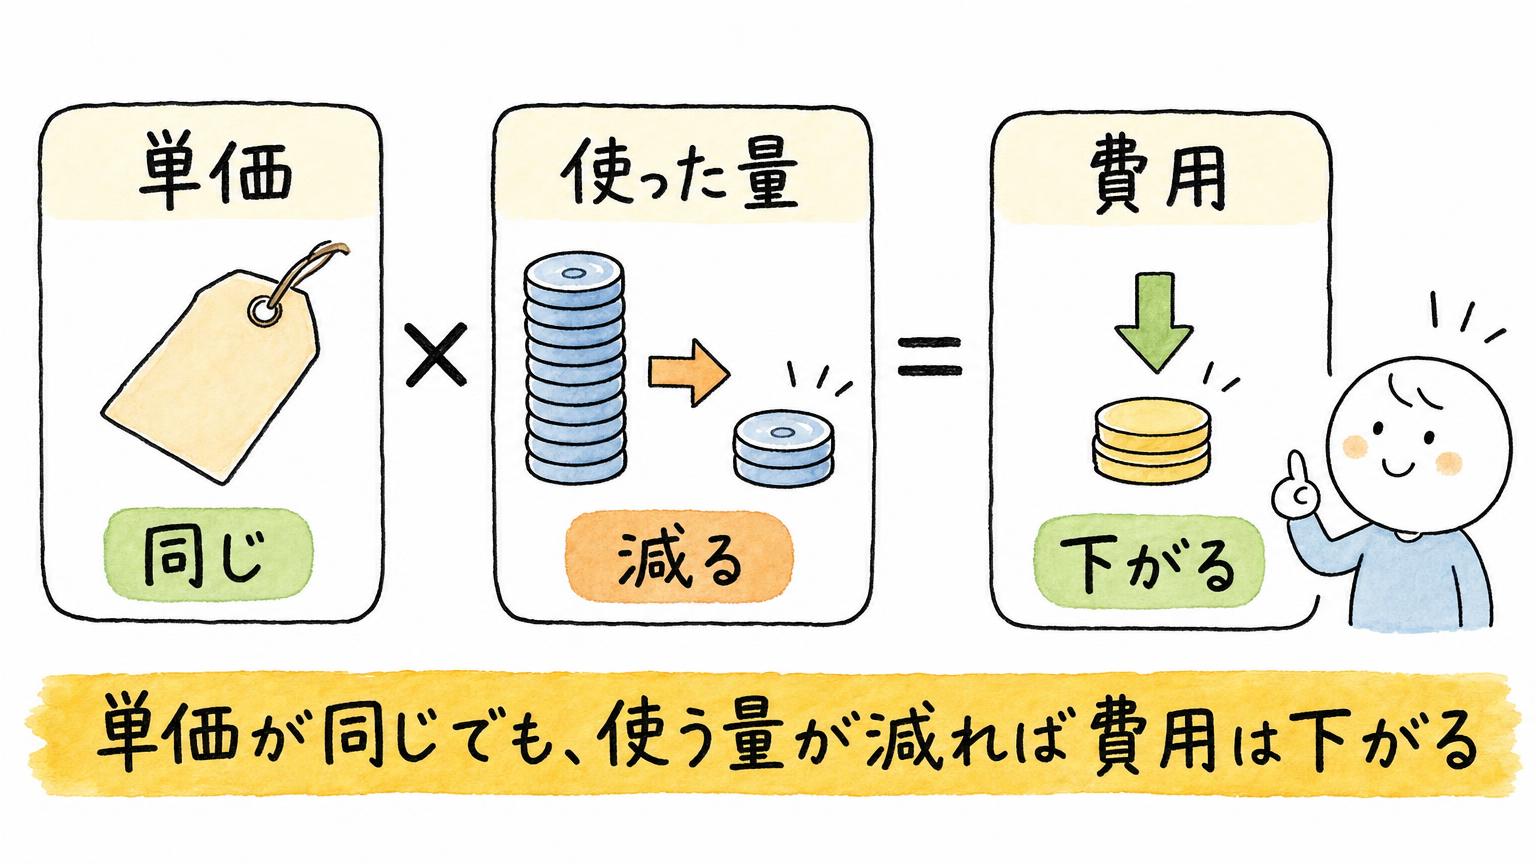
支払う額は「単価 × 使った量」です。Sonnet 5.5の単価は、100万トークンあたり入力2ドル、出力10ドル、キャッシュ読み込み(前回と同じ部分の処理結果を使い回す仕組み)0.20ドルで、Sonnet 5と変わりません。Opus 5.5は入力4ドル、出力20ドルで、キャッシュ読み込みは同じ0.20ドルです。
それでも費用が下がるのは、同じ仕事に使うトークンが減ったからです。Anthropicによれば、5.5は少ないトークンで同じ作業を終えられ、同社のテストでは、タスク1件あたりの費用がSonnet 5より最大30%低くなりました。
Slackのプリンシパルエンジニア、カーティス・アレン氏は、プロンプトを変えないまま、Slackbotの社内評価のほとんどでSonnet 5より良い結果が出たと語っています。手順は減り、出力トークンは約14%少なかったそうです。
コーディングの早期利用者の比較でも、Sonnet 5.5はツール呼び出しをまとめて行う回数が増え、手順と費用が減りました。
effortの設定を組み合わせると、差はさらに開きます。いくつかの評価では、LowやMediumのSonnet 5.5が、Sonnet 5の最高スコアを、タスク1件あたり約10分の1の費用で上回りました。FrontierCodeという評価では、同じHighの設定どうしでSonnet 5より10ポイント高く、費用は約15分の1だそうです。
注意したいのは、キャッシュ読み込みがOpus 5.5と同額なことです。長い文脈を使い回すエージェント作業では、入力・出力の単価ほどには差が開かない場面もあるでしょう。料金表の「半額」を、そのまま請求額の差とみなすのは危険です。
Sonnet 4.6・4.5やHaiku 4.5から移る場合は、別の注意もあります。移行ガイドによれば、Sonnet 5.5はSonnet 5と同じトークナイザー(文章をトークンに区切る仕組み)を使い、それらと比べると、同じ文章でも内容によってトークン数が約30%増えます。
費用の差は、料金表ではなく「1件の仕事を終えるまでに何をどれだけ使うか」で決まります。自社の代表的な作業を1つ決め、1件あたりの費用を測るのが確実です。
軸3:effortで同じモデルが別物になる
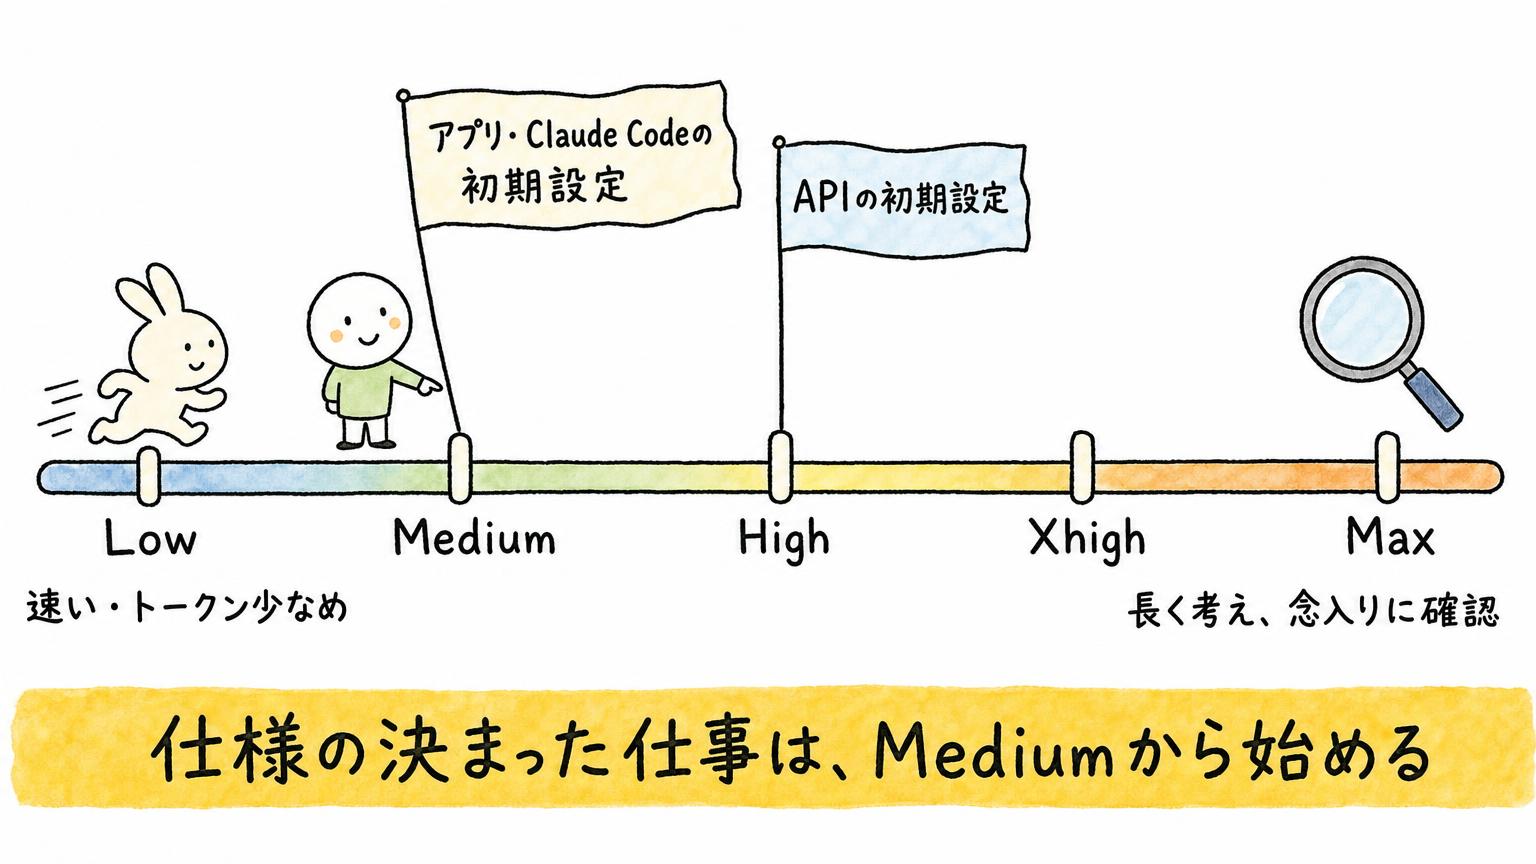
effortは、モデルにどれだけ考えさせるかを選ぶ設定です。下げると応答が速くなり、使うトークンも減ります。上げると長く考え、作業をより念入りに確かめます。
初期設定は、使う場所で違います。ClaudeのアプリとClaude CodeはMedium、Claude PlatformはHighです。APIでそのまま呼ぶと、アプリより高い設定で動くことになります。
Anthropicの図では、effortを上げると、一般にタスク1件あたりの費用は増え、スコアも上がります。Sonnet 5.5をMaxにすると、いくつかの評価ではOpus 5.5に匹敵する成績になる場合があります。
AnthropicはSonnet 5.5について、Opus 5.5を補う使い方が最も効くのは、effortの低い設定だと説明しています。1件あたりの費用が安く済むからです。高い設定では、似た費用で似た成績になる場合があります。
しかも、上げれば常に良くなるわけではありません。FrontierCodeでは、Sonnet 5.5はMaxよりもXhighのほうが高い成績でした。この評価は「人の手直しなしでマージできる変更か」を測り、依頼の範囲外の変更を減点します。
Maxでは、Xhighより頻繁に、Claude Codeのコードレビュー機能(レビューを多数のサブエージェントに分けて行う仕組み)を使いました。Cognitionが調べた2件では、これがタイムアウトか、依頼の範囲外の追加編集につながり、点数が下がったそうです。
Anthropicのドキュメントによれば、effortは厳密なトークン予算ではなく、振る舞いを調整する信号です。低い設定でも、十分に難しい問題ではモデルは考えます。また、段階は再調整されているため、同じ「medium」でもSonnet 5と同じ量だけ考えるとは限りません。Sonnet 5の設定をそのまま引き継がず、自分の評価でもう一度試すよう案内されています。
出発点の目安も示されています。エージェント的なコーディングや複数ツールを使う作業では、仕様がはっきりした作業はmediumから始め、難しい作業や長い作業はhighへ上げます。チャットなど待たされたくない用途は、mediumかlowからです。xhighとmaxは、自分の評価で品質の向上が確かめられたときだけ使うとされています。
仕様の決まった仕事はMediumから始め、難しい仕事だけ上げる。それでも判断が重い仕事はOpus 5.5へ。この順序なら、費用と成績の釣り合いを自分の仕事で確かめながら進められます。
軸4:GPT-6 SolとGemini 3.8 Flashと並べると
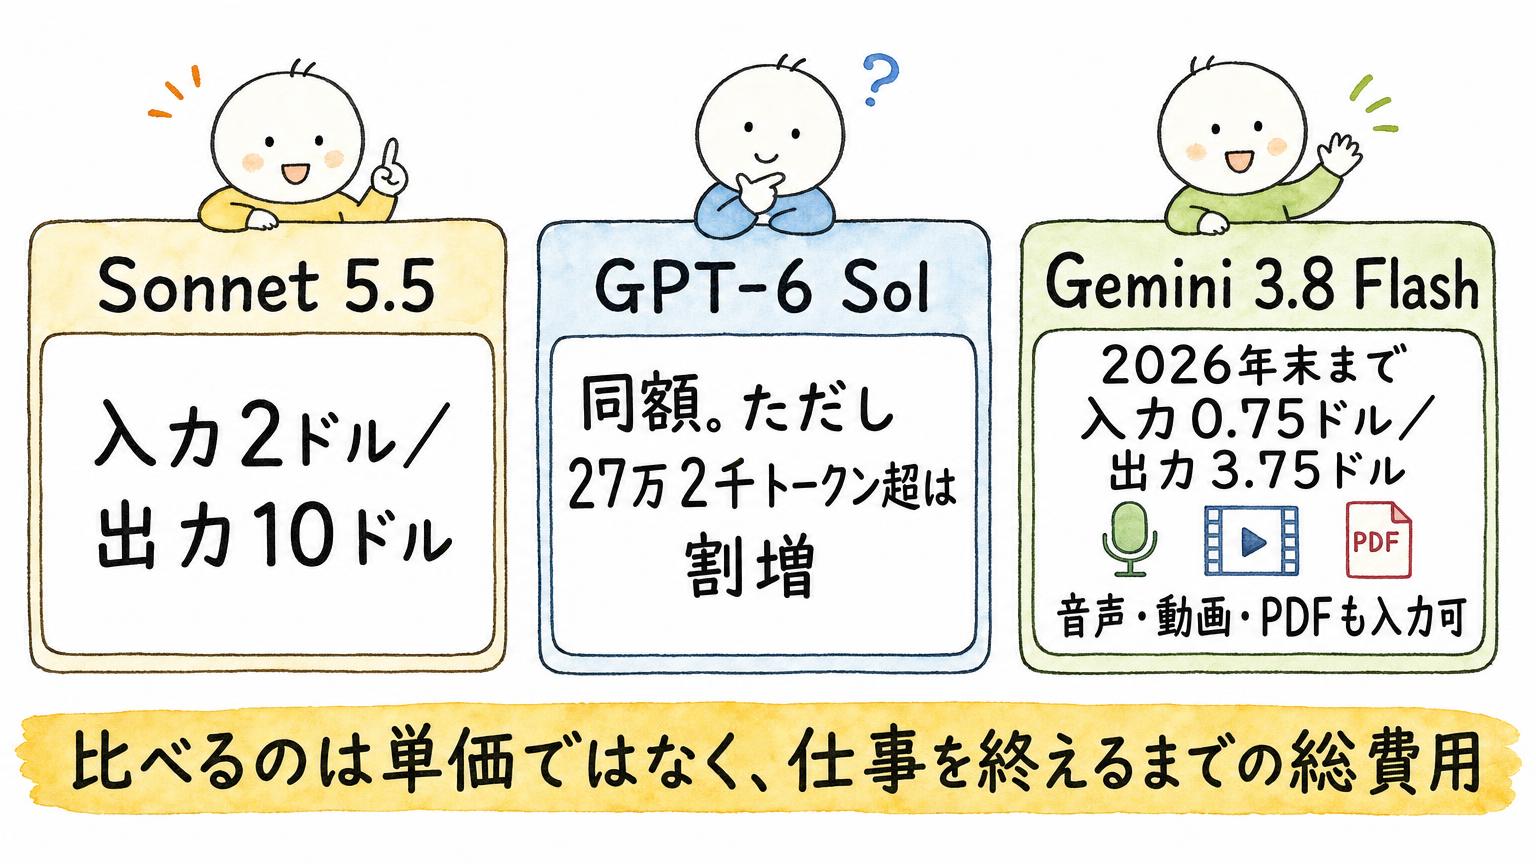
同時期の他社モデルとも並べます。比べる相手は、OpenAIのGPT-6 Sol、GoogleのGemini 3.8 Flashです。2026年9月末時点の組み合わせで、OpenAI側にはより新しいGPT-6.1 Solの案内もあります。
GPT-6 Solの標準価格は、100万トークンあたり入力2ドル・出力10ドルで、Sonnet 5.5と同額です。ただし入力が27万2千トークンを超えると、そのリクエスト全体で入力は2倍、出力は1.5倍の料金になります。長い資料を一度に渡す仕事では、この条件が効いてきます。
Gemini 3.8 Flashの有料APIは、2026年末まで入力0.75ドル・出力3.75ドルで、2027年から入力1.50ドル・出力7.50ドルに上がります。出力の単価には、思考に使うトークンも含まれます。
入力できる形式も違います。Gemini 3.8 Flashは、テキスト・画像・動画・音声・PDFを受け取ります。GPT-6 Solの入力は文章と画像で、音声と動画は非対応です。会議の録音から報告資料を作る仕事なら、後者では文字起こしを先に用意する工程が増えます。
性能の数字は、Anthropicの発表ページにあるものです。第三者のArtificial Analysisが実施したGDPval-AAでは、Sonnet 5.5が1844点、GPT-6 Solが1487点でした。FrontierCodeでは、High設定のSonnet 5.5がGPT-6 Solの最高スコアに並び、費用は約5分の1だとAnthropicは説明しています。
ただし、GPT-6 Solの点数には、OpenAIが最近直した画像理解のバグが反映されていない可能性があると注記されています。Artificial Analysisは、GDPval-AAへの大きな影響は見込んでいません。
また、Terminal-BenchではGPT-6 Solの成績が公開されていないため、GPT-5.6 Solが載っています。Gemini 3.8 Flashとの同条件の比較は、この発表にはありません。点数は第三者機関の値、費用の比較はAnthropicの説明、と出どころを分けて読む必要があります。
比べる軸は、単価ではなく「同じ仕事を修正まで終えるときの総費用」です。同じ課題と合格基準を決め、入力・出力・やり直しの回数・人の手直しの時間まで数えると、入力の長さや形式で結論が変わることに気づけます。
▶︎ あわせて読みたい:GPT-6 Solは何が安いのか――API半額とキャッシュ90%割引の仕組みを整理
使う前に確認すること、明日から試せること
Sonnet 5.5を既存の仕事に入れる前に、確かめたい点が3つあります。
1つめは、高リスクのサイバー関連の依頼です。こうした依頼は、Sonnet 5へ見える形で切り替わります。通常のソフト開発でバグを見つけて直す作業は、これまでどおり使えます。サイバー防御者は、まもなく拡張される「Cyber Verification Program」(検証プログラム)に申請すれば、段階的に高度な能力を使えるようになるとAnthropicは述べています。
2つめは、thinkingをオフで使っている場合です。Sonnet 5.5へ移る前に、新しい「between_tools」設定へ切り替える必要があります。
3つめは、アカウントをまたぐ会話の移し替えです。Anthropicは、思考がそれを生んだアカウントから切り離せないよう保存の仕組みを広げました。多くの開発者は変化に気づかないそうですが、Claude Codeで途中のアカウントを切り替えるときなどは、ドキュメントの確認が必要です。
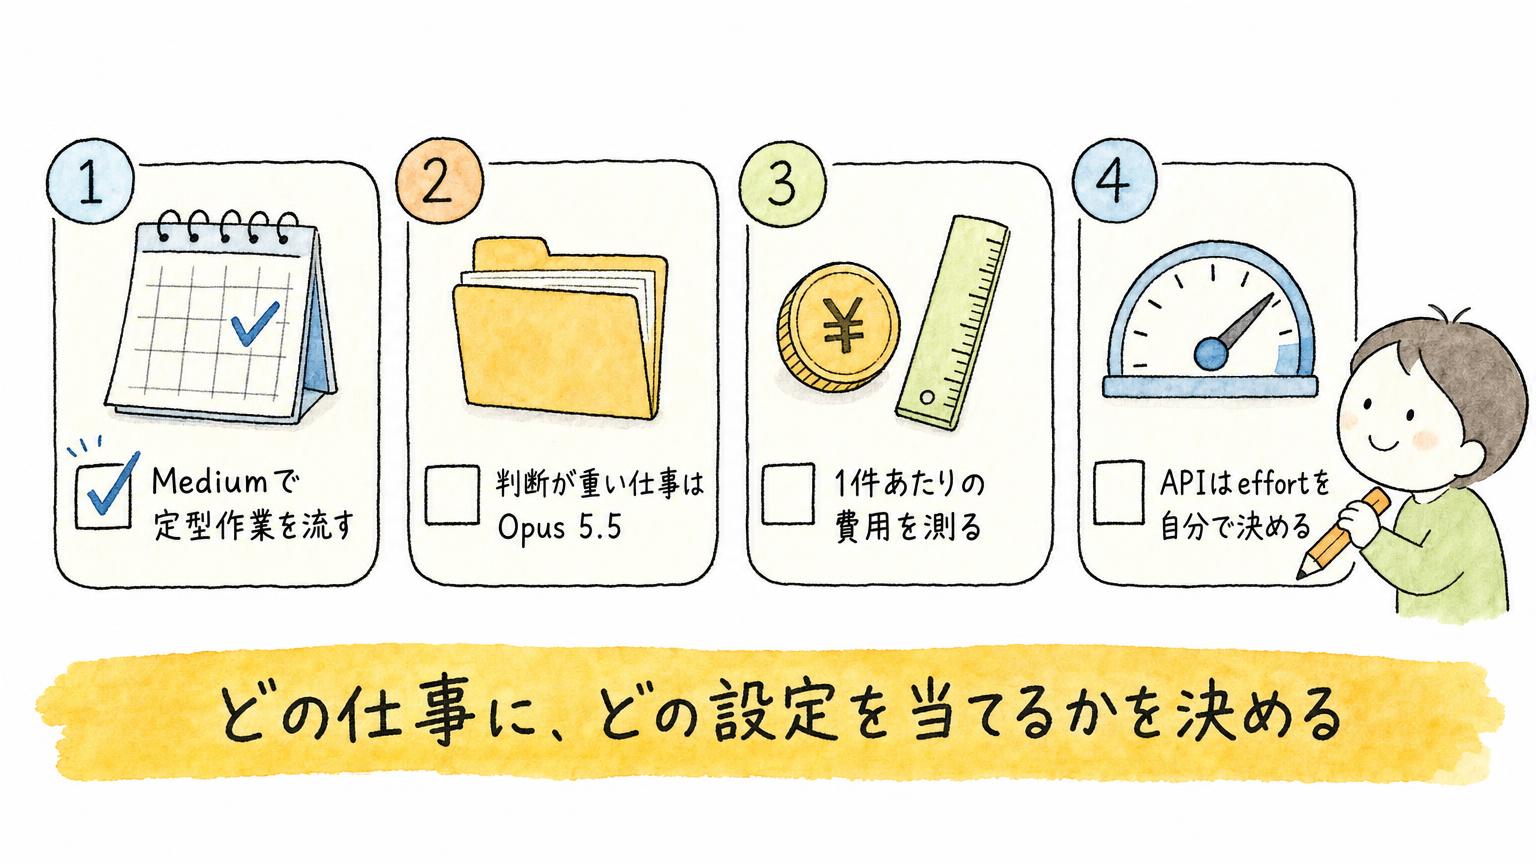
そのうえで、明日から試せることを4つ挙げます。
① 定型の作業を1つ、Mediumで流す
報告書の初稿づくりや既知のバグ修正など、範囲の決まった作業を1つ選び、Sonnet 5.5のMediumで回します。
② 判断が重い仕事はOpus 5.5に残す
方針が固まっていない検討や、慎重な判断が続く仕事は、無理にSonnet 5.5へ寄せません。
③ 同じ作業の1件あたり費用を測る
入力・出力・やり直しの回数と、人が直した時間を並べます。料金表の単価だけでは、費用の差は見えません。
④ APIで使うなら、effortを自分で決める
Claude Platformの初期値はHighです。費用を抑えたい処理では、effortを明示して下げ、thinkingをオフにしている処理は設定を見直します。
性能と費用の壁が下がるほど、問われるのは「どのモデルが一番か」ではなく「どの仕事に、どの設定を当てるか」です。モデルの使い分けを決めたところから、日常業務の速さと費用に差が出てくるのではないでしょうか。
よくある質問(FAQ)
Q1. Claude Sonnet 5.5とOpus 5.5はどう使い分ければよいですか?
選ぶ基準は、モデルの上下ではなく「依頼がどこまで決まっているか」です。決算資料から10枚の報告書を作る、既知のバグを直す、といった範囲の決まった仕事はSonnet 5.5。方針が固まっていない新規事業の検討のように、判断が続く仕事はOpus 5.5です。Anthropicも、複雑で自由度の高い仕事ではOpus 5.5のほうが明確に強いと書いています。
Q2. Claude Sonnet 5.5の料金はいくらで、なぜSonnet 5より費用が下がるのですか?
Sonnet 5.5の料金は、100万トークンあたり入力2ドル・出力10ドルで、Sonnet 5と同じです。費用が下がるのは単価ではなく、同じ仕事に使うトークンが減ったためで、Anthropicのテストではタスク1件あたりの費用が最大30%低くなりました。なお、Opus 5.5は入力4ドル・出力20ドルです。
Q3. effortの設定はどれを選べばよいですか?
初期設定は、ClaudeのアプリとClaude CodeがMedium、Claude PlatformはHighです。仕様がはっきりした作業はmediumから始め、難しい作業や長い作業はhighへ上げます。xhighとmaxは、自分の評価で品質の向上が確かめられたときだけ使うのが目安です。Sonnet 5の設定をそのまま引き継がず、自分の仕事でもう一度試すよう案内されています。
新しいモデルを、使い倒して仕事に組み込むところまで。AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」:https://frontier-leaders.vercel.app/
2時間で、AI活用術を実践のハンズオンで学べます(過去回のアーカイブ):https://handson.workstyle-evolution.co.jp/
Claudeで日々の作業を自動化する具体的な手順は、書籍にまとめています。『Claude 最強のAI自動化術』:https://amzn.to/4eTUVG1
■合わせて読みたい
■関連記事

公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ