ChatGPTのサブスク枠をAPI代わりに使う——MCP Eventsで解説講座を6回作り直して分かった3つの学び
ChatGPTのサブスク枠をAPI代わりに使う——MCP Eventsで解説講座を6回作り直して分かった3つの学び
- ChatGPTのサブスク枠をAPIの代わりに使い、MCP Eventsで外部サービスから仕事を頼めました。
- 調査から講座の保存まで動きましたが、初回は中身が薄く、会話の圧縮で途中停止しました。
- 通知は届くまでしか保証されないため、依頼の台帳・途中保存・点検の工程を設計しました。
「サブスクリプションのAI枠を、APIのように外から呼べないか」。そう考えて、2026年10月の初めに実験をしました。
使ったのは、OpenAIが用意している「MCP Events」です。外部サービスで起きた出来事を、ChatGPTに通知して仕事を頼める仕組みです。
結果は、動きました。ニュースを登録すると、利用者のChatGPT側で調査・執筆が進み、解説講座の保存まで届きました。
ただ、動いたことと、使えることは別でした。初回は中身が薄く、途中では作業が止まりました。直したのは、モデルへの依頼文よりも、通知の「先」の設計でした。
実際にあったことから、学びを3つにまとめます。
- 学び1:通知は「届いた」までしか保証しない(MCP Eventsの仕様)
- 学び2:依頼ごとの台帳をサービス側が持つ(実装と設計案)
- 学び3:質は「深く考えて」ではなく、点検の工程で決まる(実測)
実測したこと、公式仕様、設計案、まだ確かめていないことは、見出しで分けて書きます。
目次
MCP Eventsは、外部サービスからChatGPTへ仕事を頼む入口
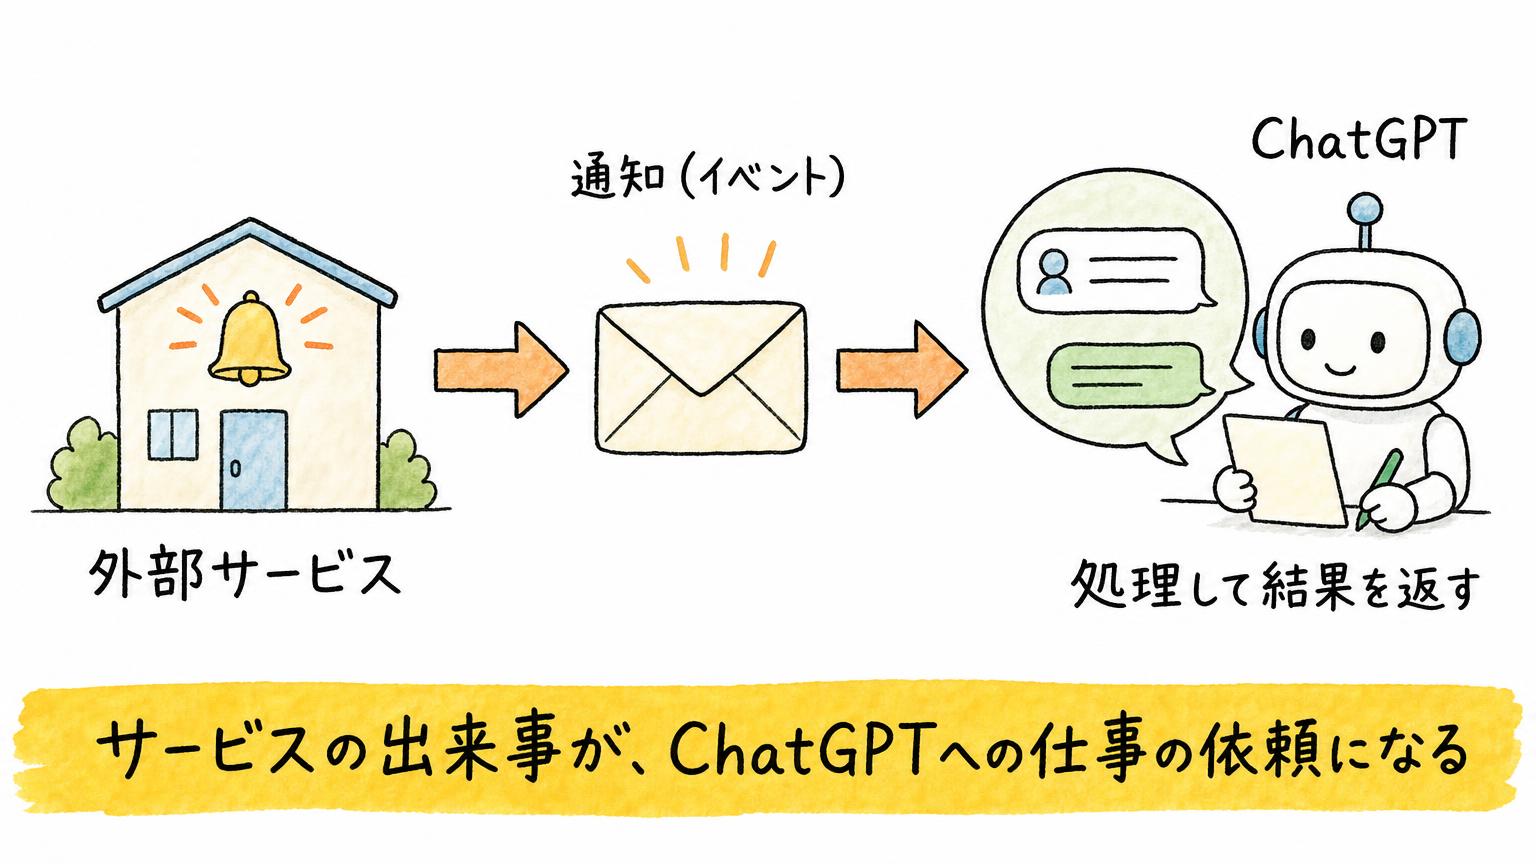
公式仕様によると、MCP Eventsは「webhook(ウェブフック)」と呼ばれる通知の方式で動きます。流れは、次の4つです。
- ChatGPTが「この出来事が起きたら知らせて」と購読を登録し、通知を受ける宛先と、署名用の秘密を渡す(宛先が本当に受け取れるかの検証もある)
- 外部サービスは、条件に合う出来事が起きたら、その宛先へ通知を送る
- ChatGPTが通知を受け取る
- 利用者があらかじめ伝えておいた指示に従って、ChatGPTが処理する
今回の仮説は、ここから生まれました。サービス側が生成AIのAPIに料金を払って文章を作る代わりに、利用者自身のChatGPTの枠で処理してもらえないかというものです。
使える場所は、公式ドキュメントによると、ChatGPT webのWorkチャットと、Cloudを選んだデスクトップアプリのWorkチャット、dotsです。プラグインとイベント起動タスクについては、ワークスペースの管理設定も効きます。
もとになっているのは、MCP Eventsの「ドラフト(草案)」の仕様です。ChatGPTが対応するのは、そのうちwebhookの配送とコールバック検証だけです。草案ベースなので、変わりうる前提で、使う前に最新の仕様を確かめてください。
試したのは、AIニュースの解説講座づくり
僕がやっているAIニュースのサービスでは、ニュースを登録すると、AIがそのニュースの解説講座を作ります。1つのニュースから、3〜5講(章のようなものです)、15〜25問ほどの講座ができます。
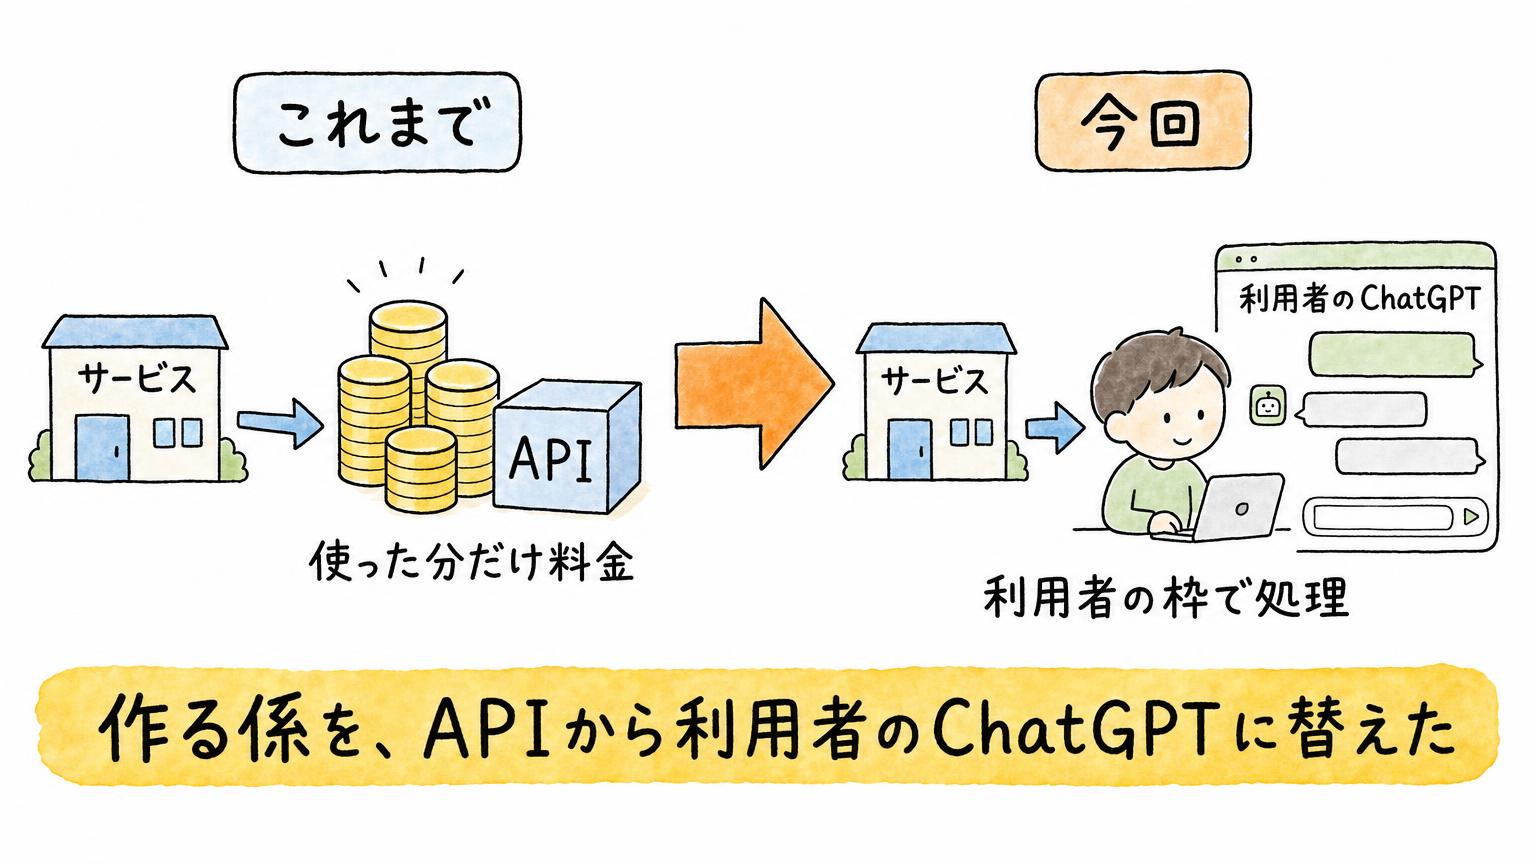
これまでは、この講座づくりに、AIの「API」を使っていました。APIは、使った分だけ料金がかかる仕組みです。講座づくりでは、1記事あたり数ドルの費用がかかっていました。
今回変えたのは、この「作る係」です。APIの代わりに、利用者自身のChatGPTへ、MCP Eventsで講座づくりを頼みました。MCPは、AIが外部のサービスとやり取りするための共通の接続口です。
新しい流れは、次のとおりです。
- サービスが、元のニュースと本人の設定、分析の指示を保存する
- ニュースを登録したら、「この依頼をお願いします」という依頼IDだけを、ChatGPTへ通知する
- ChatGPTが、MCPで必要な資料をサービスから取り寄せ、調査して講座を書く
- 完成した講座を、サービスへ保存する
PC上のCodexアプリを外から起動する構成ではありません。依頼を届けるきっかけがイベントで、実際の作業はChatGPTのクラウド実行が担います。
初回は、ニュース登録から約2秒でイベントを受け取り、6分40秒で4講20問の保存を確認できました。通知を受け取ったことと、講座が完成したことは別なので、保存後に本文を読み戻して、完成を確かめています。
苦労1:動いたのに、中身が薄かった
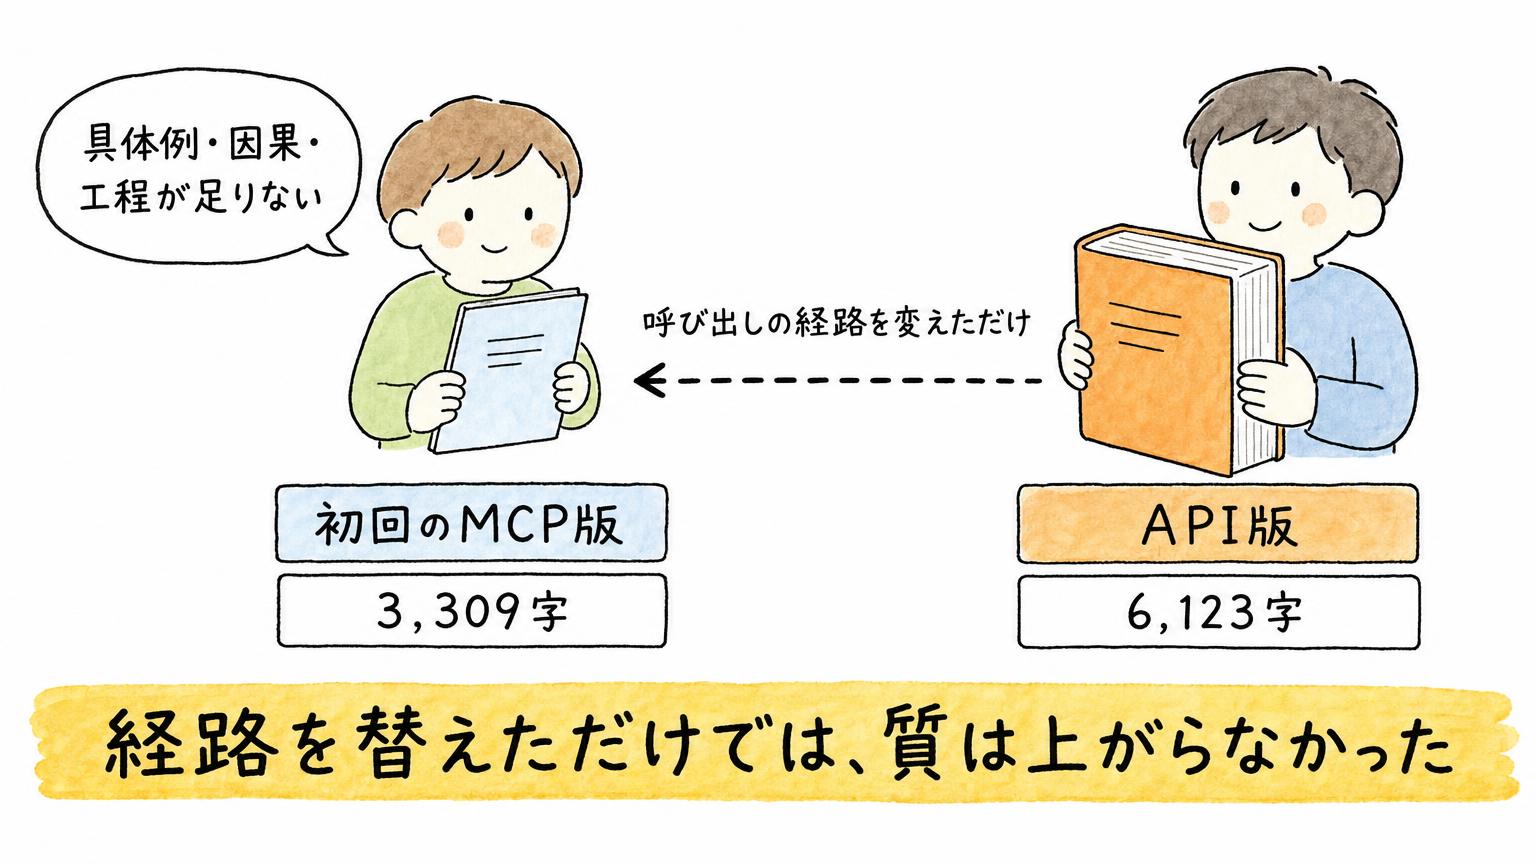
最初のMCP版は、結論や料金の計算は読みやすい一方で、具体例・因果関係・業務の工程の説明が、従来のAPI版より薄くなりました。回答の本文は、MCP版が3,309字、API版が6,123字でした。
問題は、短さそのものではありません。読者が判断するのに必要な説明が、抜けていたことです。
保存の形にも不足がありました。回答ごとの出典や、追加の問いを保存する欄がなく、API版にあった出典35件・追加質問23件に相当する情報を、保存できる形になっていませんでした。
つまり、呼び出しの経路を変えるだけでは、質は上がりません。依頼の仕方と、保存の形を、両方整える必要がありました。
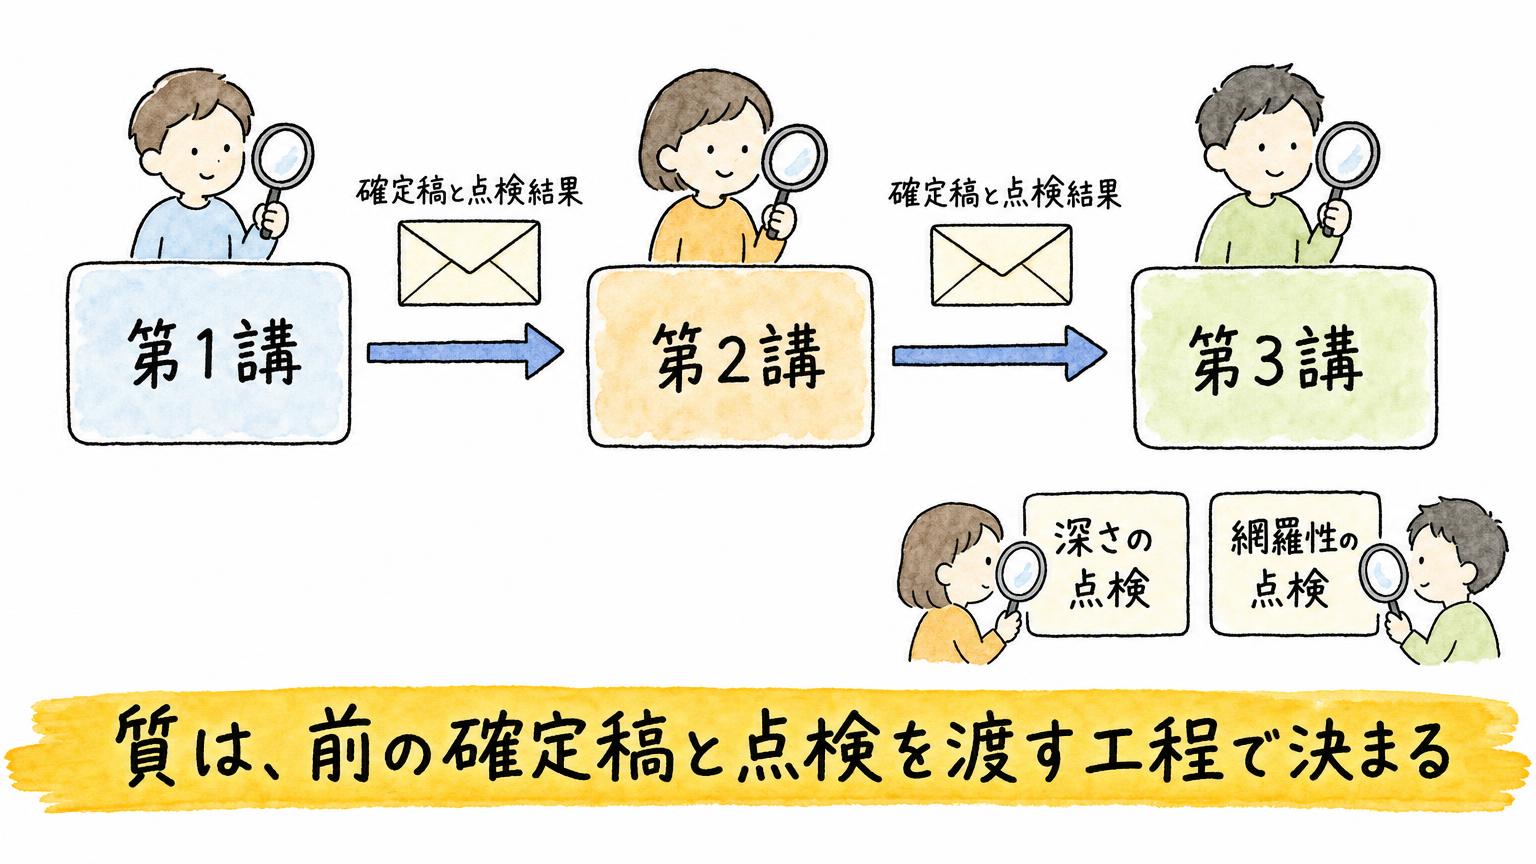
直し方は、「深く考えて」と一度に頼むのをやめることでした。第1講から順に1講ずつ作り、次の講には前の講の全文と点検の結果を渡します。この手順を土台に、2026年10月の初めにA〜Fの6回、毎回別のニュースとして新しく作りました。
- A〜C:仕組み、費用、組織全体の成果、採用判断が逆転する境目など、価値の出し方を探る
- D:個別の指定を外して、通常の指示だけで同じ質が出るかを見る
- E:共通の指示を改訂し、失敗の原因や反対の材料、初期費と継続費の違いまで求める
- F:Eの深さを保ちつつ、安全策や提供条件など、ニュース全体の重要事項を落とさないよう点検する
最後に、Fと既存のAPI版を、方式名を伏せて比べました。後続の講の説明力は、Fが52/60点(86.7%)、API版が30/45点(66.7%)でした。
この点数は、説明の力を見た評価です。事実の正答率ではありません。また、同じモデル・同じ時刻・同じ調査の予算で比べたわけではないので、方式やモデルの優劣の証明にはなりません。API版にも、短くまとまる強みと、競合比較の強みが残りました。
苦労2:26分走って、途中で止まった
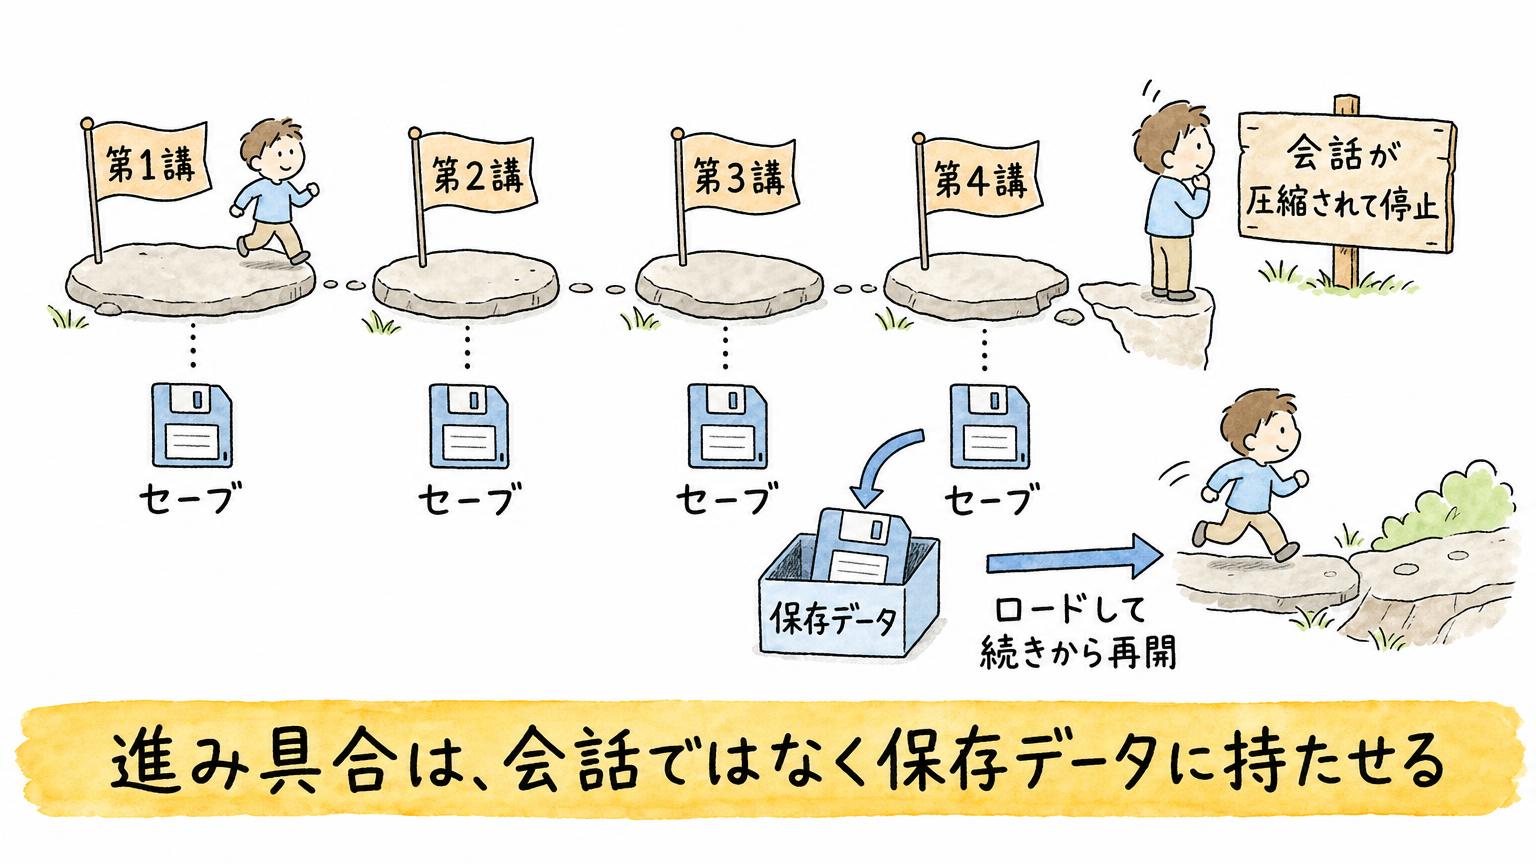
講座を作らせた初回の1つ(F)は、約26分走って、第4講まで進んだところで止まりました。
原因は、ChatGPTの会話が、長い作業の途中で圧縮されたことでした。長くなった会話は、途中で内容がまとめ直されます。そのとき、「この依頼をいま自分が担当している」という印と、「どこまで終わったか」の記録が、抜け落ちてしまいました。
もう一度、担当を名乗り出ても、「すでに処理中です(409 busy)」と断られました。ニュースサービス側には「処理中」の記録が残ったままです。通知は成功し、途中の原稿もありましたが、完成した講座は保存されていませんでした。
会話の中に「どこまで進んだか」を覚えさせるだけでは、長い処理は安定しない。ここが、いちばんのハマりどころでした。
対応は、MCP Eventsの標準機能ではなく、ニュースサービス側に作った仕組みです。ゲームの「セーブ」と「ロード」に近い考え方です。
- 講を1つ書き終えるたびに、そこまでの全講の本文、点検の結果、次に作る講の番号を、暗号化して保存する(セーブ。checkpoint)
- 状態を失ったら、ChatGPTが依頼IDだけを渡して、保存済みのデータを取り直し、続きから作る(ロード。resume)
- 書きかけの講は復元せず、保存済みの入力から書き直す
この修正のあと、Fを同じ依頼の2回目として実行し、5講25問を完成保存できました。段階ごとに前の講の全文が引き継がれ、確定した原稿と保存された本文が一致することも確かめています。
ただし、止まった初回の第4講を、そのまま復元したわけではありません。古い担当の印の期限が切れたあとに同じ依頼をやり直し、修正版の途中保存から復元して最後まで進めた試験です。わざと会話の圧縮を起こして、完全に自動で復旧できるかは、まだ試していません。
学び1:通知は「届いた」までしか保証しない
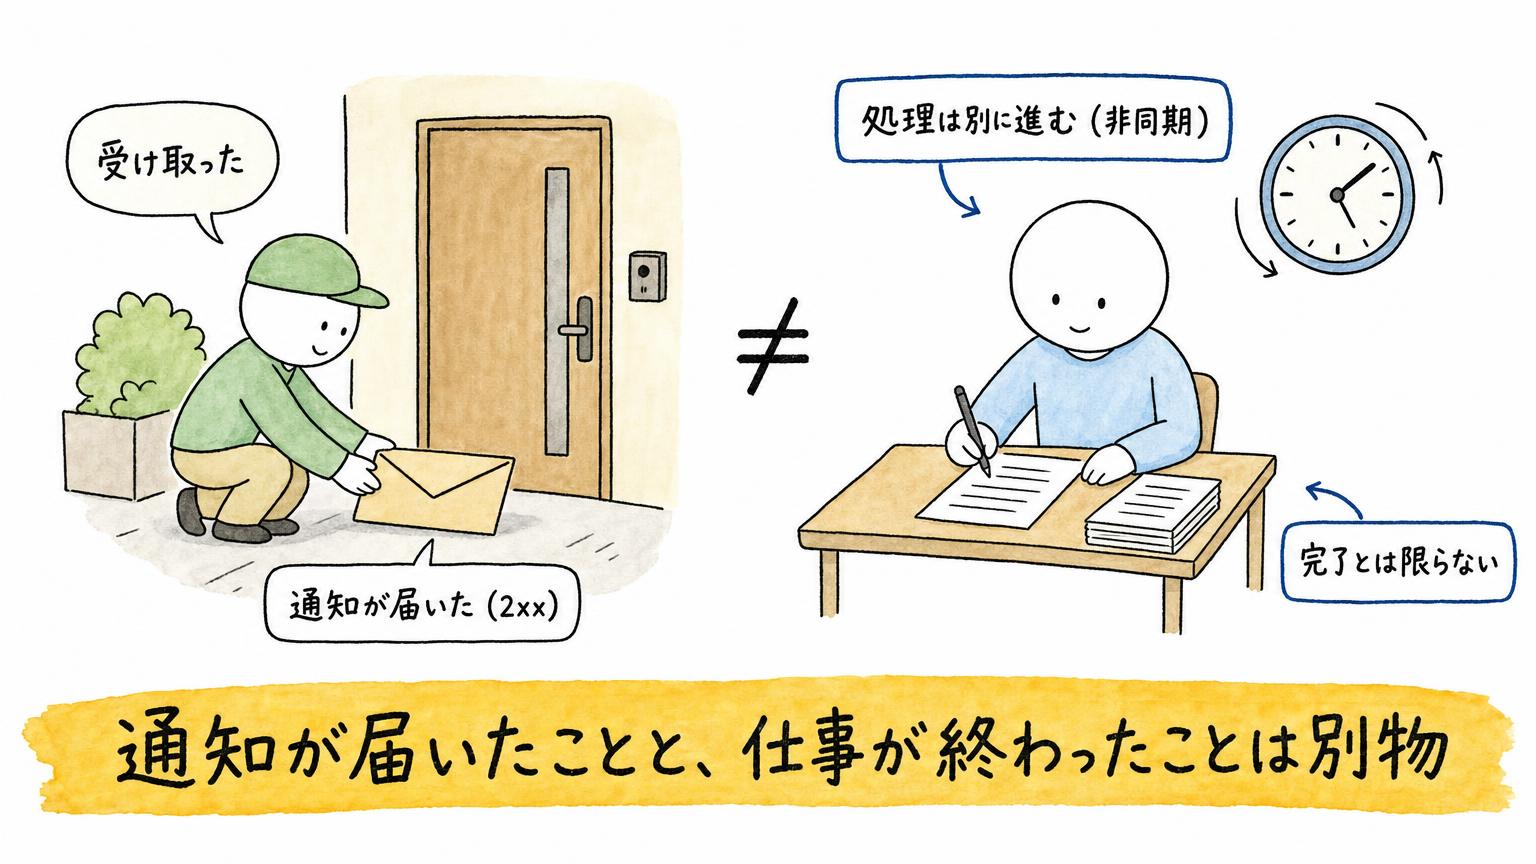
ここは、公式仕様の話です。サービス側の設計に効く点を絞りました。
- 2xxの応答は「受け取った」の印:公式は、2xxを受領の確認、処理は非同期と説明しています。つまり、成功の応答は、調査や保存の完了を意味しません
- 再送は送る側(サービス)の役目:一時的な失敗は、間隔を空けながら、回数を限って再送します。ただし410と413は再送しません。再送してもイベントのIDは同じままで、署名だけ毎回作り直します
- 順序は保証されない:通知は順番どおりに届くとは限りません。1回のリクエストに入るイベントは1つですが、ChatGPT側の設定によっては、複数のイベントが1回の実行にまとめられます
- 書き込みは冪等に:同じ通知が繰り返されても、変更が重複しないようにします。冪等とは、同じ操作を何度行っても結果が同じになることです
- 通知は小さく:リクエスト全体は256KiB(262,144バイト)以下にします。413は再送の対象外です。大きな資料は概要だけを送り、詳細は読み取りのツールで取らせます
つまり、MCP Eventsが担うのは、依頼を届けるところまでです。再送や、重複への備えも、送る側が用意します。その先の「やったか、終わったか、二重になっていないか」は、サービス側が見る必要があります。
学び2:依頼ごとの台帳を、サービス側が持つ
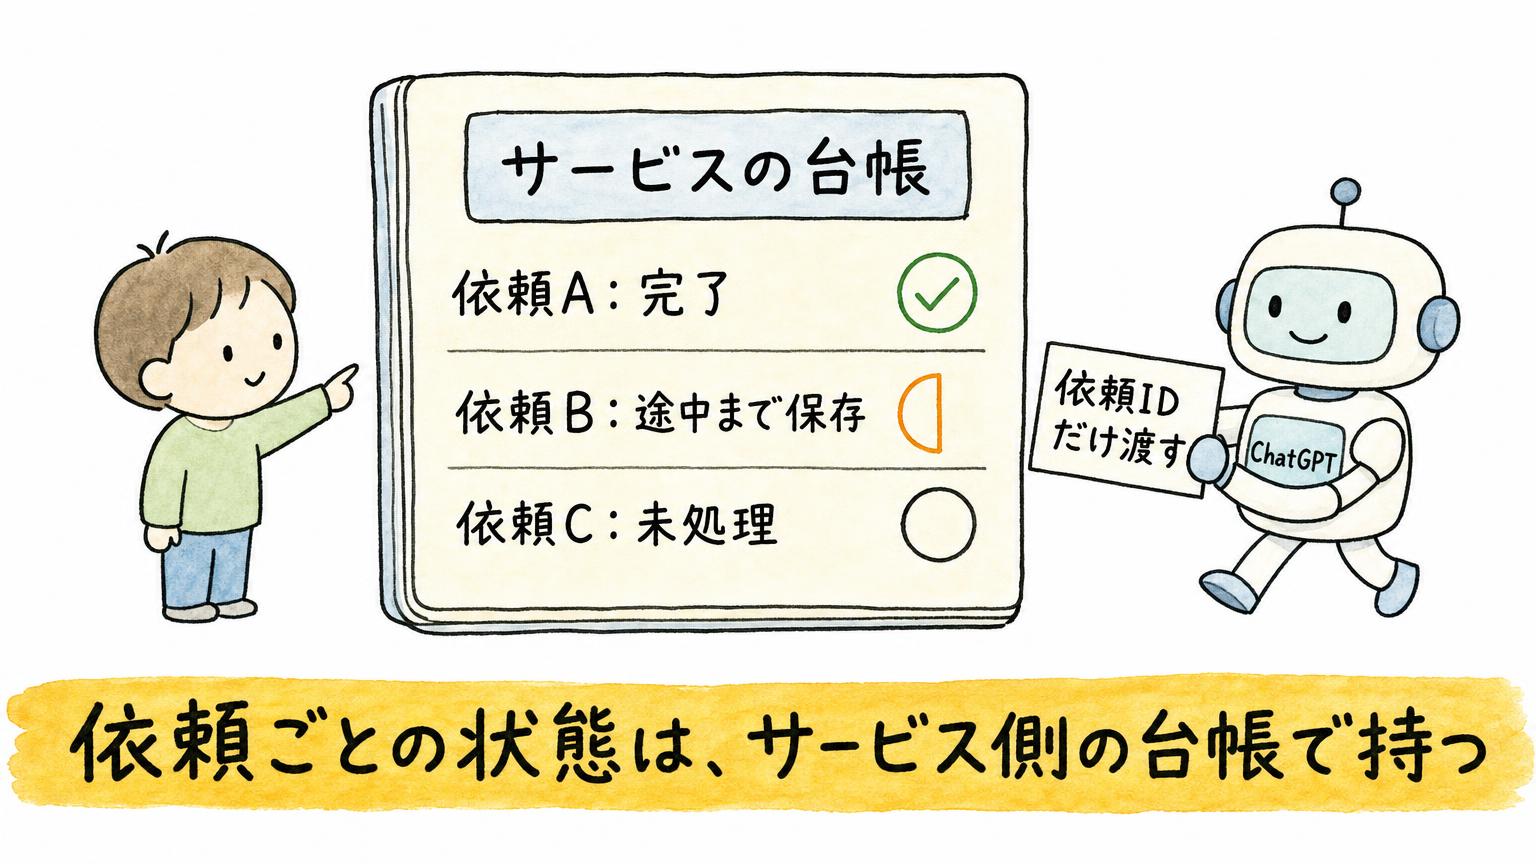
ここは、ニュースサービスで実装して動かした内容と、設計案を分けて書きます。
実装して確かめたこと
- 依頼ごとに、元の資料、固定した作業指示、待機中・実行中・完了の状態、確定済みの途中稿を保存する
- 「この依頼はいま自分が担当している」という印には期限(1時間)をつけ、同じ本人の接続から保存済みの状態があれば、期限が切れたあとでも結び直せる
- 完成の保存には固定の識別子を使い、すでに完成した依頼は作り直さない
- 完成と判定する前に、保存した本文を読み戻す
別の接続として登録し直された場合は、古い接続の暗号化された進捗は読ませず、第1講からやり直す設計にしています。
設計案(実測していません)
- 通知のID(eventId)と、業務の依頼ID(request_id)を分ける。同じ依頼の通知が再送されても、依頼は1つのまま扱える
- 複数の依頼は、Aを取得して実行・保存・読み戻したあとにB、Cへ進む。全部の依頼の担当の印を先に取ると、待っているあいだにも期限が減る
- Bで止まっても、Aは完了、Bは確定した途中段階、Cは未処理、と区別して残す
配送の再送と、作業の途中復元は別の話です。通知の再送を受けられても、書きかけの文章はサービスが保存していなければ戻せません。
完成の保存を二重にしない仕組みは作れます。ただしそれは、重複した通知によるモデルの起動や、利用枠の消費まで防げる、という意味ではありません。
学び3:質は「深く考えて」ではなく、点検の工程で決まる
この学びは、MCP Eventsに限った話ではありません。APIでも、普通のチャットでも使えます。
実測で効いたのは、次の点検でした。
- 前の工程の確定稿を、次へ渡す:1講ずつ、前講の全文と点検の結果を引き継ぐ
- 文量ではなく、理解の増え方を見る:その問いで、どんな理解が増えるか。すでに出た結論の繰り返しになっていないか
- 深さと網羅性を、別々に点検する:Eは説明が深くなった一方、安全策・提供条件・直接比較が抜けました。Fで、構成を決める前に主要な領域を一次資料と対応づけて、抜けを埋めました
- 条件を変えて、判断が逆転する境目を探す:仮の決算比較メモの例では、成功率が同じでも、確認や手直しの手間で所要時間が変わり、準備費を足すと優位が消える境目まで説明できました
- 関連資料は、今回の話とつながるものだけを使う:原文・出所・日付・話者を確かめ、話者が不明な資料は本人の発言と断定しません
「深く考えて」と一括で頼んだだけでは、足りませんでした。何をどの順で点検するかまで、工程として渡して初めて、説明の質が上がりました。
まだ分かっていないこと
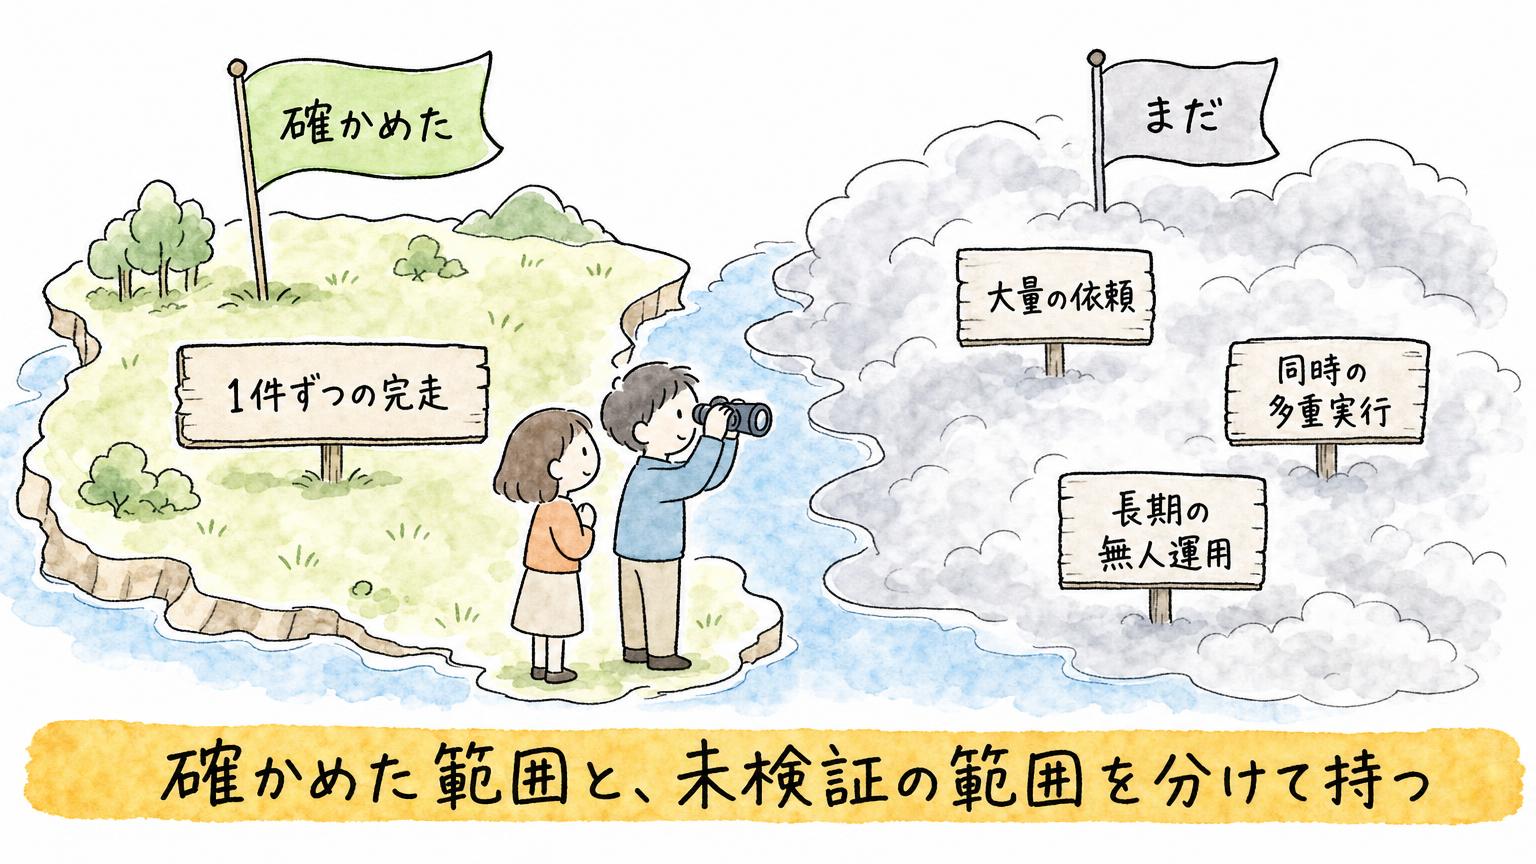
実測した範囲と、分からない範囲を分けておきます。
- 速度:講座全体で、登録から保存まで約15〜21分でした。同じ4講で、API比較版は8分29秒、Eは20分39秒で、約2.43倍の時間です。ツールの実行時間は合計で1分に満たず、大半はツールの合間のモデルの応答ですが、推論・執筆・点検・待機の内訳は分けられていません
- 費用:ニュースサービスの生成APIを呼ばずに、本人のChatGPT側で処理できたことは確認しました。ただし、この講座だけの消費量や、1件あたりの金額は算出できていません。OpenAIの管理者向けFAQによると、ChatGPT WorkとCodexは価格・クレジット・利用上限を共有します(プランによって管理の方法は異なります)。データベースや配備、通知の基盤の費用も残ります
- モデル:GPT-6.1 Solと高い推論の設定を希望として渡しましたが、実際にイベントで動いたモデルは、確認も強制もできませんでした
- 規模と期間:完成させた実績は、修正版のFで1回です。複数のイベントが1回にまとめられた場合の全依頼の完走、同時の多重実行、大量の投入、購読の自動更新を含む長期の無人運用は、試していません
- 自動復旧:作業の実行そのものが終わってしまった場合に、自動で再起動する見張りは付けていません。その場合は、同じチャットに「この依頼IDを同じ依頼のまま再開して」と頼む運用です
この実験は、2026年10月の初めの時点の記録です。利用枠や接続の状態が、将来も同じである保証はありません。
試すなら、最初に決める3つ(提案)
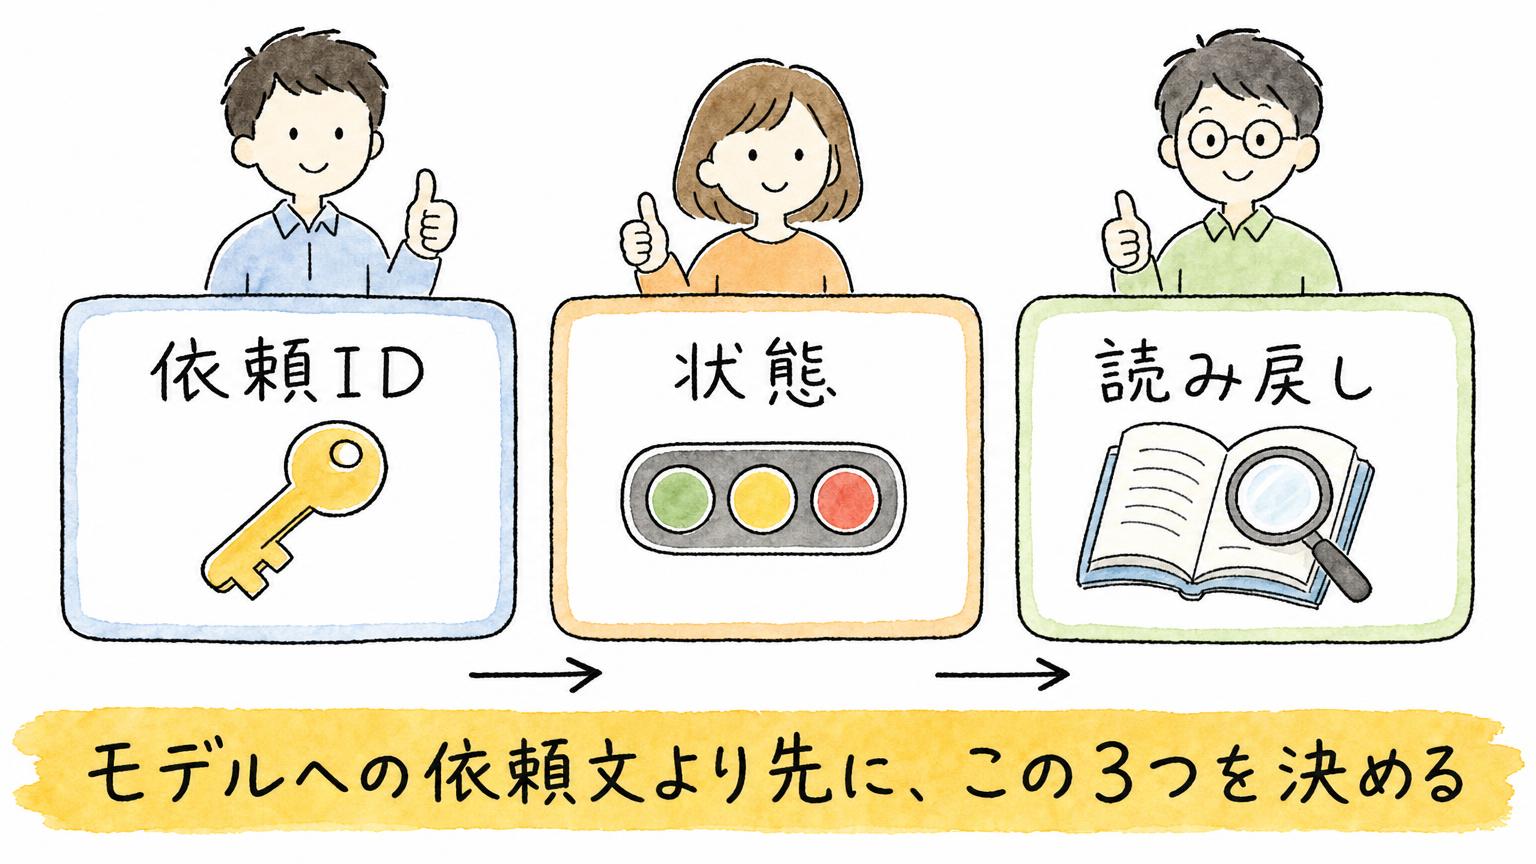
この章は実測ではなく、提案です。自分のサービスでMCP Eventsを試すなら、モデルへの依頼文より先に、次の3つを決めてください。
- 依頼ID:通知とは別に、業務の依頼を一意に区別するIDを決める
- 状態:待機中・実行中・完了と、途中まで確定した成果物を、どこに保存するか
- 読み戻し:完成の判定を、通知の成功ではなく、保存した成果物の読み戻しにする
サブスクリプションの枠をAPIのように使う発想には、実用性があります。ただし、それを支えるのは、依頼の台帳と、途中の保存と、点検の工程でした。
よくある質問(FAQ)
Q1. MCP Eventsで、ChatGPTのサブスク枠をAPIの代わりに使えるのか?
実験では、ニュースの登録をきっかけに利用者のChatGPT側で調査と執筆が進み、解説講座の保存まで届きました。ただし、この講座だけの消費量や1件あたりの金額は算出できていません。大量・同時・長期の運用も試していないため、「必ず動く」とは言えません。
Q2. MCP Eventsの2xx応答は、処理の完了を意味するのか?
意味しません。公式仕様は、2xxを受領の確認、ChatGPTの処理は非同期と説明しています。完了の判定には、保存した成果物を読み戻して確かめるなど、サービス側の確認が要ります。
Q3. 長い処理が途中で止まったら、どう復旧するのか?
会話に進み具合を覚えさせず、講を1つ書き終えるたびに状態を暗号化して保存します。止まったら依頼IDだけを渡して、保存済みのデータから続きを再開します。これはMCP Eventsの標準機能ではなく、サービス側に作った仕組みです。
エージェントにどこまで任せ、どこで線を引くか。AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」で、実務を持ち寄りながら探っています:https://frontier-leaders.vercel.app/
2時間で、AI活用術を実践のハンズオンで学べます。ChatGPT Workでの自動化術など、過去回のアーカイブ:https://handson.workstyle-evolution.co.jp/
YouTube『いけともch』で、最新のAIニュースを毎日解説しています:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事

公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ