Codexに頼んで、超小型の判断AI「Laya」を自分向けにファインチューニングしてみた。約8分で変わったことと、増えた見逃し
Codexに頼んで、超小型の判断AI「Laya」を自分向けにファインチューニングしてみた。約8分で変わったことと、増えた見逃し
- 超小型の判断AI「Laya」を、Codexに頼んで記事タグの付け方に合わせて追加学習させた実験です。
- 学習は約8分で、12タグの完全一致は1/100から57/100に、過剰なタグは885個から30個に減りました。
- 一方で見逃しは14個から26個に増え、結果は合成記事での検証で、実務での精度は未確認です。
超小型の判断AI「Laya」を、「私向けの記事分類基準」に合わせてファインチューニング(追加学習)できるか。Codexに頼んで試してもらいました。Codexは、コードを書いて動かす作業をAIが進めてくれるツールです。
先にお断りします。使ったのはCodexが書いた合成記事(AIが作った架空の記事)だけです。数字はその範囲での結果で、Layaの一般的な精度でも、私の実務での精度でもありません。
目次
Layaとは何か
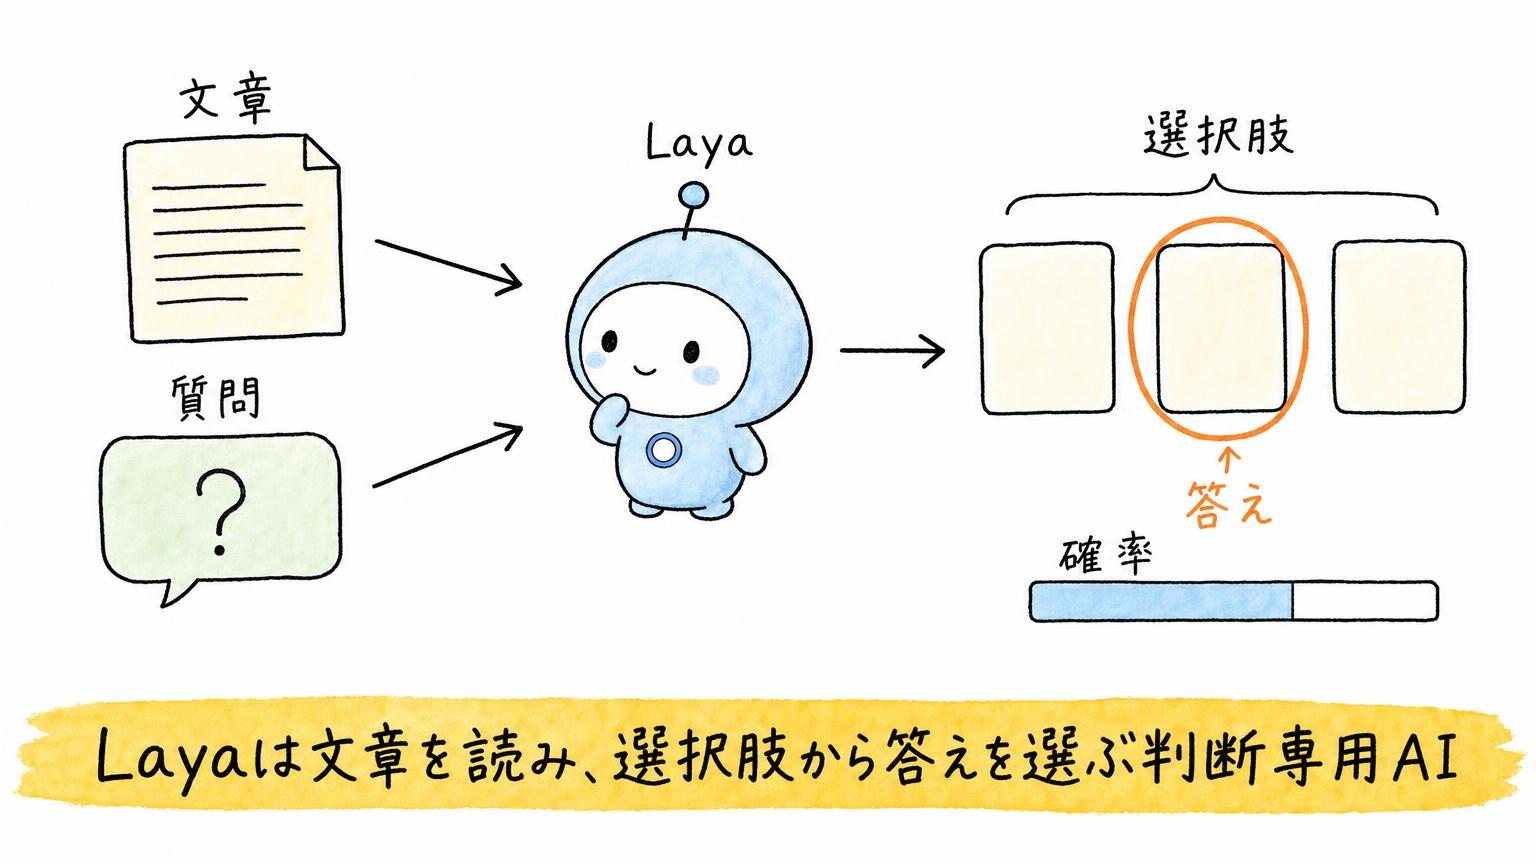
Layaは、Hugging Face上のInfin8-AIで公開されている、文章を読んで判断する専用の超小型AIモデルです。
ChatGPTのように文章を書くモデルではありません。メールやチケットなどの文章と、「どれに当てはまるか」といった質問を受け取り、選択肢から答えを選んで、その確からしさ(確率)を返します。メールの振り分けや問い合わせの仕分けなどが、想定された使い道です。
大きさは、今回使った多言語版で約3.2億パラメータです。パラメータとは、モデルの内部にある調整可能な数値のことで、判断のクセはここに入っています。
今回やったこと
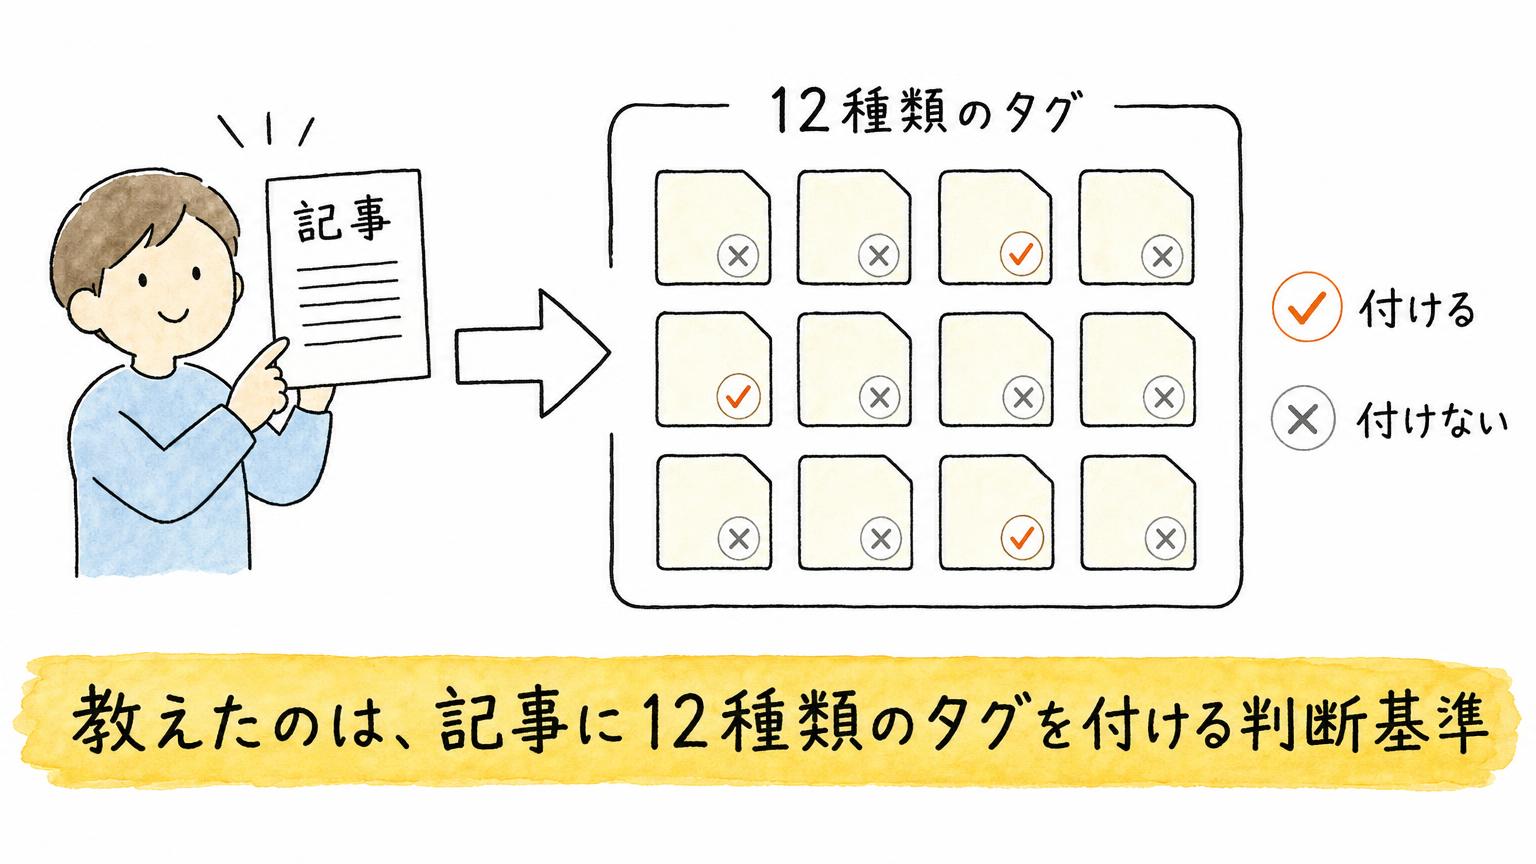
教えたのは、AIニュースや記事に「タグ」を付ける基準です。タグは、新しいモデルの公開、エージェント、コンテンツ制作、画像/音声など、事務作業、業務の自動連携、安全性/権限/規制、事業への影響、品質/速度の検証といった、全部で12種類です。1つの記事に複数のタグが付くこともあります。
目的は、私の文体や人格を覚えさせることでも、文章を書くモデルを作ることでもありません。「この記事にはこのタグを付ける」という判断の基準を、調整できるかの確認です。日本語や一般知識をゼロから教えたわけではなく、元のモデルが持つ文章を読む力を土台に使っています。
準備したもの
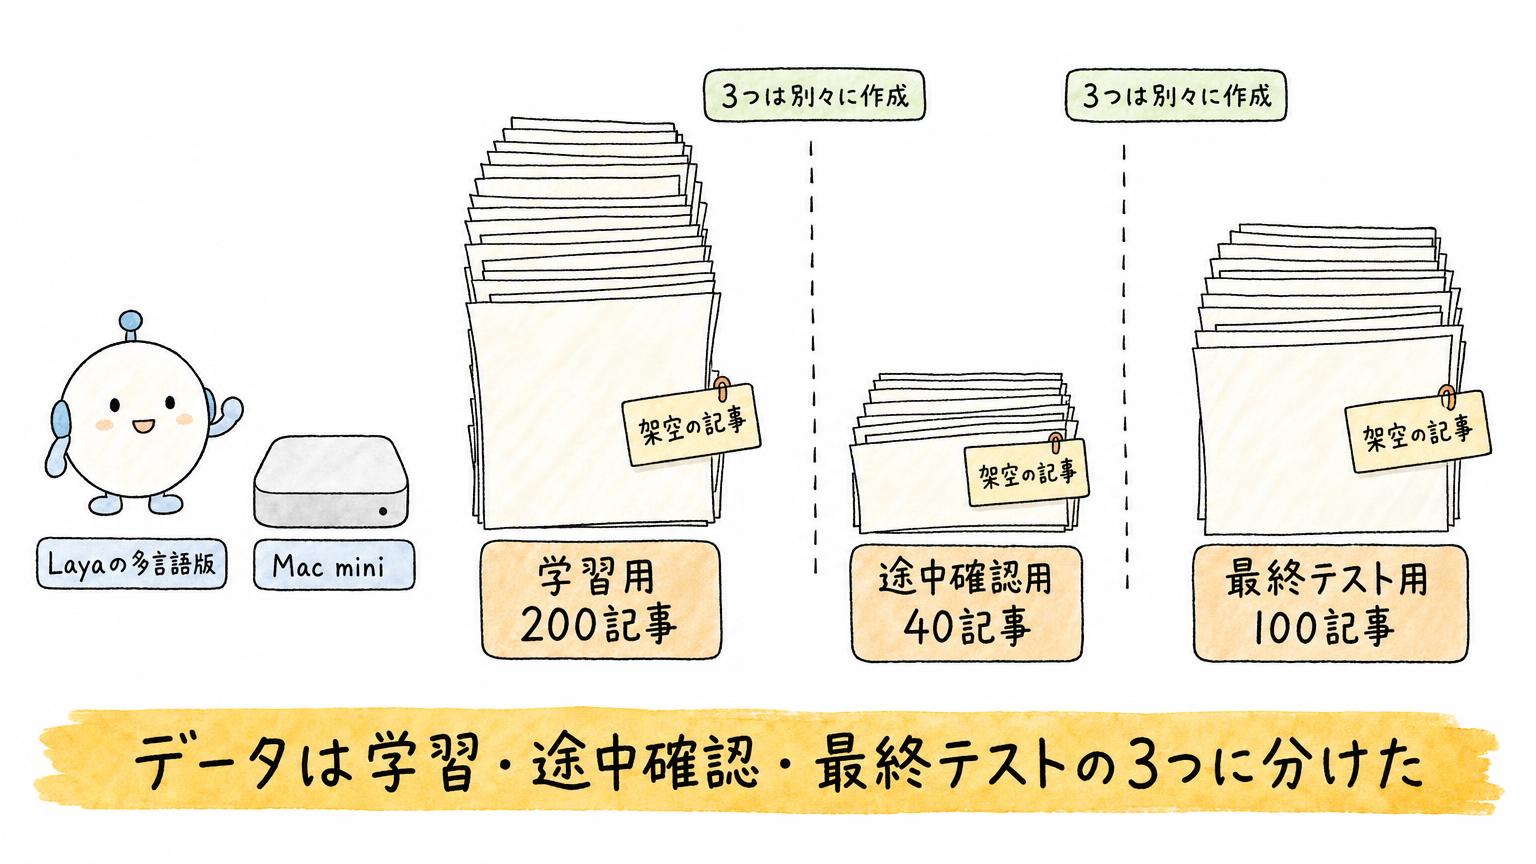
- モデル … Infin8-AI/layaの多言語版
- データ … Codexが書いた架空の短い記事。学習用200記事、途中確認用40記事、最終テスト用100記事。3つは別々に作っています
- 環境 … Mac mini(M4 Pro、メモリ64GB)の既存のPython環境
私が正解を認定した実記事は使っていません。AIに見せるのは記事のタイトルと本文だけで、正解のタグや理由は混ぜません。12のタグそれぞれについて、「付ける/付けない」を独立した2択で答えさせます。
どう学習させたか
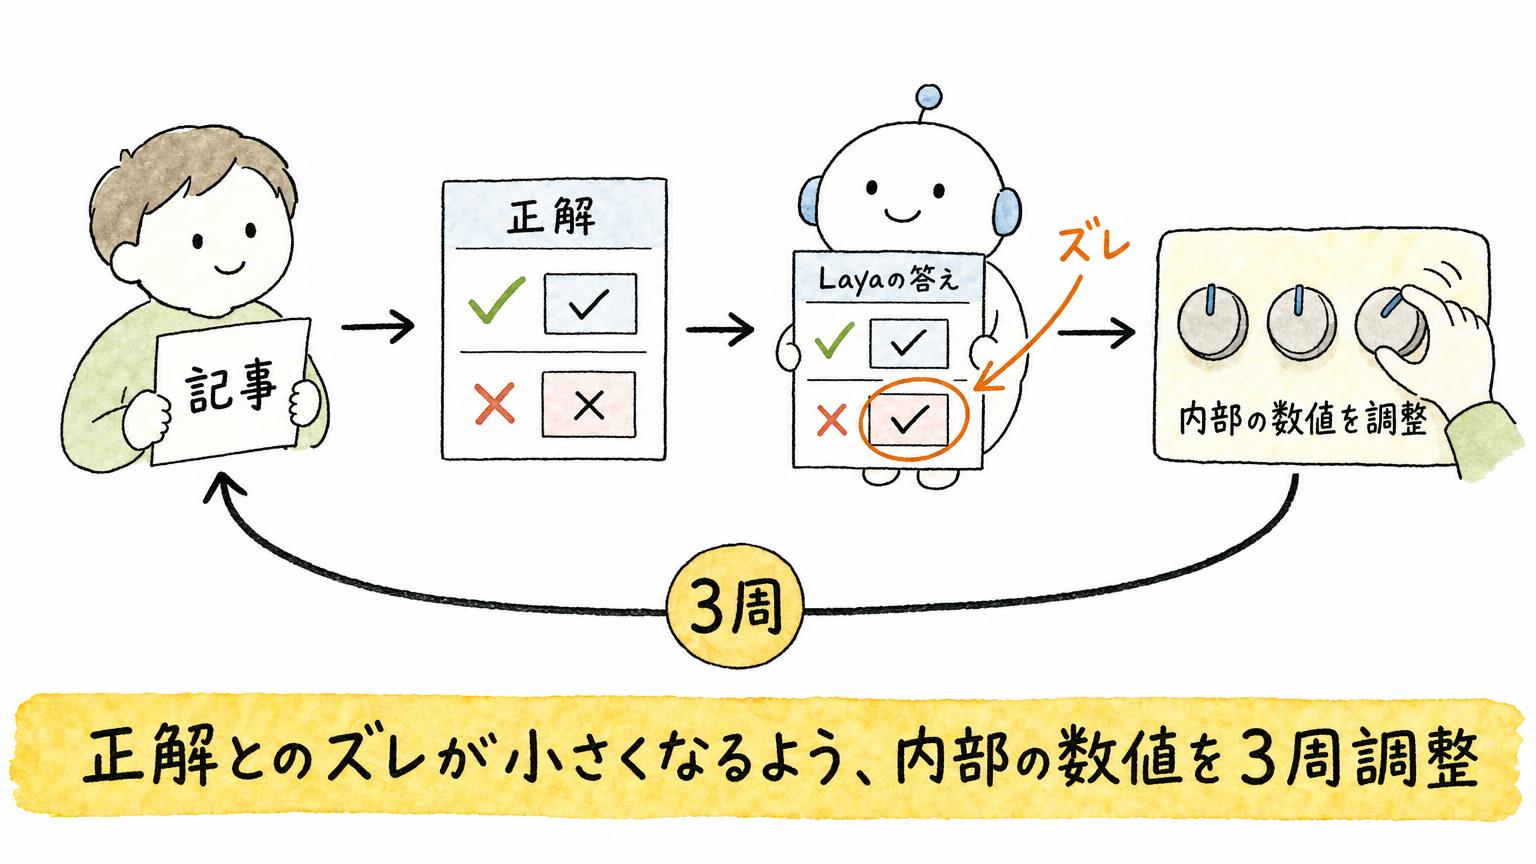
方法は、教師ありファインチューニング(追加学習)です。記事とタグの組に「付ける(1)/付けない(0)」という正解を添えて見せ、答えと正解のズレが小さくなるように調整します。
文章を読む部分と判断する部分は、元の重みを直接更新しました。重みとは、判断を左右する内部の数値のことです。使っていない一部は固定したので、正確には「全部」ではなく「主要な部分」の直接更新です。
気になるのはLoRAとの違いでしょう。LoRAは、元の重みを固定したまま、小さな追加部品だけを学習する方法です。今回はLoRAではありません。「何を教えるか(正解例から学ぶ)」と「どこを更新するか(直接更新かLoRAか)」は別の軸で、組み合わせることもできます。LoRAとは比べていないので、直接更新のほうが優れているとは言えません。
学習は、200記事×12タグを3周しました。
なぜ約8分で済んだのか
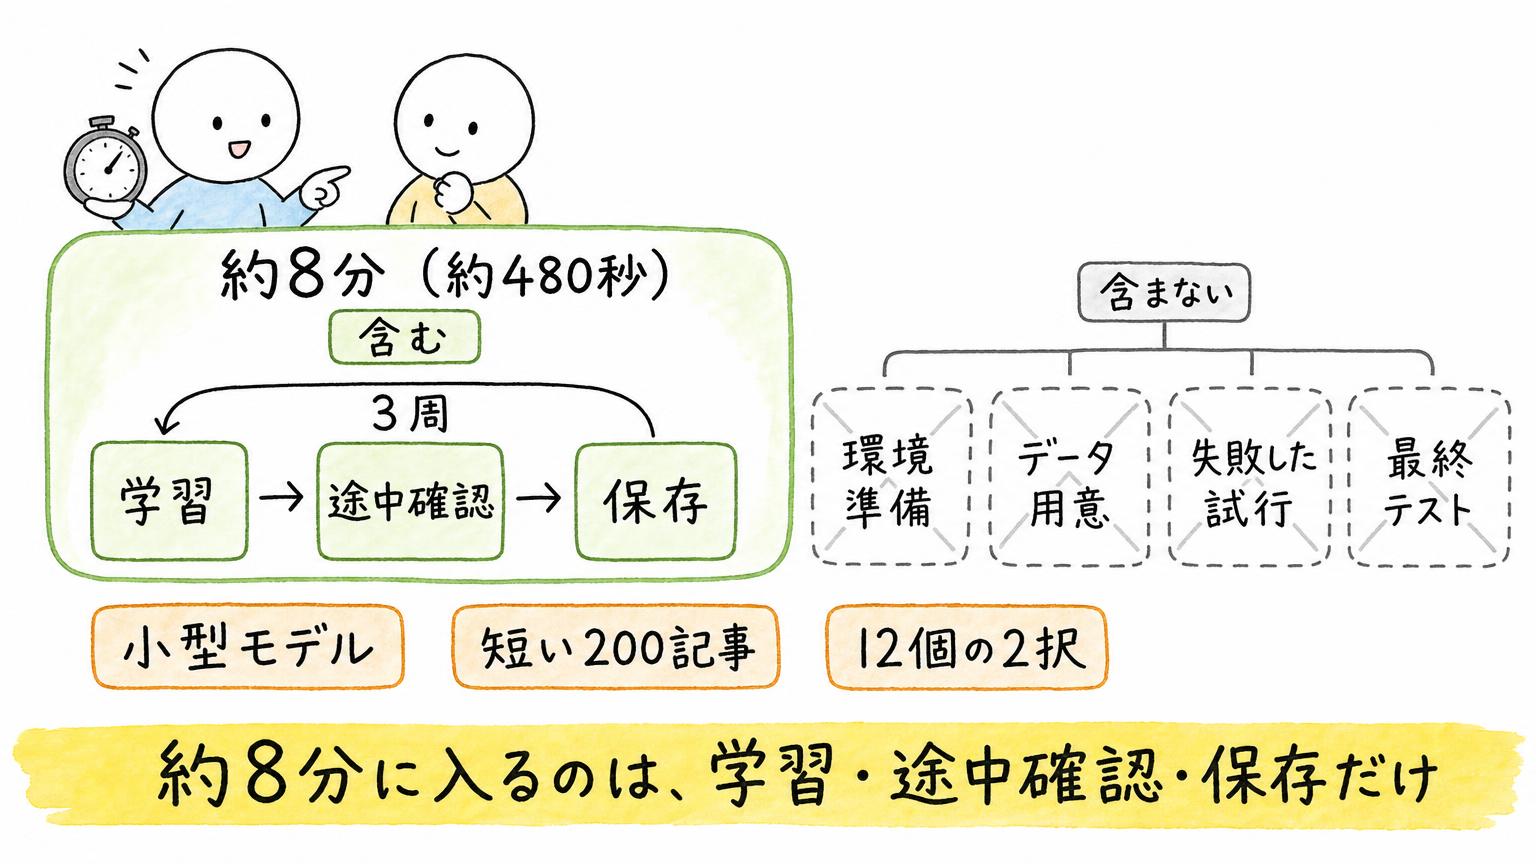
成功した学習にかかったのは約480秒、約8分です。含まれるのは、学習、各周ごとの途中確認、保存です。環境の準備、データの用意、失敗した試行、最終テストは含みません。
短く済んだのは、モデルが小型で、データが短い200記事で、12個の2択という限られた追加学習だったからです。メモリ64GBは今回の機器の条件で、最低条件ではありません。大きなモデルや大量のデータで8分で終わる、とは言えません。
何が変わったか
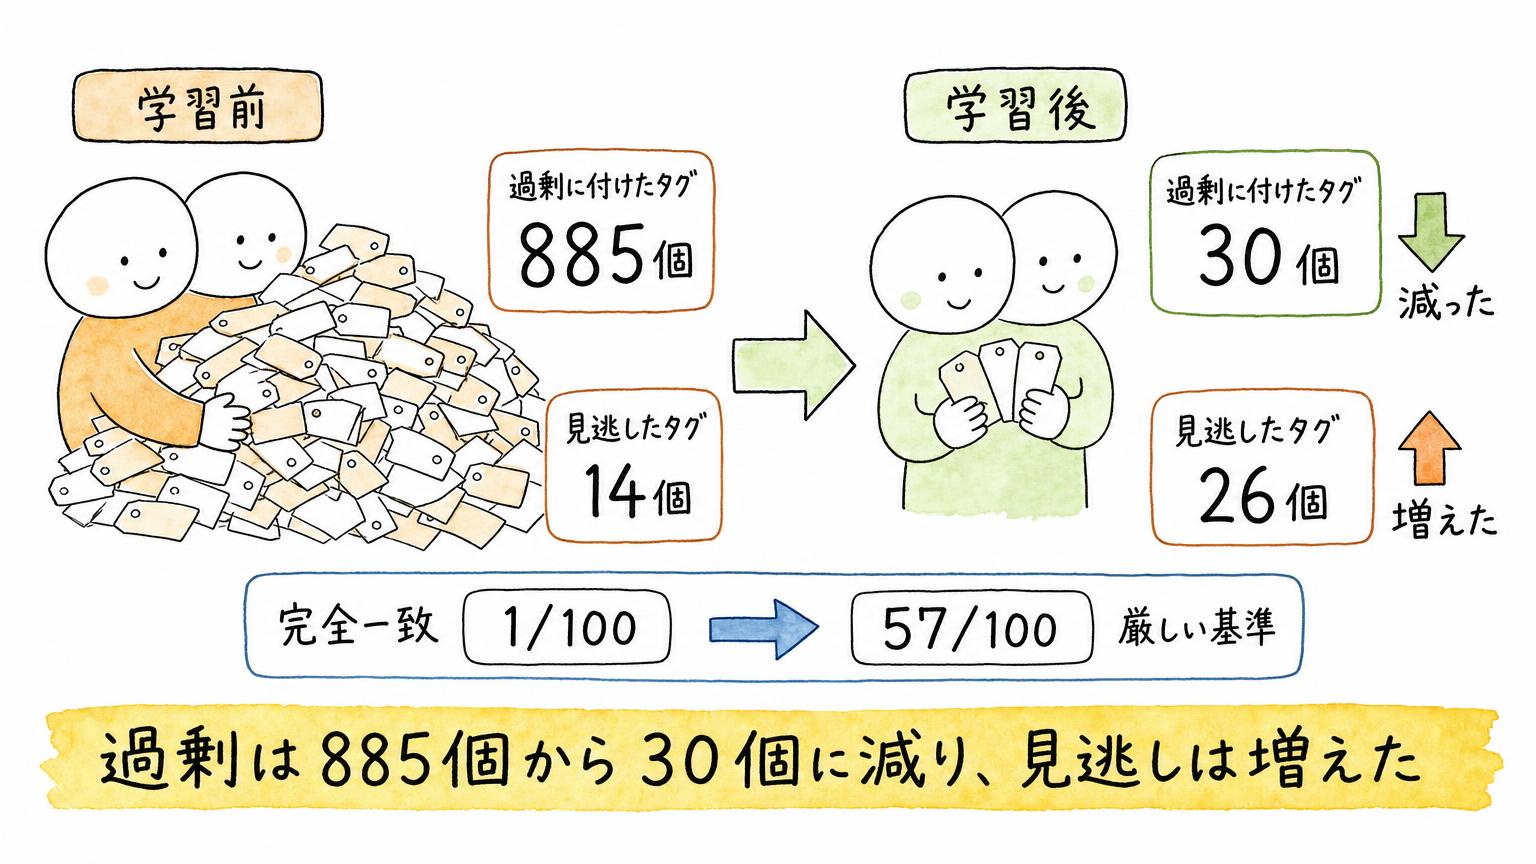
12タグの完全一致は、1/100から57/100になりました。完全一致とは、1記事に必要なタグをすべて拾い、不要なタグを1つも付けないことです。一般的な正解率ではなく、かなり厳しい基準です。
学習前は、100記事のうち59記事で12個すべてのタグを付けていました。1記事の平均は約11個。正解の平均は約2.2個で、学習後は約2.2個です。何でも付けてしまう偏りが収まったことが、最大の変化でした。これは今回の質問の形(固定の質問文での12個の2択)での結果で、質問文を工夫した場合との比較はしていません。
- 過剰に付けたタグ … 885個から30個
- 見逃したタグ … 14個から26個
- 付けたタグのうち正しかった割合 … 約19%から約87%
- 必要なタグを拾えた割合 … 約94%から約88%
見逃しは増えています。同じ記事で比べると、不一致から完全一致になったのが56件、その逆は0件でした。ただタグ単位では、直した誤り867個に対して、新しい誤りが24個生まれています。「悪化なし」とも「完全解決」とも言えません。
改善例と見逃し例
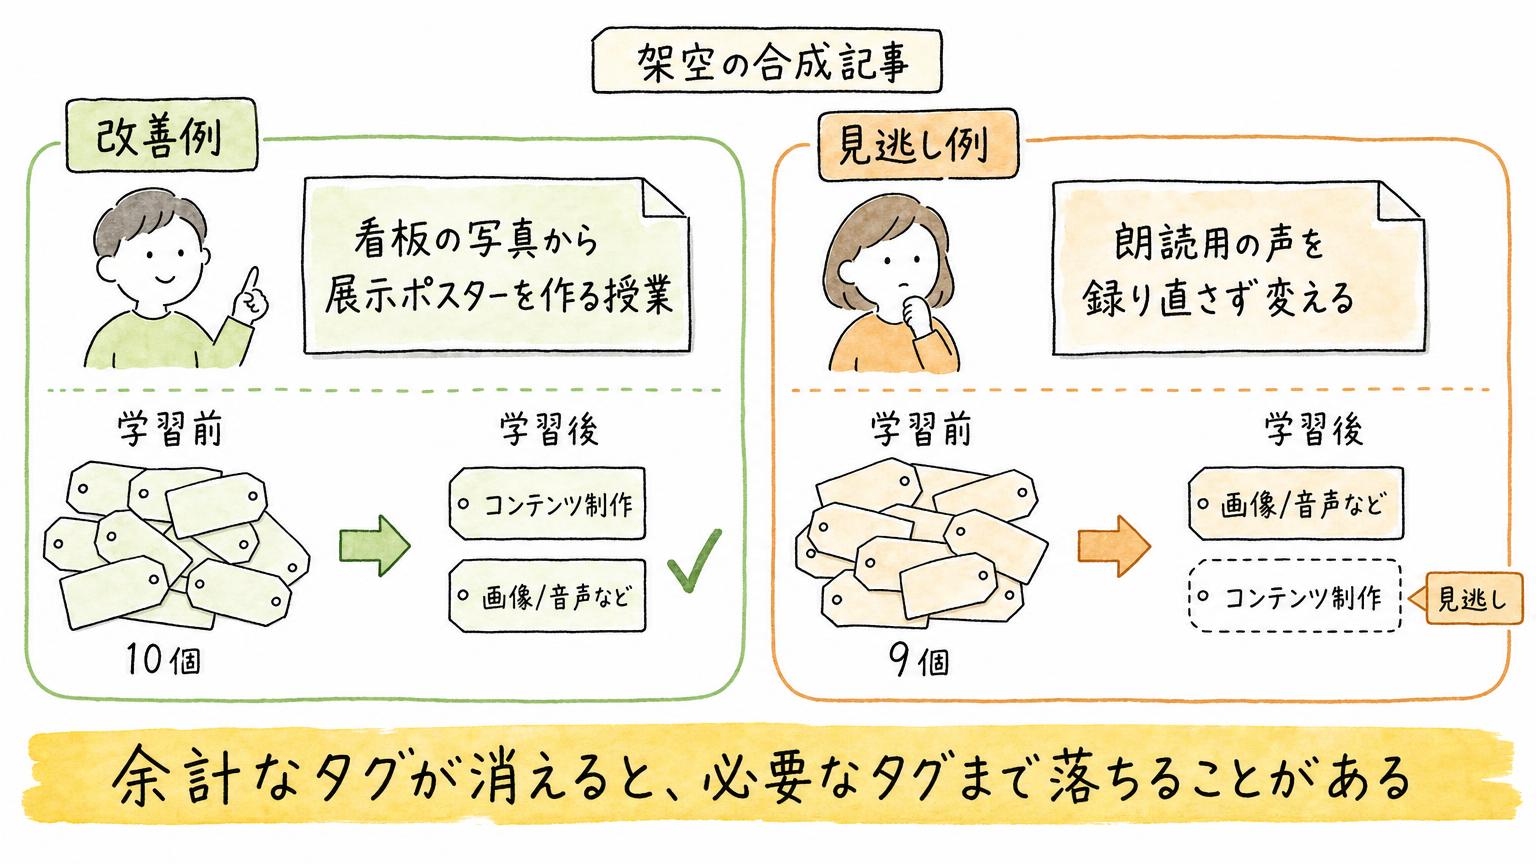
次の例は、すべてCodexが書いた架空の記事です。
改善例は「看板の写真から展示ポスターを作る授業」です。正解は「コンテンツ制作」と「画像/音声など」。学習前は、開発支援・エージェント・事務作業など余計なものを含めて10個付けていましたが、学習後は正解の2つだけになりました。
見逃し例は「朗読用の声を録り直さず変える」です。録音済みの朗読を声変換して、会場で流す音声作品にします。正解は同じく「コンテンツ制作」と「画像/音声など」。学習前は9個付けていましたが、学習後は「画像/音声など」だけになり、「コンテンツ制作」を見逃しました。不要なタグを減らすと、必要なタグまで落ちることがあります。
難しかったところ
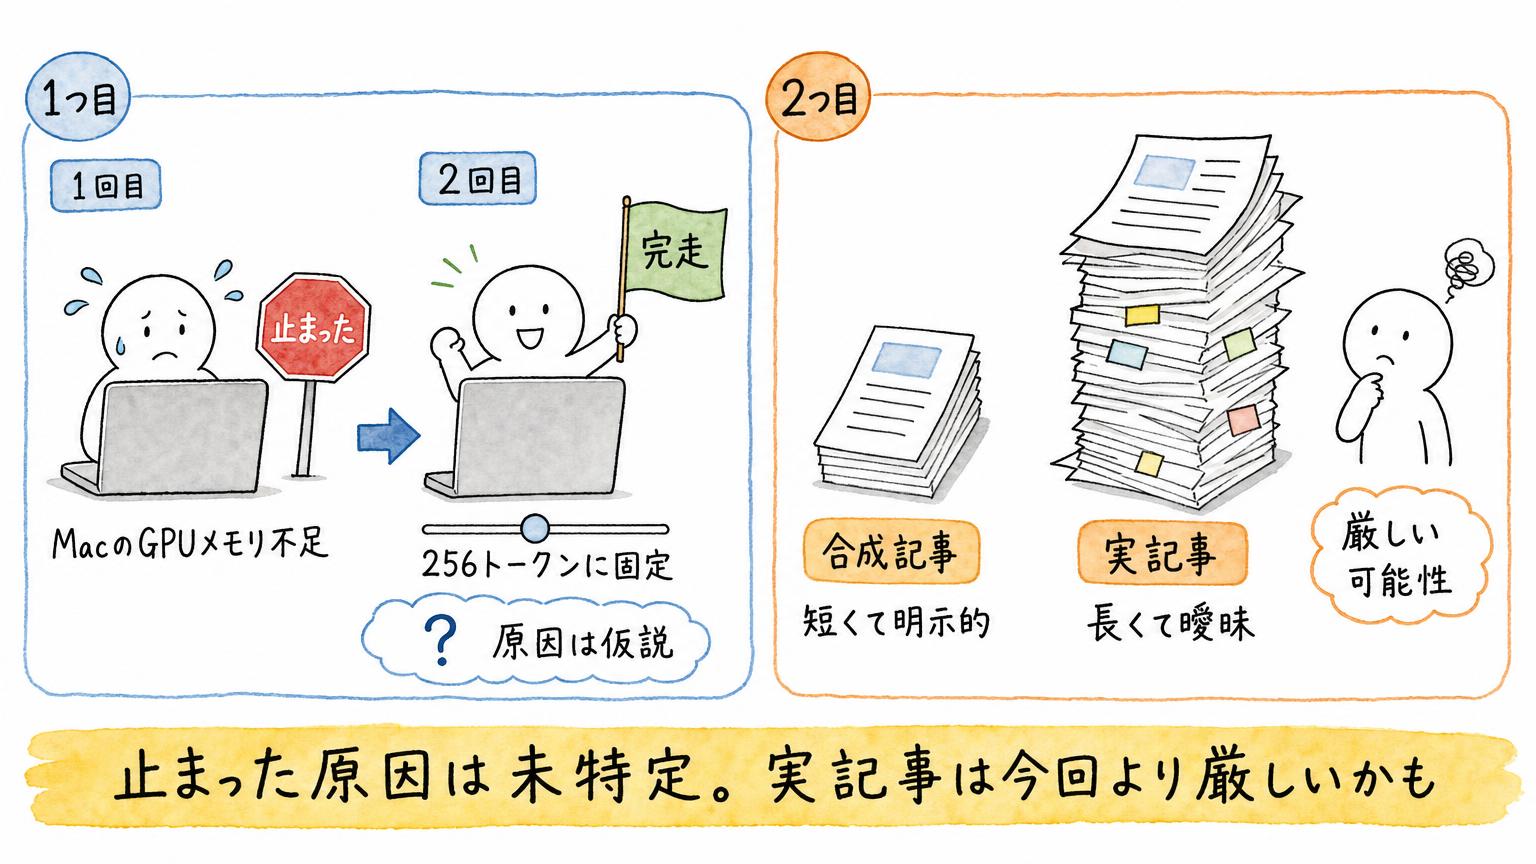
1つ目は、メモリ不足です。最初の学習は、MacのGPUメモリが足りなくなって途中で止まりました。2回目は、計算する長さを256トークンに固定する設定だけを変えて、同じ元のモデルからやり直し、完走しました。本文は切り捨てていません。入力の長さが影響したという見立てはありますが、仮説で、原因は特定できていません。
2つ目は、評価が甘い可能性です。今回の記事は短く、主題も否定も文中で明示されています。実際の記事は長く、曖昧な書き方も出てくるので、今回より厳しくなる可能性があります。
「いけとも版Laya」とは何か
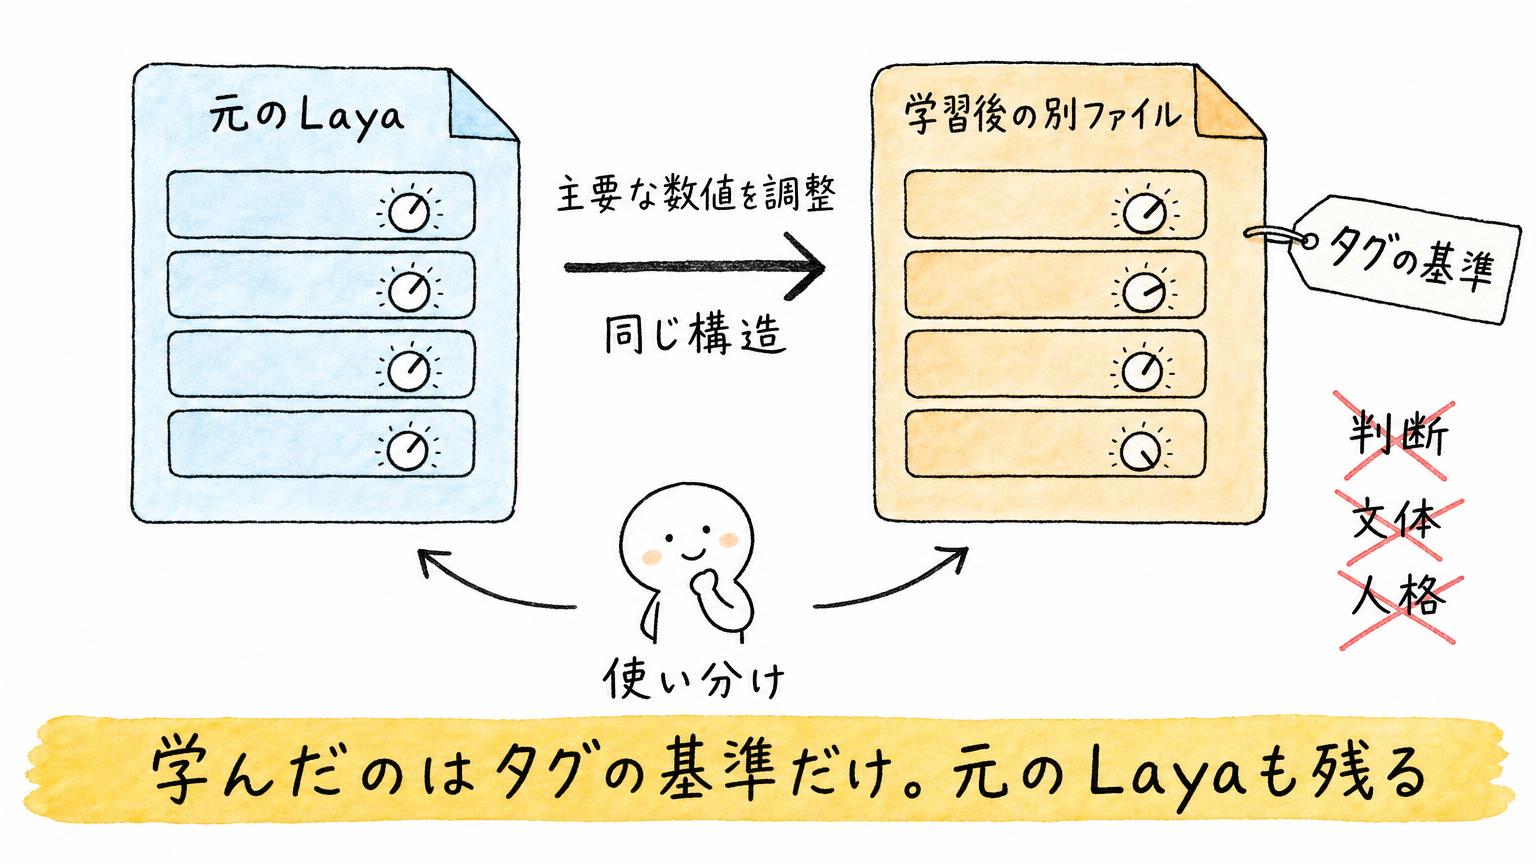
できたのは、元と同じ構造のまま、主要な内部数値を調整した派生モデルです。新しい層を足したわけでも、ゼロから作ったわけでもありません。元の重みはそのまま残り、学習後の重みは別ファイルなので、使い分けられます。
「いけとも版Laya」と呼んでいますが、正確には「私向けのタグ基準を、合成データで学んだ試作モデル」です。私の判断や文体、人格を学んだものではなく、実務で使えるかどうかも未確認です。
今後の可能性
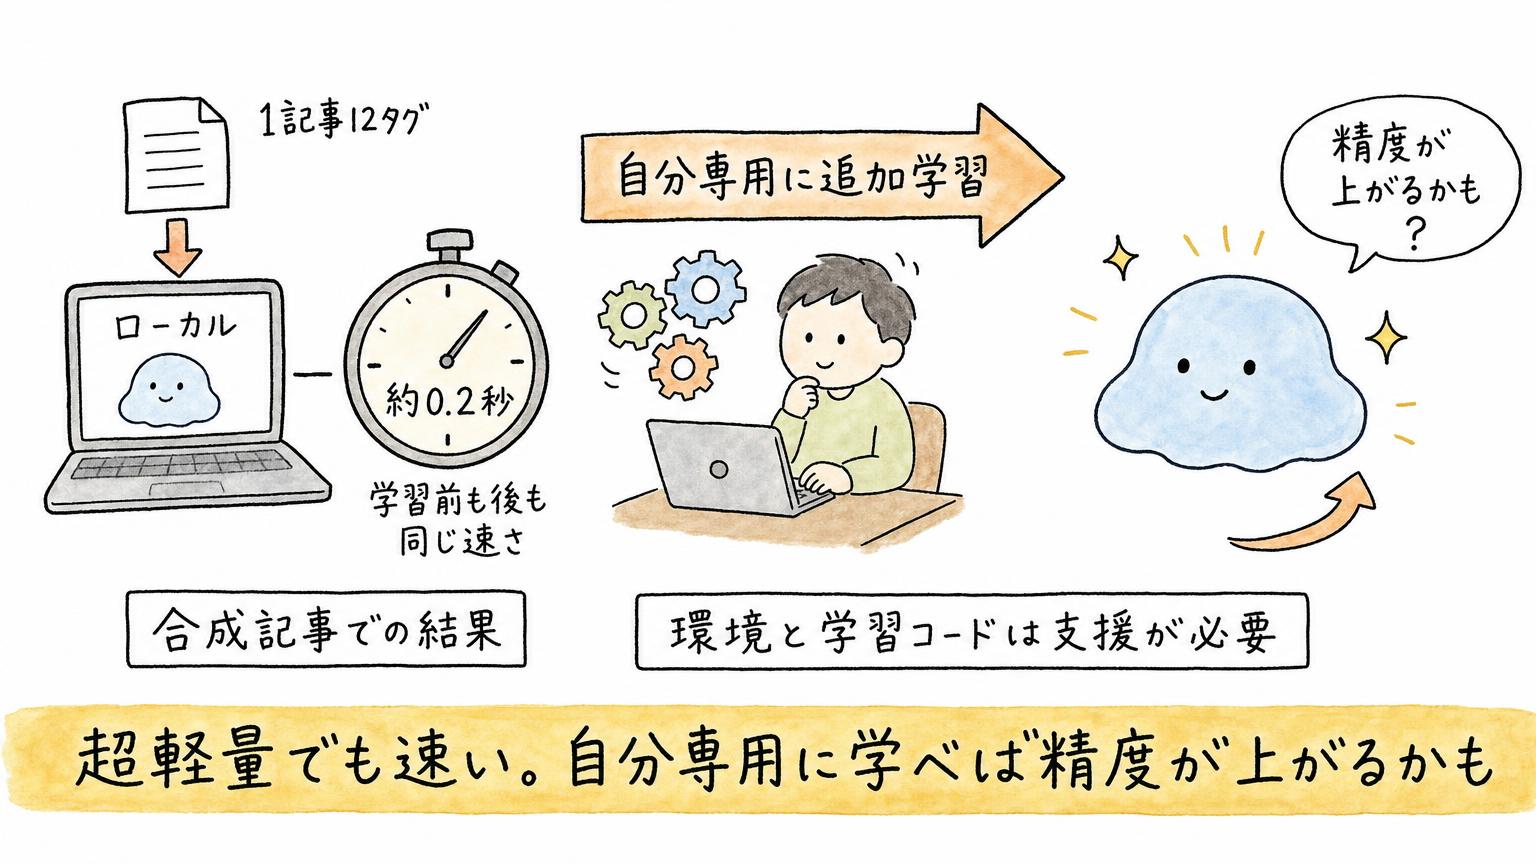
それでも、今回の実験には大きな可能性を感じます。
Layaのような超軽量のモデルでも、ある程度の分類であれば、ローカルで超高速に動かせます。今回の計測では、1記事12タグの判断が中央値で約0.2秒でした(モデルの読み込みなどを除く。学習の前後で速さは変わっていません)。そのうえで自分専用にファインチューニングすれば、精度を上げながら使える。そんな使い方ができるかもしれません。
ただし、ここまでの根拠は合成記事での結果です。ゼロから環境と学習コードを組むのは初心者には難しめで、今回はコードや環境、エージェントの支援がありました。誰でもボタン1つでできる、という話ではありません。
次にやること
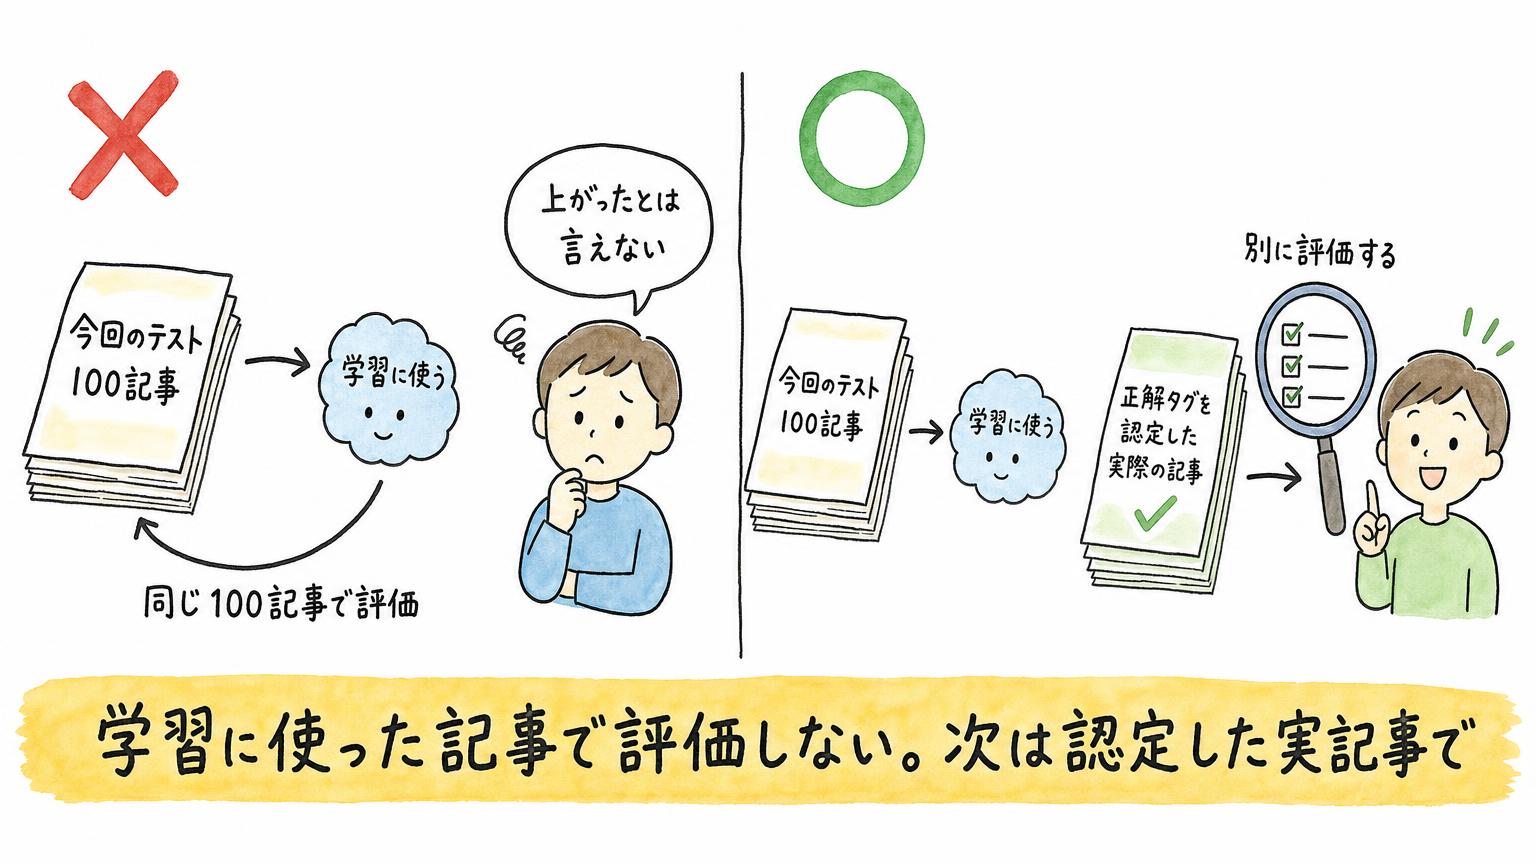
次は、私が正解タグを認定した実際の記事で、別に評価する必要があります。今回のテスト100記事を学習に使ったあとで、同じ100記事で性能が上がったと言うことはできません。
よくある質問(FAQ)
Q1. Layaとは何をするAIモデルですか?
文章を書くモデルではなく、文章と質問を受け取り、選択肢から答えを選んで確率を返す判断専用の超小型モデルです。今回使った多言語版は約3.2億パラメータで、メールの振り分けや問い合わせの仕分けなどが想定された使い道です。
Q2. Layaのファインチューニングは本当に約8分で終わるのですか?
今回の学習は約8分でした。含まれるのは学習、各周ごとの途中確認、保存で、環境の準備、データの用意、失敗した試行、最終テストは含みません。小型のモデルに、短い200記事で、12個の2択を追加学習させた条件での結果で、大きなモデルや大量のデータで8分で終わるとは言えません。
Q3. ファインチューニングしたLayaは実務で使えますか?
まだ言えません。今回の結果はCodexが書いた合成記事での検証で、12タグの完全一致は1/100から57/100に上がった一方、見逃したタグは14個から26個に増えました。実務で使えるかを確かめるには、私が正解タグを認定した実際の記事で、別に評価する必要があります。
AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」:https://frontier-leaders.vercel.app/
2時間で、AI活用術を実践のハンズオンで学べます(過去回のアーカイブ):https://handson.workstyle-evolution.co.jp/
YouTube『いけともch』:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事

公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ