AgentsViewとは?Claude CodeやCodexの履歴1.4万件を集めて検索し、費用と知識に変える
- AgentsViewは、複数のAIコーディングエージェントの履歴を手元のDBに集めて検索できる無料ツールだ
- 費用や作業の質を見られるうえ、過去の会話から次の仕事に使える知識を取り出すRecallが本命になる
- 抽出した知識は人が承認して初めて信頼できる。送信先と鍵の混入には注意が必要だ
AIコーディングの履歴を1か所にまとめて検索できるツール「AgentsView」が話題です。Claude CodeやCodexなど、複数のエージェントの記録を、手元のデータベースに集めます。
作ったのは、Wes McKinney氏が率いる小さな開発チームです。無料のオープンソースで、保存先は手元が基本です。
集めて見るだけでも、費用と作業の振り返りに役立ちます。ただ、本命は、過去の会話から次の仕事に使える知識を取り出す「Recall」です。取り出した知識は、人が承認して初めて、信頼できる形になります。
僕の手元には、12種類のエージェント、約1.4万件の履歴が入っていました。そこから約5.9万件の知識を取り出しています。実際の画面とあわせて、集めたあとの使い道まで見ていきます。
12種類・約1.4万件を1つのDBへ
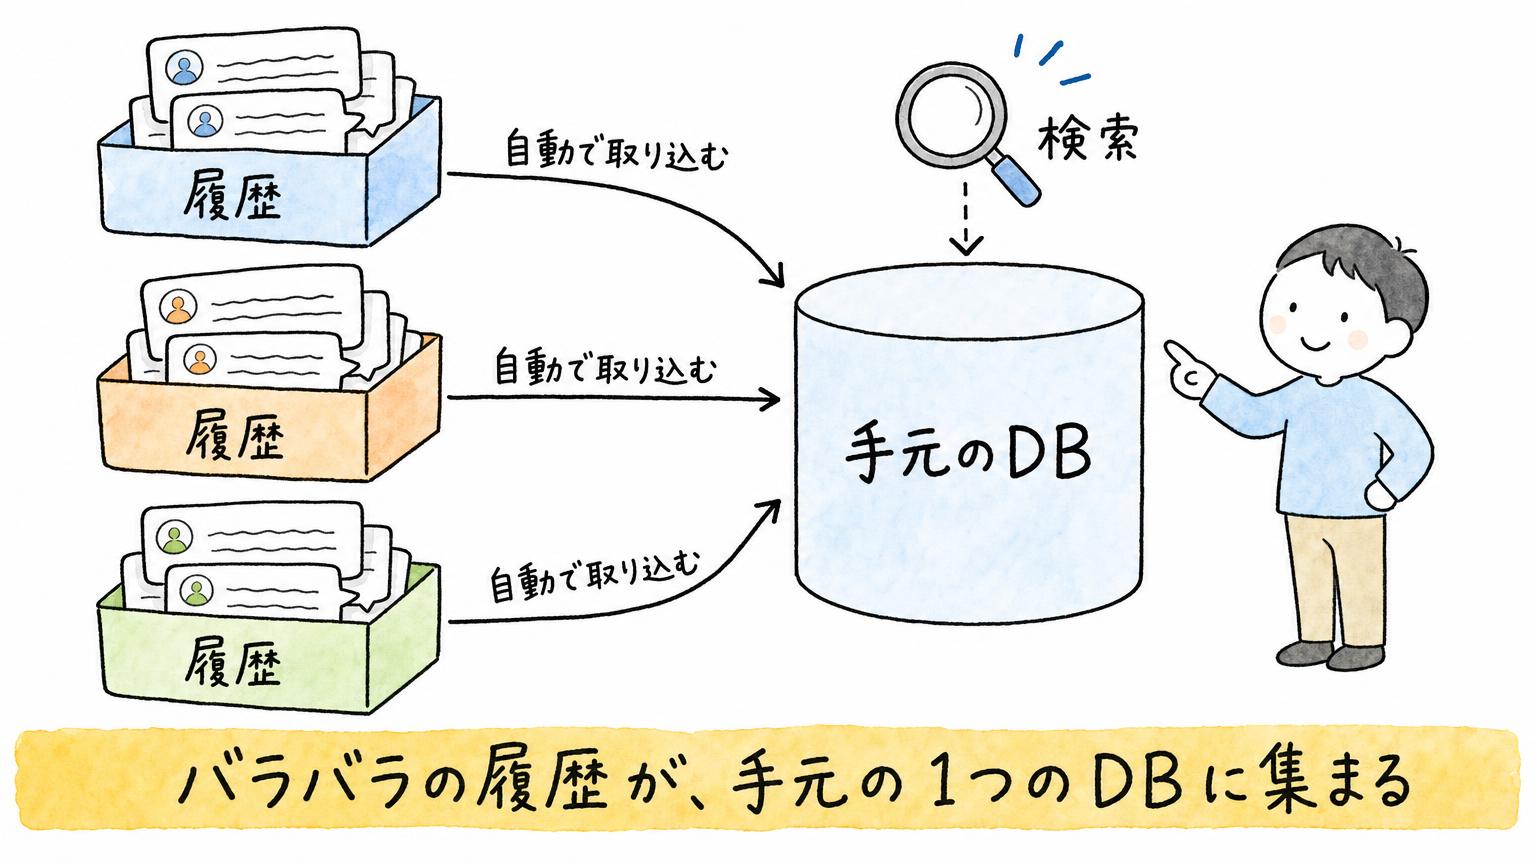
AgentsViewは、エージェントがもともと保存している履歴を自動で見つけ、手元のデータベースに取り込みます。公式は、60種類を超える形式に対応しているとしています。
僕の環境の画面が、こちらです。取り込まれたのは約1.4万件で、中身は次の12種類です。
- Claude Code:約9,000件(全体の3分の2ほど)
- Cursor:約2,200件(保存の形式が2つあり、2種類に数えています)
- Kiro:約900件
- Codex:約800件
- Cowork:約760件
- Antigravity:約30件
- Copilot:約25件(こちらも2形式)
- Gemini、goose、opencode:それぞれ数件
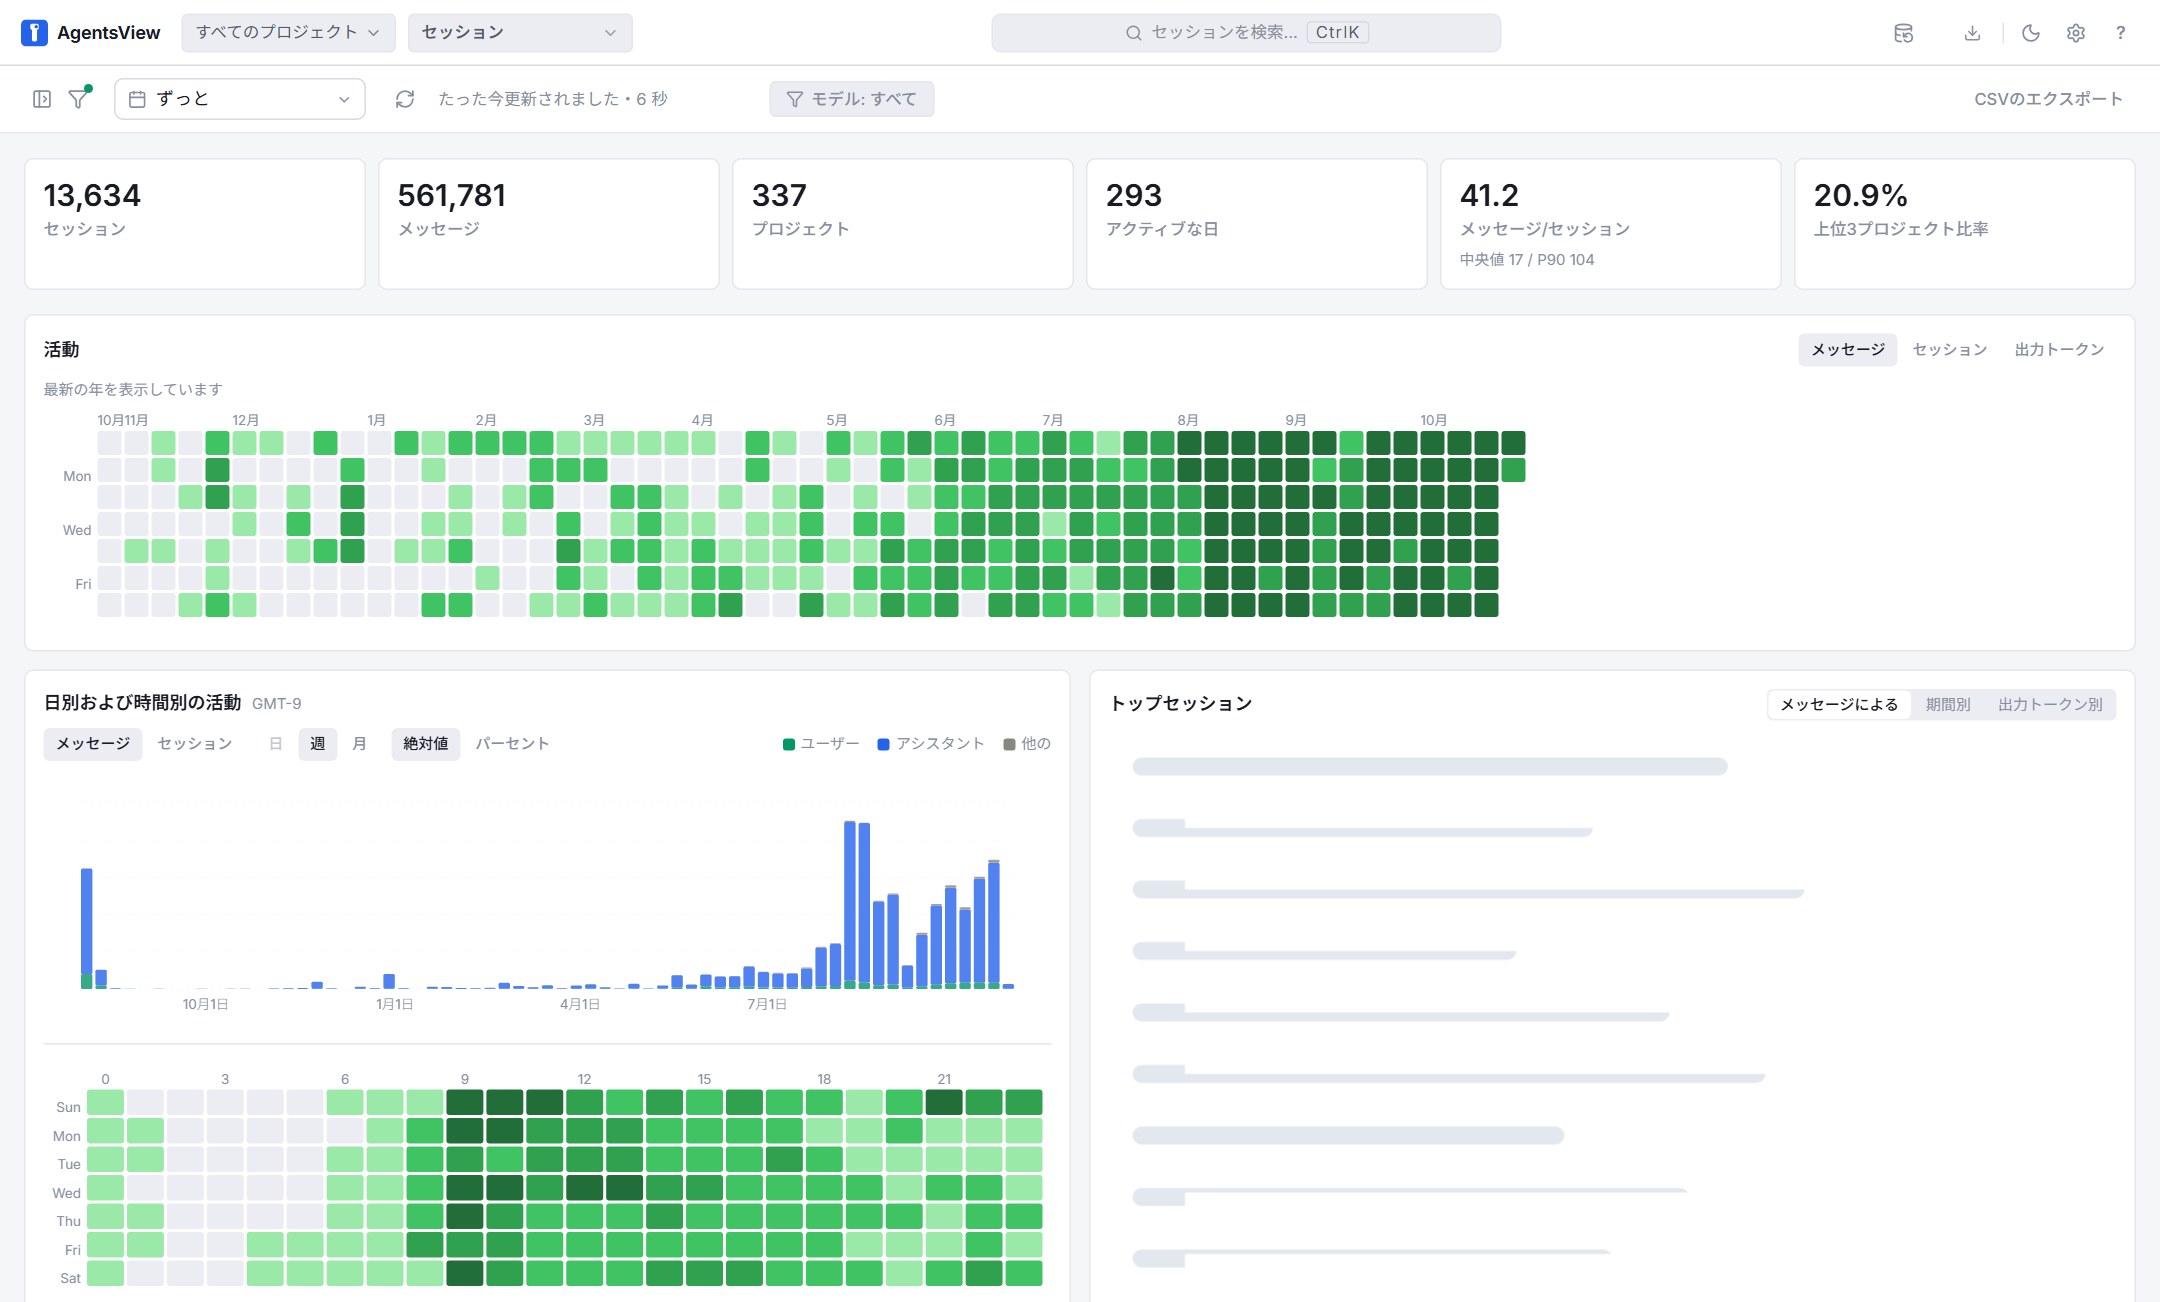
件数は、この夏から急に増えました。いまは月に1,000〜3,000件のペースです。半分強は、親のエージェントが呼び出したサブエージェントの作業です。
検索欄に言葉を入れると、元の会話とツールの実行まで、一気にさかのぼれます。日本語も、そのまま全文検索できます。試しに「承認」と入れると、数百件の発言が見つかりました。
費用と作業の質を見る入口
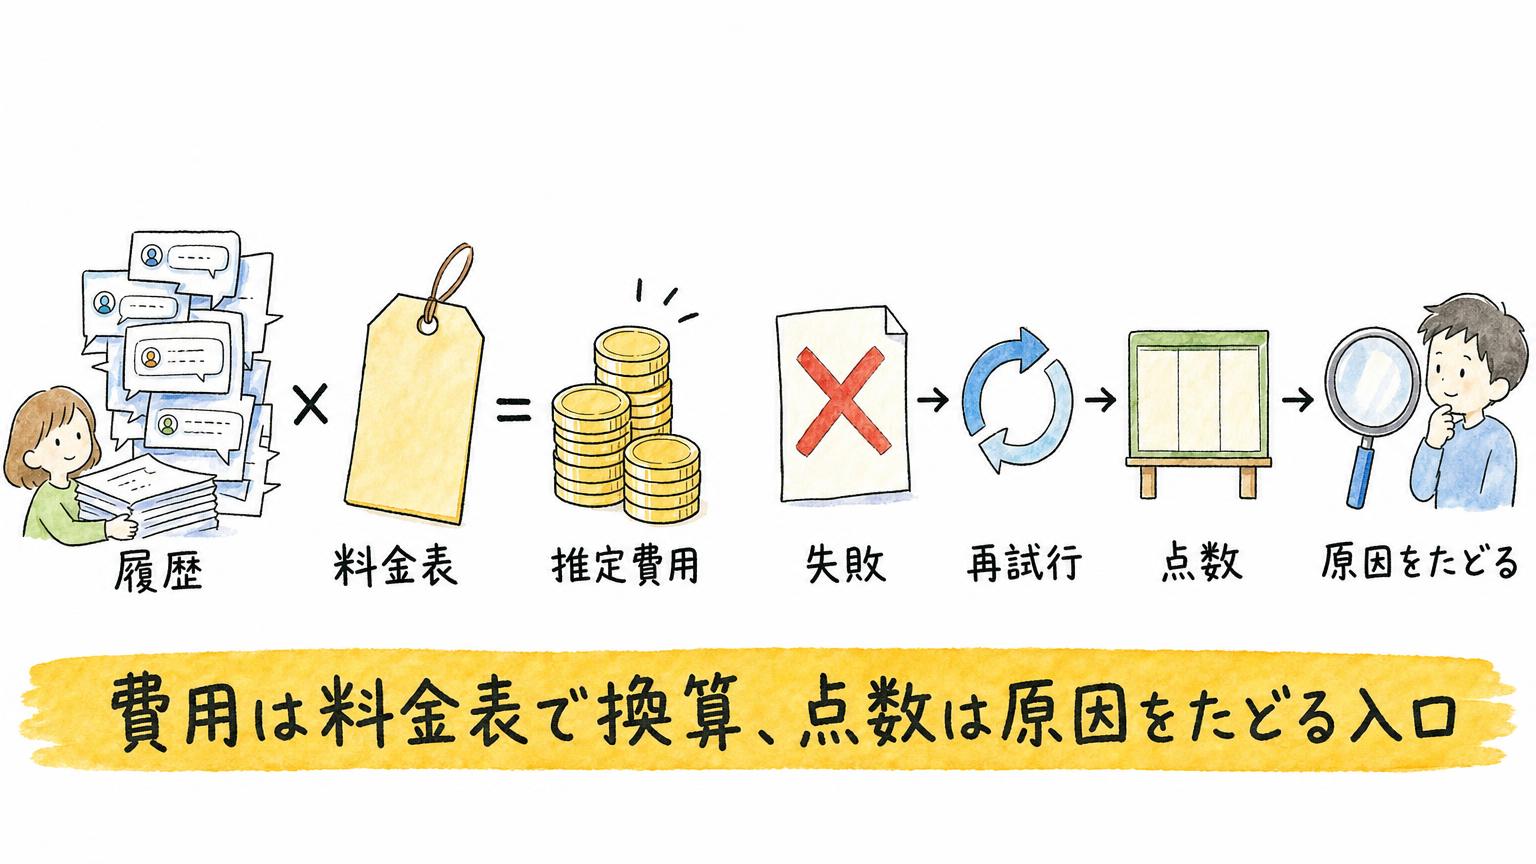
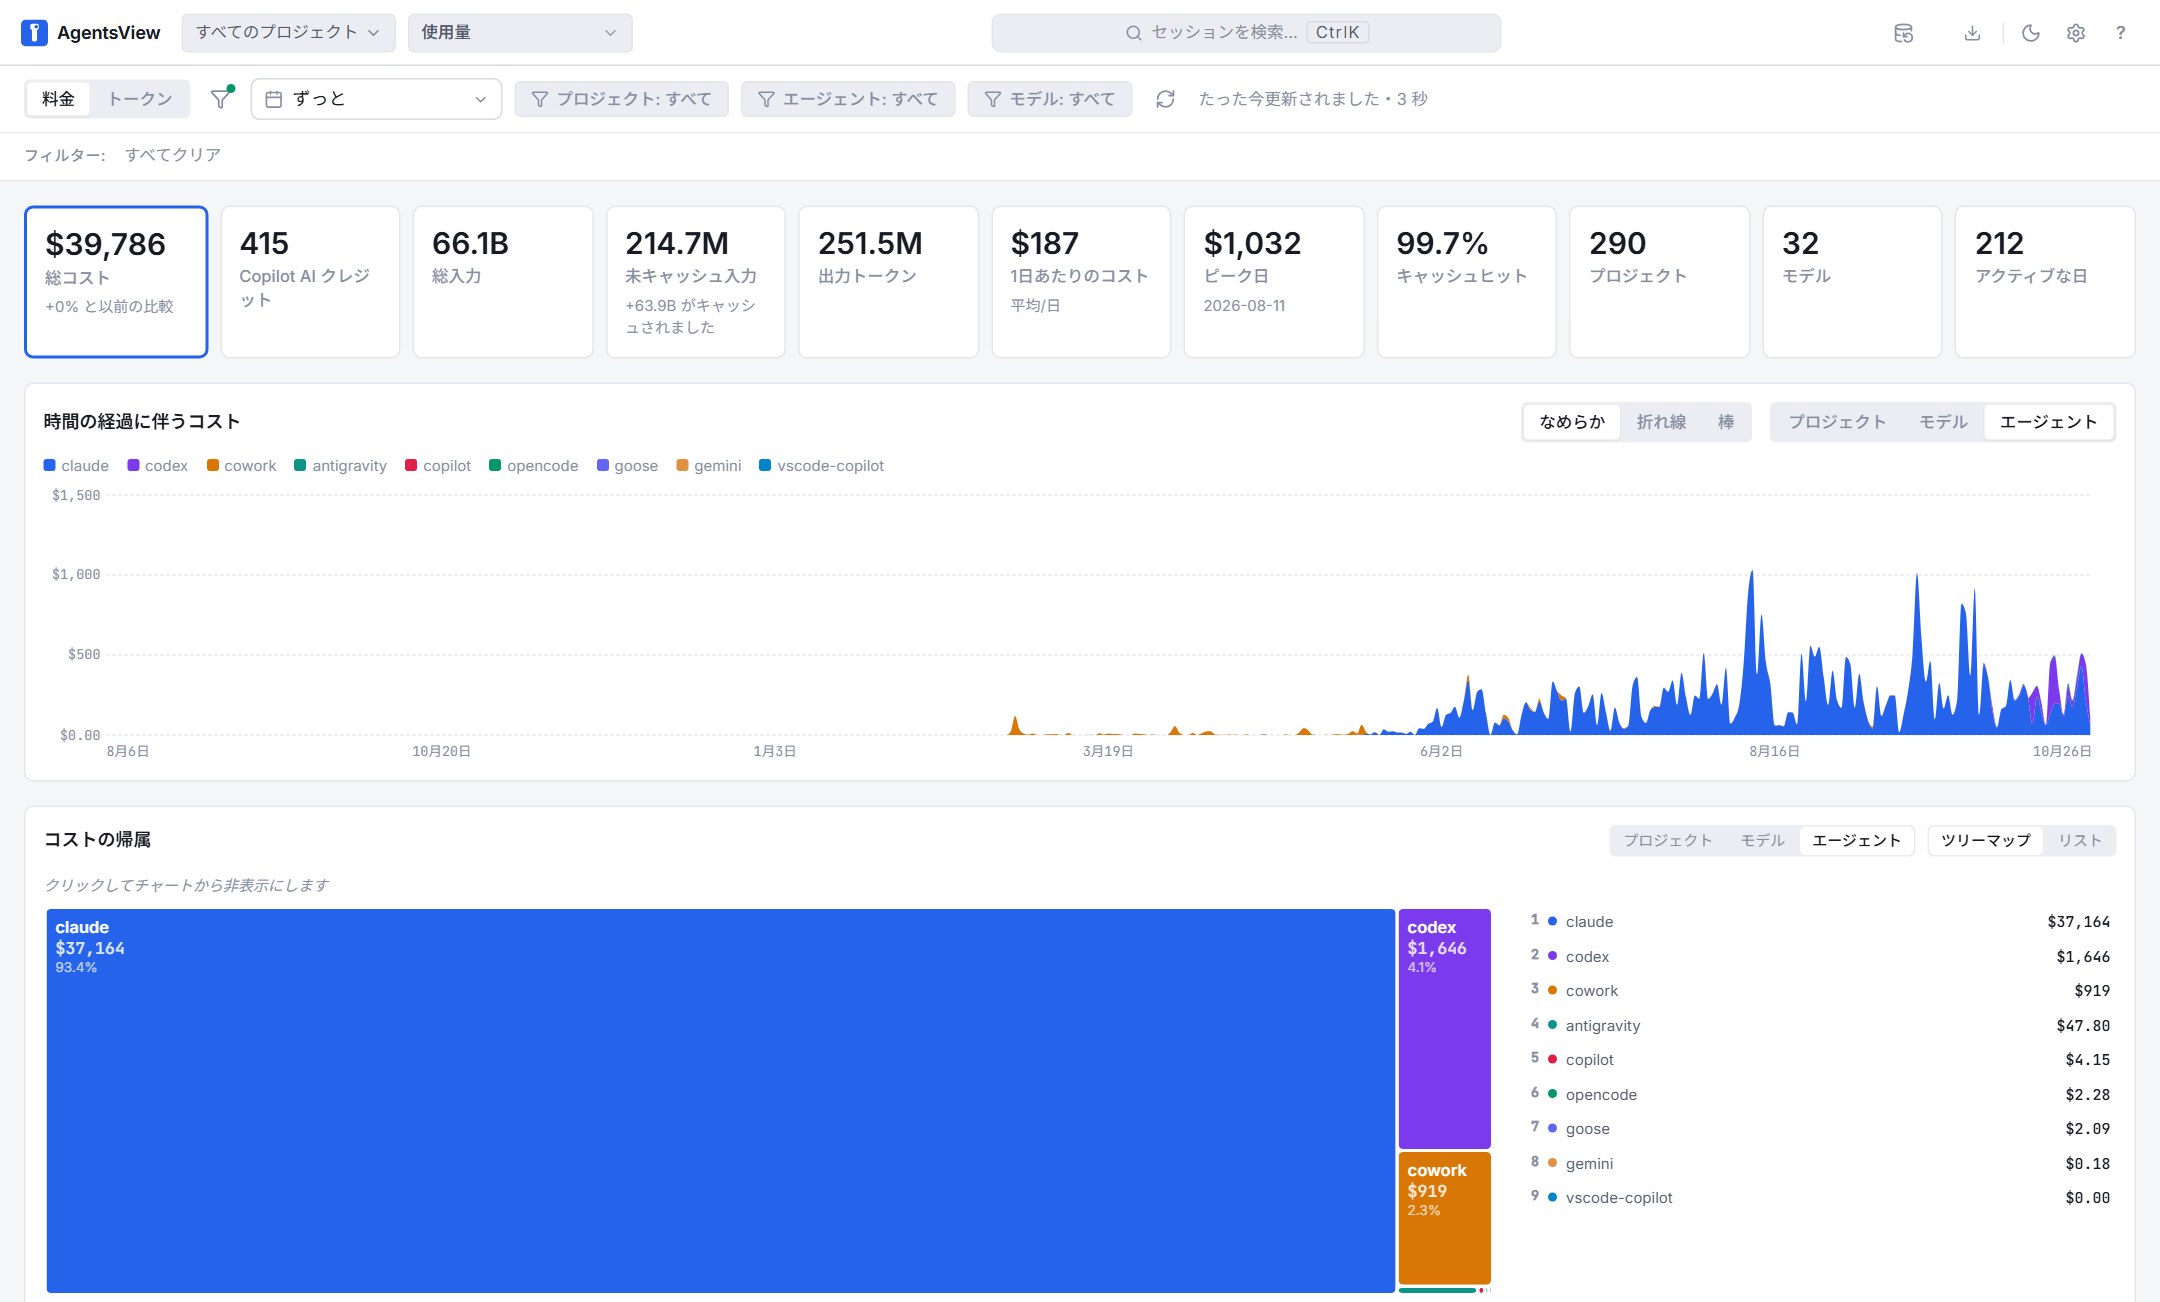
使用量の画面では、モデル別・日別・エージェント別に、推定の費用が見えます。出し方は、ログに金額が記録されていればそれを使い、なければトークン数と公開の料金表から推定する、というものです。
僕の履歴では、API料金に換算した推定が、全期間で約4万ドルでした。直近の30日だけで約1万ドルで、全期間では9割以上をClaude Codeが占めます。契約によって実際の支払いはこの額にならないので、「API料金で払えばこの規模」という物差しとして見ます。
作業の質は、失敗や再試行の信号から点数が付きます。僕の履歴では、評価の付いた約5,500件のうち、最高ランクが約3分の2、上位2つのランクを合わせると約9割でした。
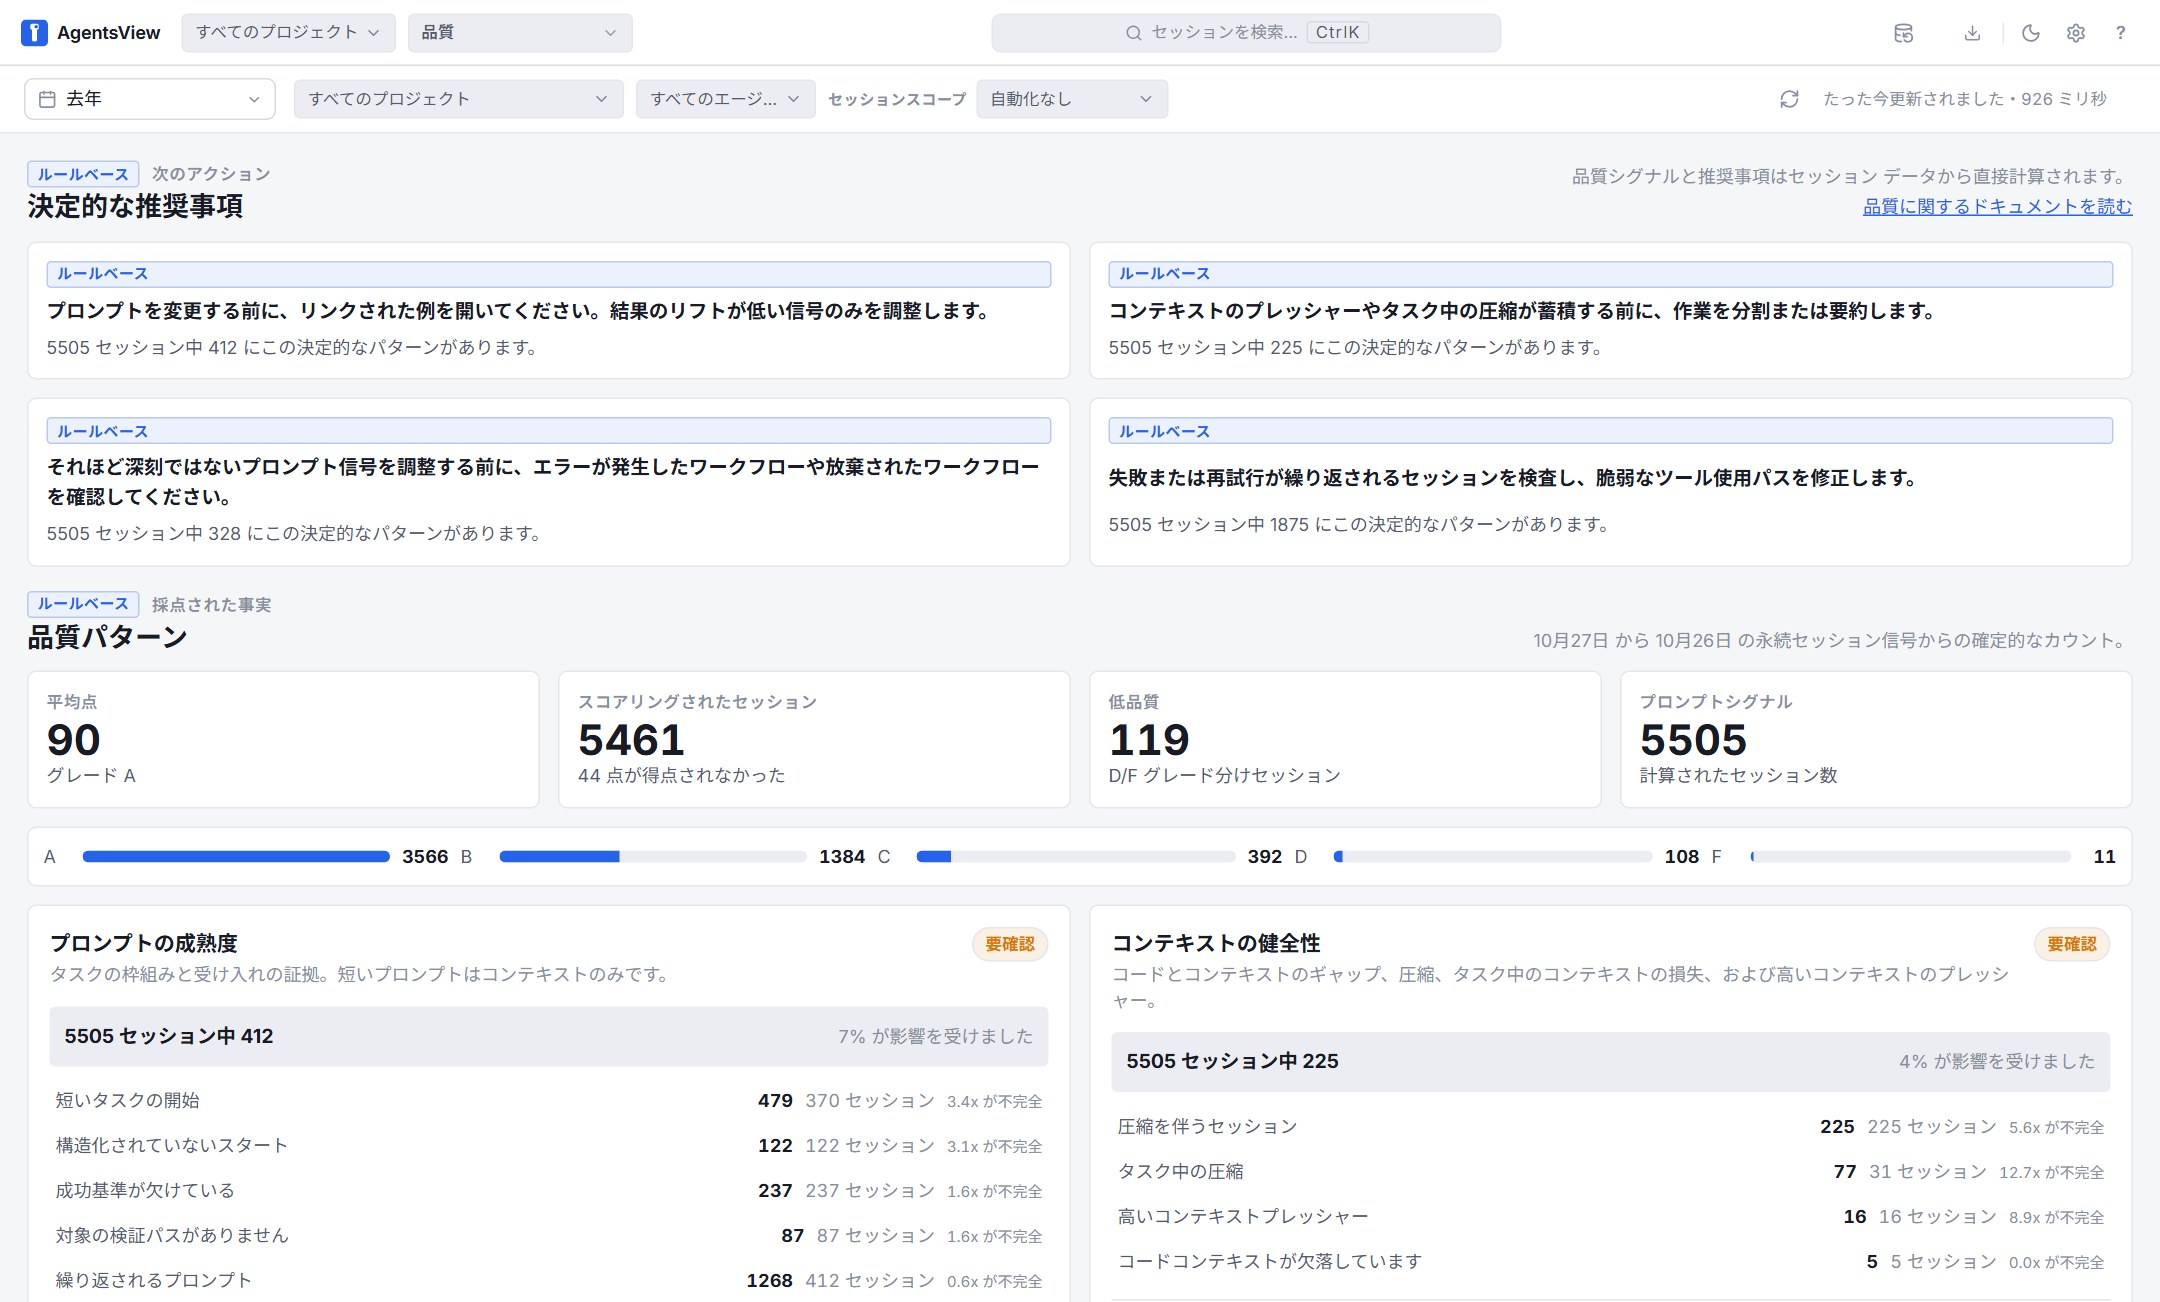
ただし、一度失敗しても後の呼び出しで回復した場合に、仕事全体の成功は証明されないと公式は注意しています。点数は順位づけではなく、原因をたどる入口です。
会話の検索と、知識の抽出の違い
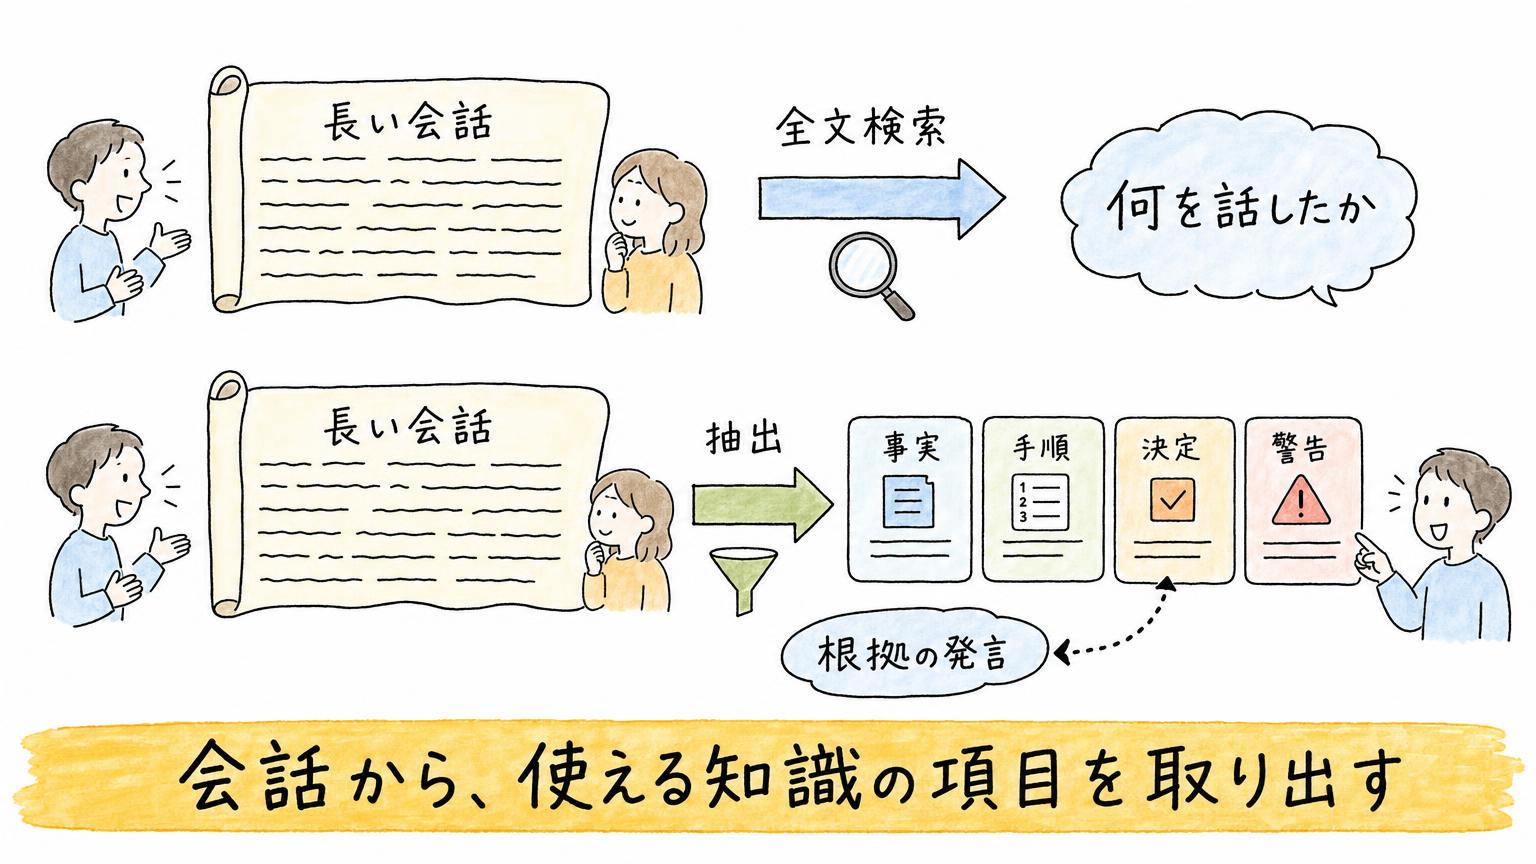
全文検索は、「あのとき何を話したか」に戻る道です。Recallは、事実・手順・決定・警告・好みといった項目に整理して、各項目から根拠の発言へ戻れる形で保存します。
例えば、デプロイが失敗した長いやり取りから、「先に設定を確認する」という手順の候補を取り出す使い方が考えられます。モデルを学習し直すのではなく、次の仕事に渡す情報を整理する仕組みです。
自動の抽出は、自分で有効にしない限り動きません。公式も、実験的な機能と位置づけています。
使ったのは、手元のMac miniで動くローカルのAI「Qwen3.6」です。外部のサービスを使わないので、抽出に料金はかかりません。
画面の「抽出状況」には、約660件の履歴から約5.9万件を取り出した、と出ています。内訳は事実と手順がほぼ半々で、残りの約1.2万件は、これから処理します。
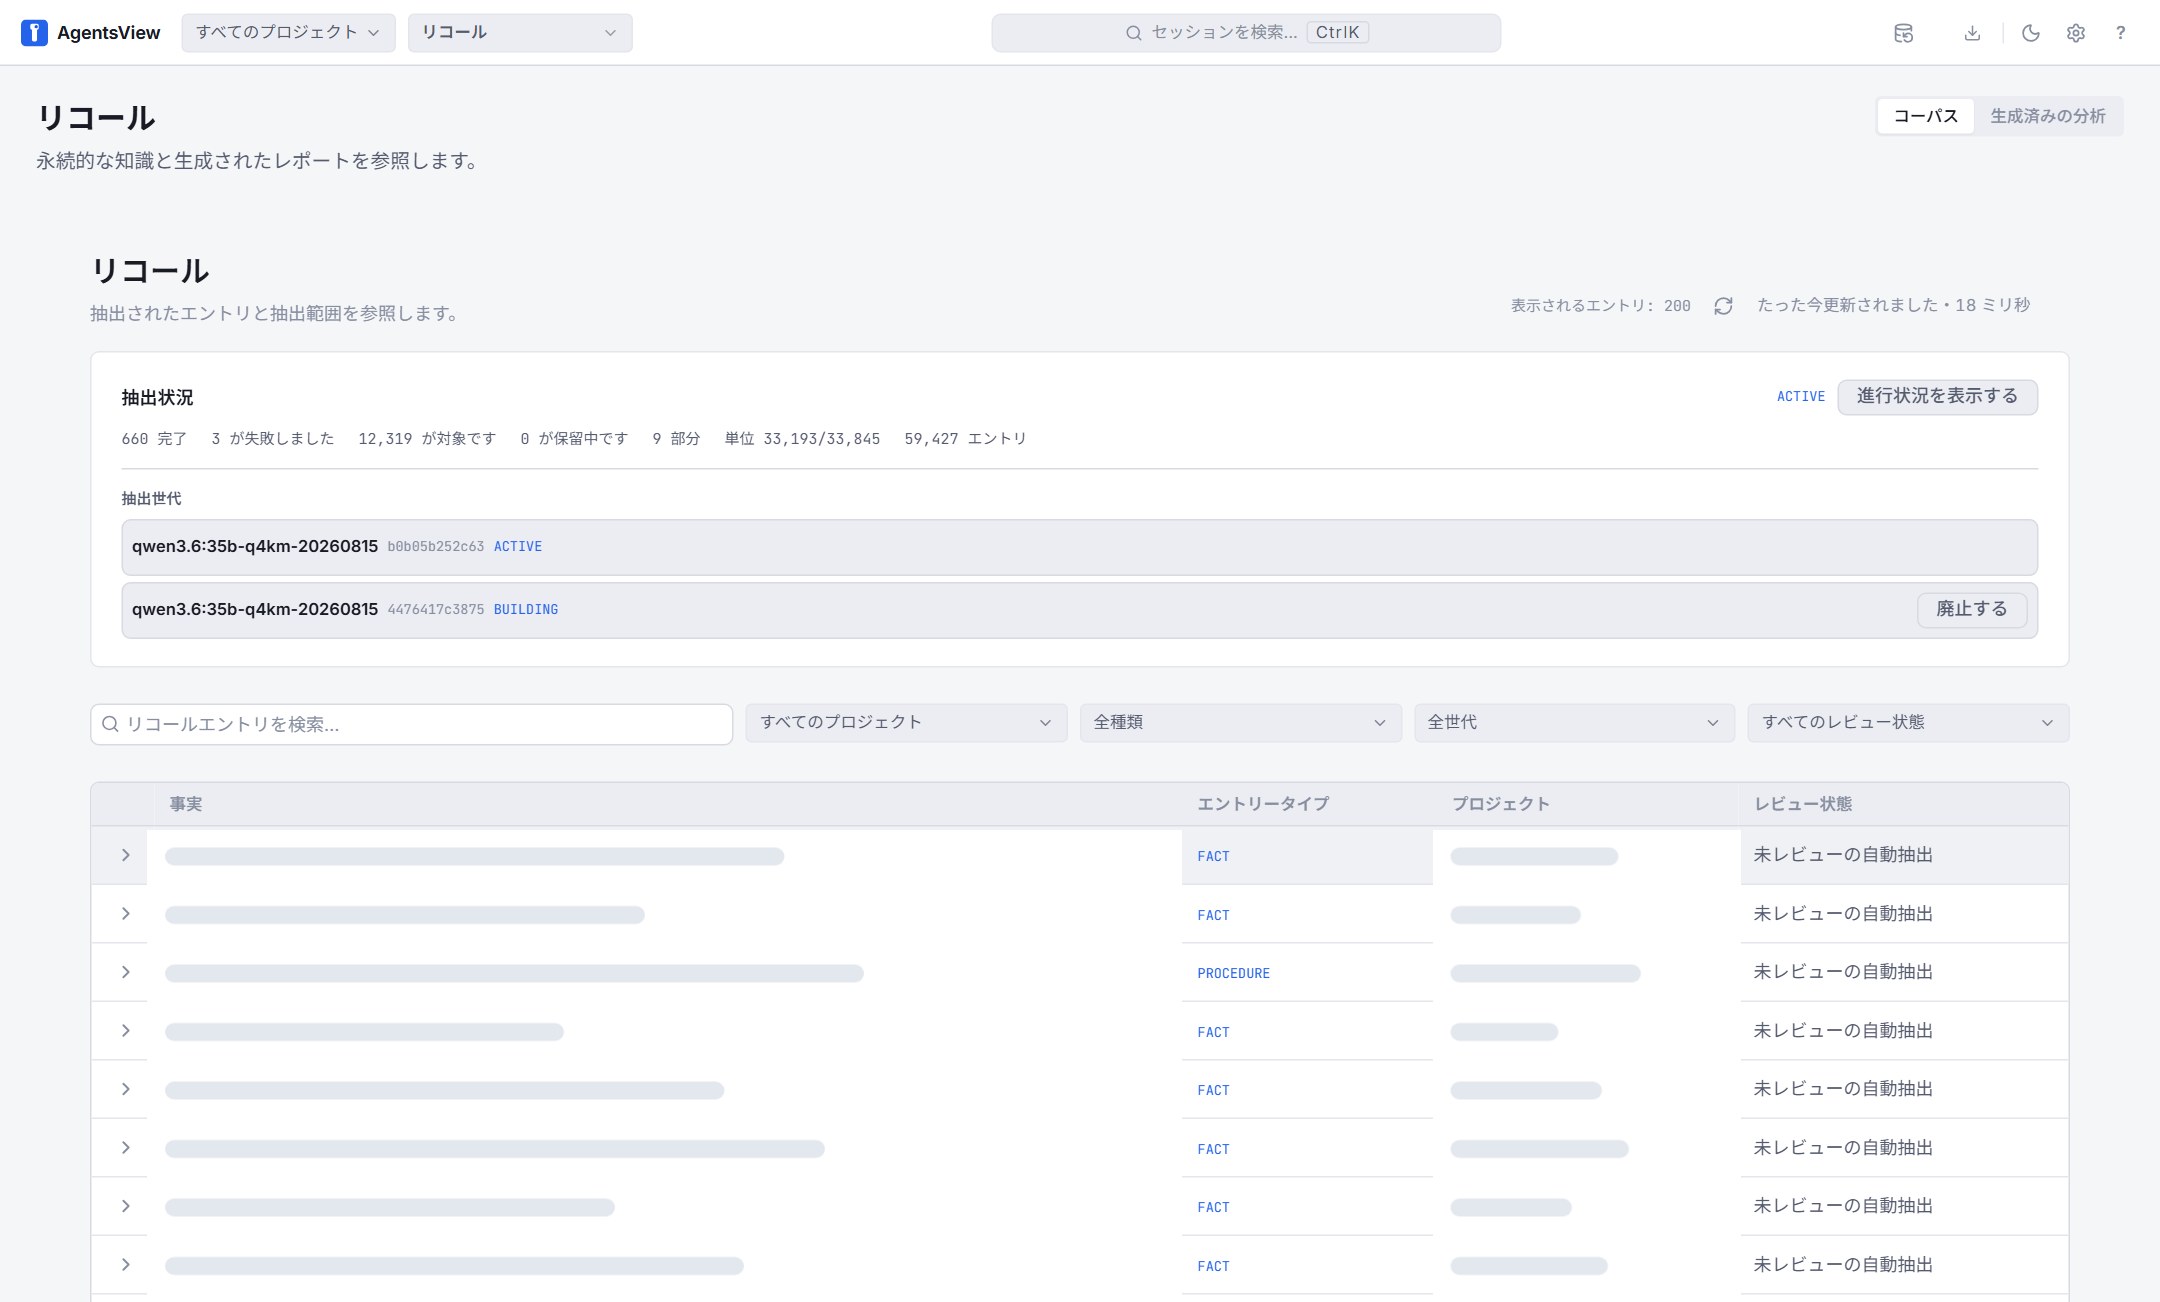
自動で取り出した項目は、未点検の状態で保存されます。次の仕事で信頼して読み出せるのは、人が承認し、転用でき、根拠も有効な項目だけです。
根拠は、元の発言の位置や内容に結び付いていて、元の履歴が消えたり変わったりすると失効します。ただし、根拠が合っていても、手順がいまの環境で通じる保証にはなりません。
承認のときは、提案の段階だったのか、実際に採用された判断なのか、どの環境の話なのかまで、人が見る必要があります。機械の抽出は一瞬で終わり、判断は人に残ります。
次のエージェントに戻す道と、送信先の管理
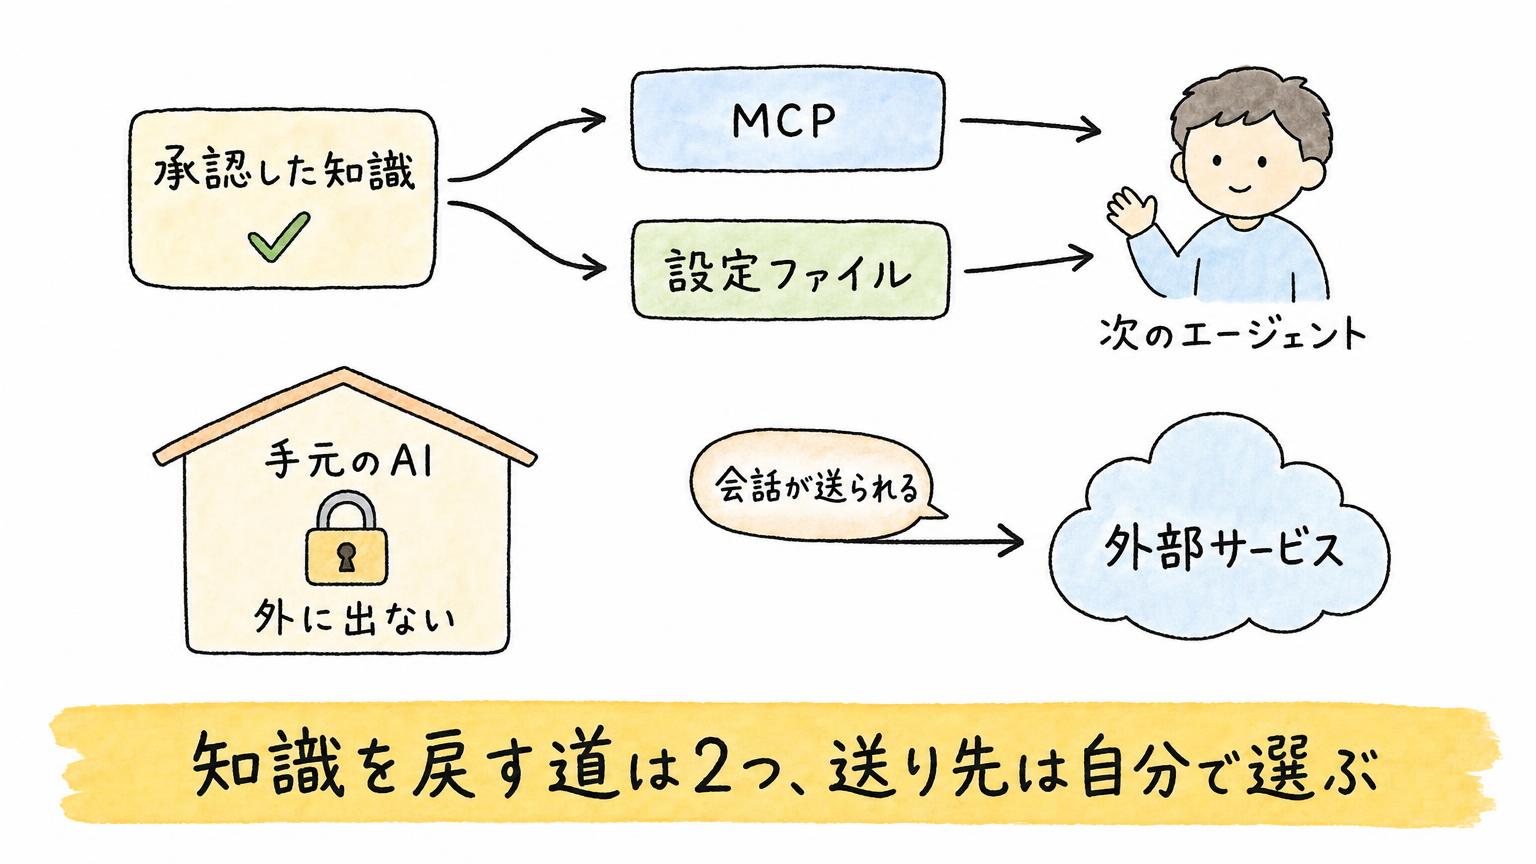
履歴を次の仕事に戻す道の1つが、MCPです。読み取り専用で、検索、セッションの概要、本文の取得、使用量などが使えます。
断片だけで結論を出さず、検索で絞って、概要を見て、本文を読む順に進めるのが基本です。検索は、初期設定で直近10分に動いたセッションを除くので、空振りでも「存在しない」と決めつけないことです。
戻す道は、MCPだけではありません。僕は、集計して人が選び、設定ファイルに入れる形で戻しました。
直近10日・約320件の履歴から取り出した約1.9万件を集計し、繰り返されている失敗を探しました。約1,600種類の警告と判断はサブエージェントに束ねさせ、代表例は自分で元の発言と照合しました。
多かったのは、証明書エラー、シェルの文字化け、同期フォルダ上のファイルの競合、ローカルビルドの失敗です。意外だったのは、この対処が1つのツールの設定にしか書かれていなかったことでした。いちばん踏んでいたのは、別の2つのツールです。
そこで、共通のメモを1枚作りました。Claude Code、Codex、Antigravityの設定ファイルから、「この場面では先に読む」と参照させています。
3つに書き写さず、1枚にしたのは、直す場所を1か所にするためです。
効いたかどうかは、Codexに「コミット前の準備」を頼んで確かめました。共通メモの名前は伝えていないのに、2手目で共通メモを読み、そのあとに変更の確認へ進みました。
ここでも、人の目は欠かせませんでした。抽出された「好み・ルール」には、撤回済みのものが混ざっていたからです。誰がいつ言ったかを確かめてから、設定に入れます。
もう1つ、送信先の管理があります。保存先がローカルでも、知識の抽出に使うモデルの置き場所は別です。公式は、抽出先に会話由来の内容が送られると説明していて、ローカルのモデルも使えます。僕はローカルなので、外には出ていません。
履歴には、鍵も混ざります。AgentsViewの検出では、半数を超えるセッションに鍵らしき文字列が見つかり、確度が高いものも約500件ありました。共有や外部モデルでの抽出に渡す前に、この検出を確かめる必要があります。
「溜める」から「承認して戻す」へ
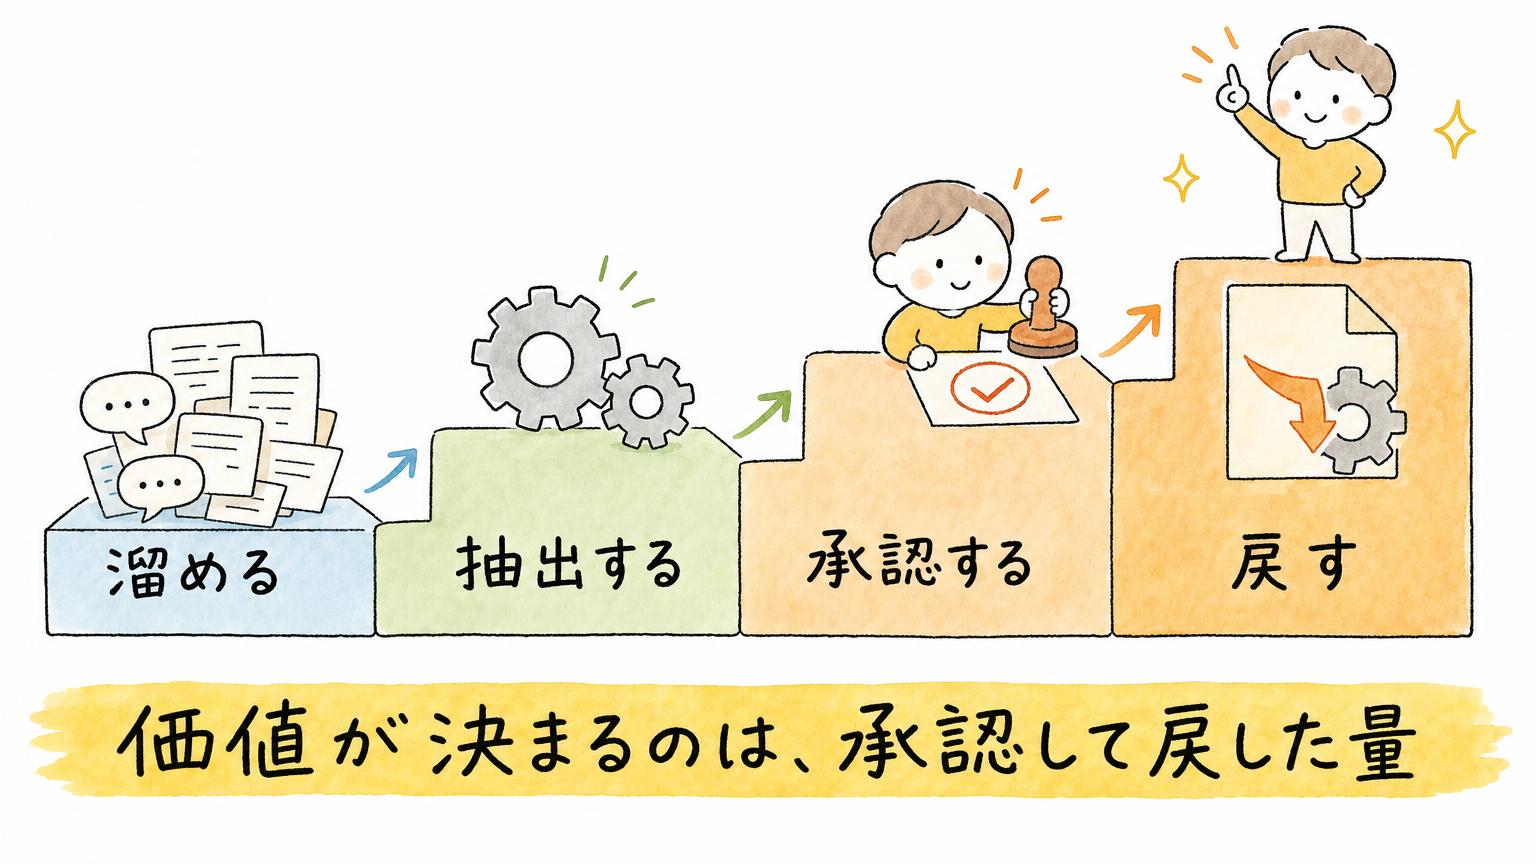
履歴を溜める段階は、もう難しくありません。AgentsViewは、取り込むだけで動きました。重心は、承認して戻す段階に移るでしょう。
抽出が速く安くなるほど、足りなくなるのは人の判断の時間です。次に競われるのは、承認の負担をどれだけ下げられるか。対象のプロジェクトを絞る、よく使う手順から優先する、といった工夫が分かれ目になると読めます。
約5.9万件を、全部承認する必要はありません。僕が設定に戻したのは、5つの項目だけでした。使い始めた人から、自分の仕事のやり方が資産として積み上がります。
個人でもチームでも、承認の習慣を先に持った側が、同じ調査を何度もやり直さずに済みます。履歴の価値は、溜めた量ではなく、承認して戻した量で決まります。
よくある質問(FAQ)
Q1. AgentsViewは無料で使えますか?
無料のオープンソースで、保存先は手元が基本です。取り込んだ履歴は手元のデータベースに入るため、集めて検索するだけなら外部に送る必要はありません。
Q2. 推定の費用は実際の支払額と同じですか?
同じではありません。ログに金額があればそれを使い、なければトークン数と公開の料金表から推定します。契約によって実際の支払いは変わるので、API料金で払えばこの規模、という物差しとして見るのが安全です。
Q3. Recallで抽出した知識は、そのまま使ってよいですか?
そのままは使えません。自動で取り出した項目は未点検の状態で保存され、人が承認し、転用でき、根拠も有効な項目だけが信頼して読み出せます。撤回済みのルールが混ざることもあるため、誰がいつ言ったかを確かめてから設定に入れます。
AIエージェントを使い倒して、自分の仕事のやり方を資産にするところまで。AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」で、実務を持ち寄りながら探っています:https://frontier-leaders.vercel.app/
エージェントとデータベースをつないで、自分の道具を作る回もあります。2時間で、AI活用術を実践のハンズオンで学べます(過去回のアーカイブ):https://handson.workstyle-evolution.co.jp/
AIニュースの解説は、YouTube『いけともch』でも続けています:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事
人気記事RANKING
-

PHP重大脆弱性2件の更新対応と、裏側でAIが担った役割:個人と企業が整えるべき備え
-

【初心者向け】Stable Diffusionをローカルで使う方法完全ガイド|テキストから画像生成を自分のパソコンで始める手順
-

Rakuten AIを実際に使ってみた感想:商品検索の速度と連携機能を徹底レビュー
-

KindleのAI質問機能「Ask This Book」が米国で開始!ネタバレなしで本の内容を質問できる革新的機能の詳細と日本展開への期待
-

Copilot Studio VS Code拡張機能で業務効率化を実現!開発者向けライブコーディング環境の導入と活用法
カテゴリー
- 主要AIサービス (114)
- 画像生成AI (86)
- 動画生成AI (114)
- 音楽・音声生成AI (28)
- AI開発・効率化ツール (153)
- AIのビジネス活用 (197)
- 教育×AI (19)
- AIの知識&トレンド (222)
- いけともサブチャンネル (420)
- AIエージェント時代の働き方 (1)
タグ
Agent V3
AI字幕
AI字幕ツール
Alibaba
Amazon Seller Assistant
Amazon Seller Central
AP2
ATOS
ByteDance
CAG
Cognition AI
Comscore
cotomi Act
DAW
DevOps
Gemini Advanced
GUGA
HeyGen
HunyuanImage
HunyuanImage-2.1
IndexTTS2
JR東日本
NEC
OpenAI Platform
Oracle
Perplexity Search API
Qwen3-Next
Replit
SeeDream
SongBloom
Stargateプロジェクト
Suno Studio
Thinking Machines
インコンテキストラーニング
カスハラ
コネクタ
ステム分離
ソフトバンクグループ
データセンター
パナソニックコネクト
事故対応
動画解析AI
暗黙知
決定論性
鉄道運行管理
公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ