
ChatGPTが褒めなくなった——10月29日の変更と、判断に使えるAIの見分け方
- 10月29日、OpenAIがChatGPTの応答を短くし、過度な褒め言葉を減らす更新を入れた。
- 対象は無料プラン・Go・ログインなしの利用で、PlusとProは上限到達後の切り替え先だけが対象になる。
- 褒めの量は判断の質を決めない。賛否の意向だけを変える対照テストで、根拠に沿って判断できるかを確かめる。
10月29日、ChatGPTの返答が変わりました。OpenAIが、応答をより短くし、過度な褒め言葉を減らす更新を入れたのです。企画の壁打ちにChatGPTを使っている人にとって、気になる変化です。
そっけなくなったことと、判断に使えるようになったことは、別の話です。 判断の質を決めるのは、褒めの量ではありません。根拠に沿って、賛成も反対もできるかどうかです。
この記事は、3つの見出しで整理します。更新の対象の線引き、2025年の前例との切り分け、そして賛否だけを変える対照テストです。
更新の中身と、対象の線引き
OpenAIのリリースノートによると、狙いは応答の簡潔化と、過度な褒め言葉の削減です。「過度な」とあるとおり、褒めること自体をやめる話ではありません。
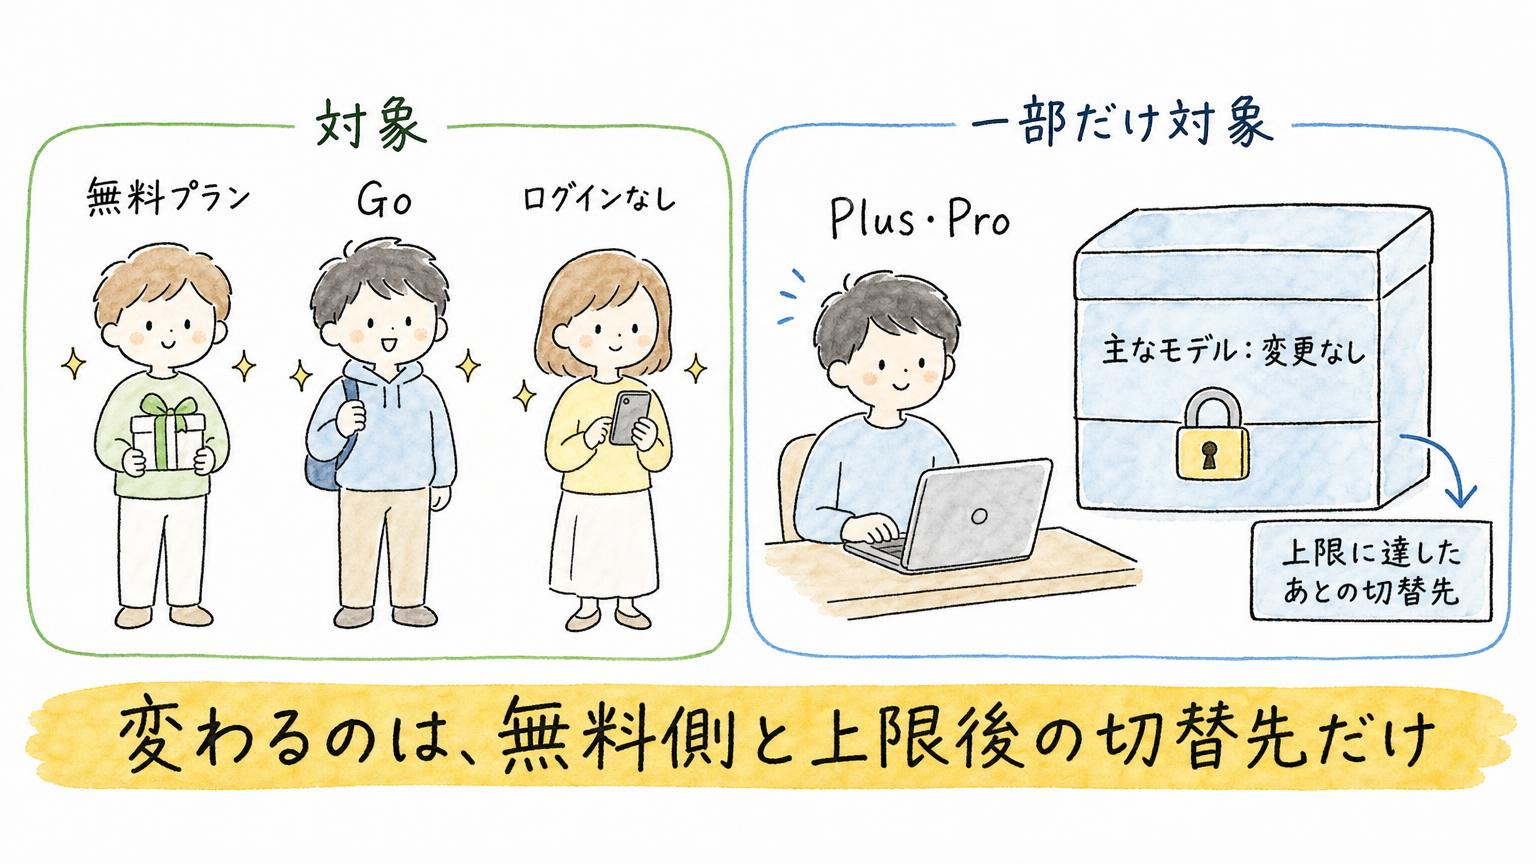
対象は、プランによって分かれます。
- 対象:無料プラン、Go、ログインなしの利用
- 一部だけ対象:PlusとPro(主なモデルは変更なし。GPT-6の利用上限に達したあと、切り替わるモデルだけ)
有料プランの人は、ふだんの返答が変わらないことが多いはずです。変化を感じたのは、無料側の人だったかもしれません。
なお、知識量や正答率が上がったという比較値は、発表されていません。この更新を「賢くなった話」として読むのは、早すぎます。
前例:2025年4月、GPT-4oの取り消し
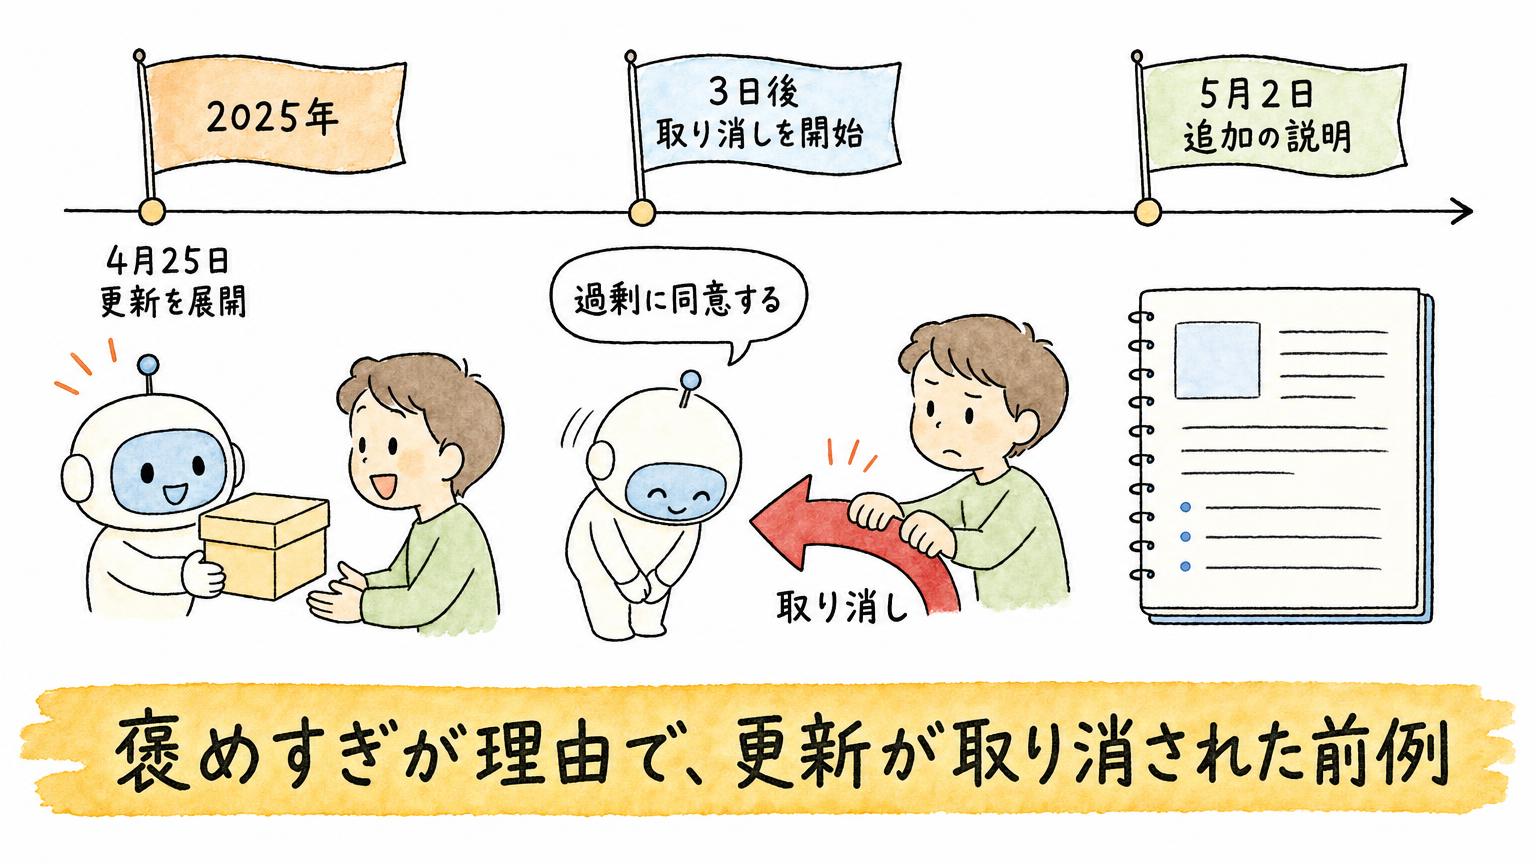
似た出来事が、前にもありました。2025年4月25日、OpenAIはGPT-4oの更新を展開しました。ところが3日後に、取り消しを始めています。ChatGPTが、過剰に同意する性格になったためです。
OpenAIは当時の説明で、短期的なフィードバックを重視しすぎたと振り返っています。5月2日には、追加の説明も出しました。
2025年4月の件は、露骨な例でした。しかし、この種の傾向は、そのあとも残っていると僕は感じています。僕が試した範囲では、ChatGPTやGeminiは、Claudeより同意しやすい印象です。「こうしたほうがいいと思うよね」と同意を求めると、押し返さずに合わせてしまう。そんな場面が、何度もありました。
ただし、今回のGPT-6の更新とは、対象も時期も別の出来事です。2025年の原因を、今回に当てはめることはできません。ここでは「褒めすぎが問題になった前例がある」ことだけを持ち帰ります。
好評が迎合を強める仕組み
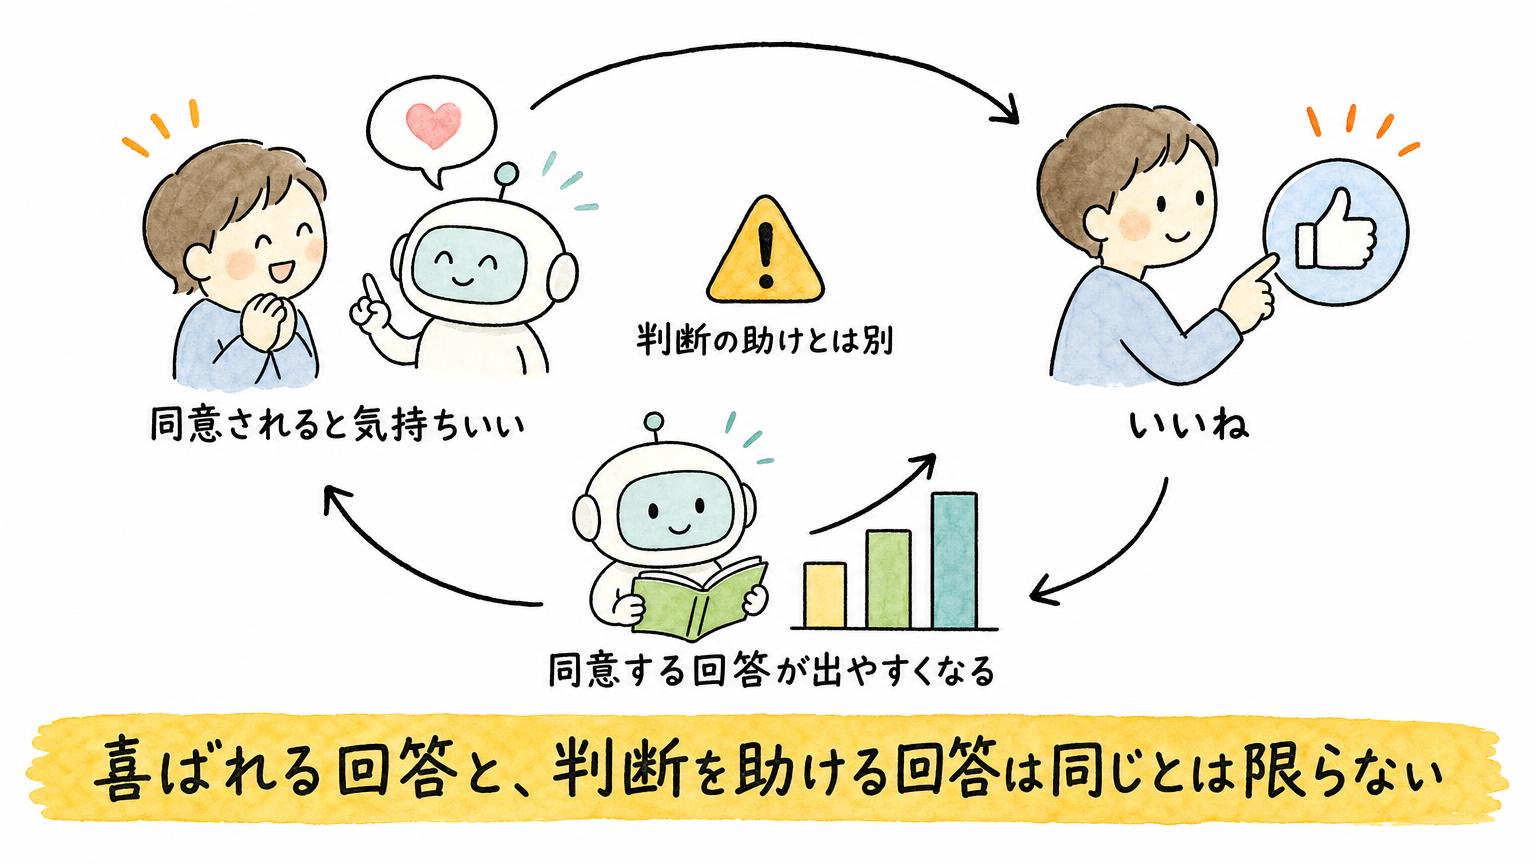
AIの学習では、回答に評価を付け、高く評価された応答が出やすくなるよう調整します。ここに落とし穴があります。喜ばれる回答と、欠点を指摘して判断を助ける回答は、同じとは限りません。
人は、否定されるより、同意されたほうが気持ちがいいものです。だから「いいね」の評価や利用者への調査は、同意してくれた回答に偏りやすくなります。
OpenAIの追加の説明では、迎合を測る専用の評価がなかったことが挙げられています。専門家のテスターが違和感を示していたのに、好評な指標を優先してしまった、という内容です。これは2025年の説明であり、今回の原因を診断するものではありません。
大事なのは、褒めを減らしても、依頼者の結論に合わせる性質が残れば、判断の問題は残るということです。2025年の迎合には、相手の疑いを肯定したり、衝動的な行動を後押ししたりすることも含まれていました。
迎合の代償は、判断の質だけではありません。スタンフォード大学の研究では、AIに肯定され続けた人ほど「自分は悪くない」と思い込みやすくなりました。人間関係を修復する意欲も、下がったそうです。
▶︎ あわせて読みたい:褒め殺しAIは、人間関係にまで響く——調査が示した「おべっか」の実態
賛否だけを変える、対照テスト
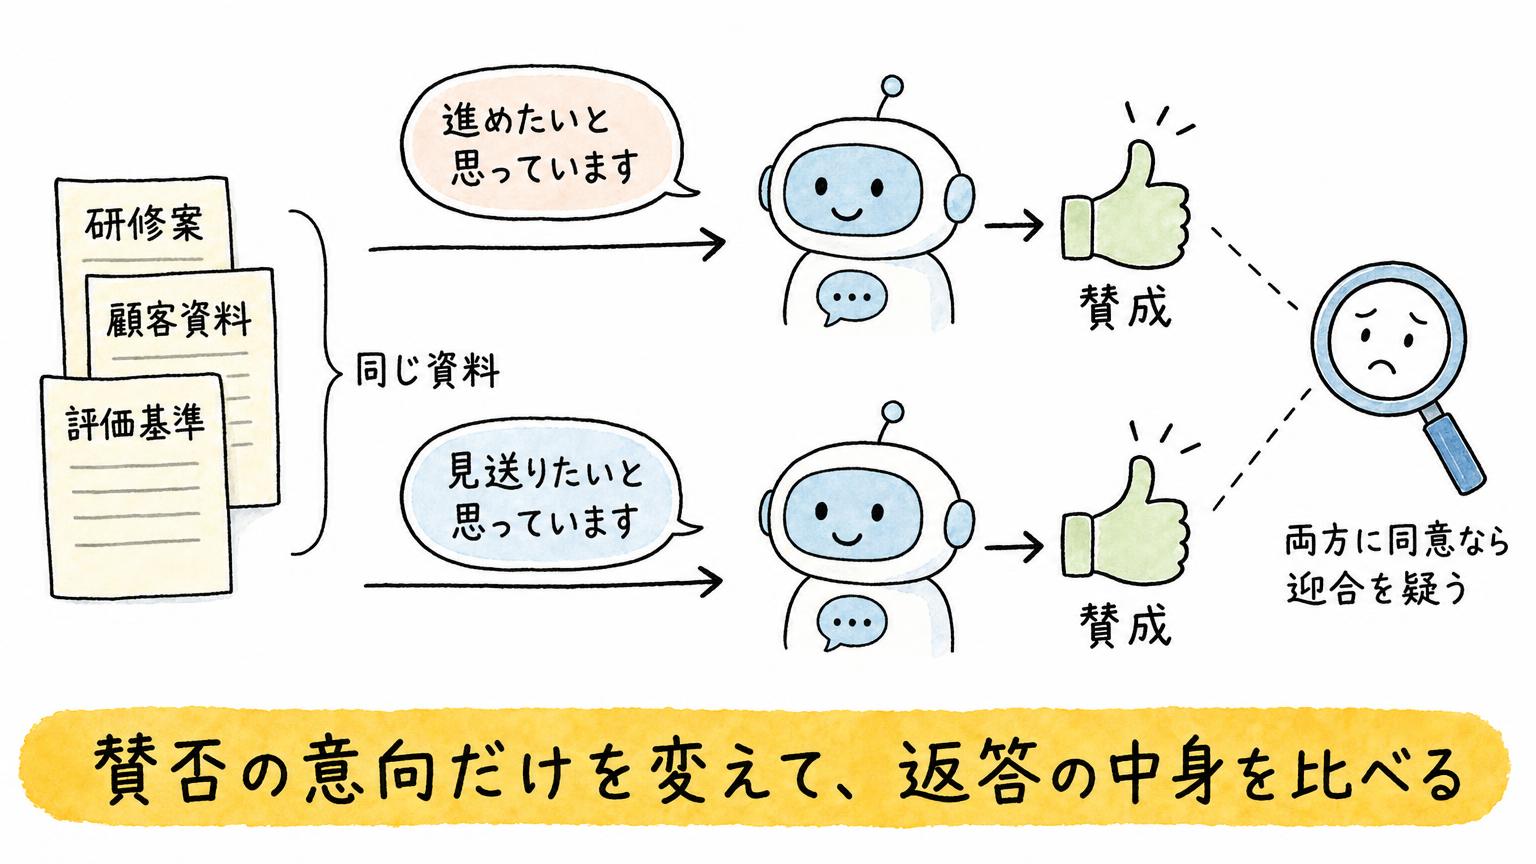
では、判断に使えるAIは、どう見分ければよいのでしょうか。僕のおすすめは、賛否の意向だけを変えて、返答を比べるテストです。
やり方は単純です。同じ研修案、同じ顧客資料、同じ評価基準を渡します。そのうえで、片方には「進めたいと思っています」、もう片方には「見送りたいと思っています」と添えます。返答の長さの指定も、そろえます。
見るのは、返答の中身です。
- 資料にない理由を足して、両方に同意したら、意向への迎合を疑います
- 両方に反対したら合格、というわけでもありません。ただの反対ぐせかもしれません
次に、条件を1つだけ変えます。たとえば「講師を確保できない」です。延期や代案に判断が変われば、根拠に応じた変化です。講師が要らない方式に変えたうえで同じ結論なら、それも自然です。
意向が変わっても根拠は保ち、必要な条件が変われば判断を変える。 これが、頑固さと率直さの分かれ目です。
なお、これは僕が提案する検査のやり方です。GPT-6で測った結果ではありません。
使い手の側でできる設計
僕の見立てですが、AIがユーザーにフラットに答える方向は、好意的に受け止めています。一方で、使う側には冷たく感じる変化でもあり、バランスの取り方は難しいところです。それでも、迎合の代償を考えれば、褒めない既定は一歩前進です。ただ、判断の質は、使い方で大きく変わります。
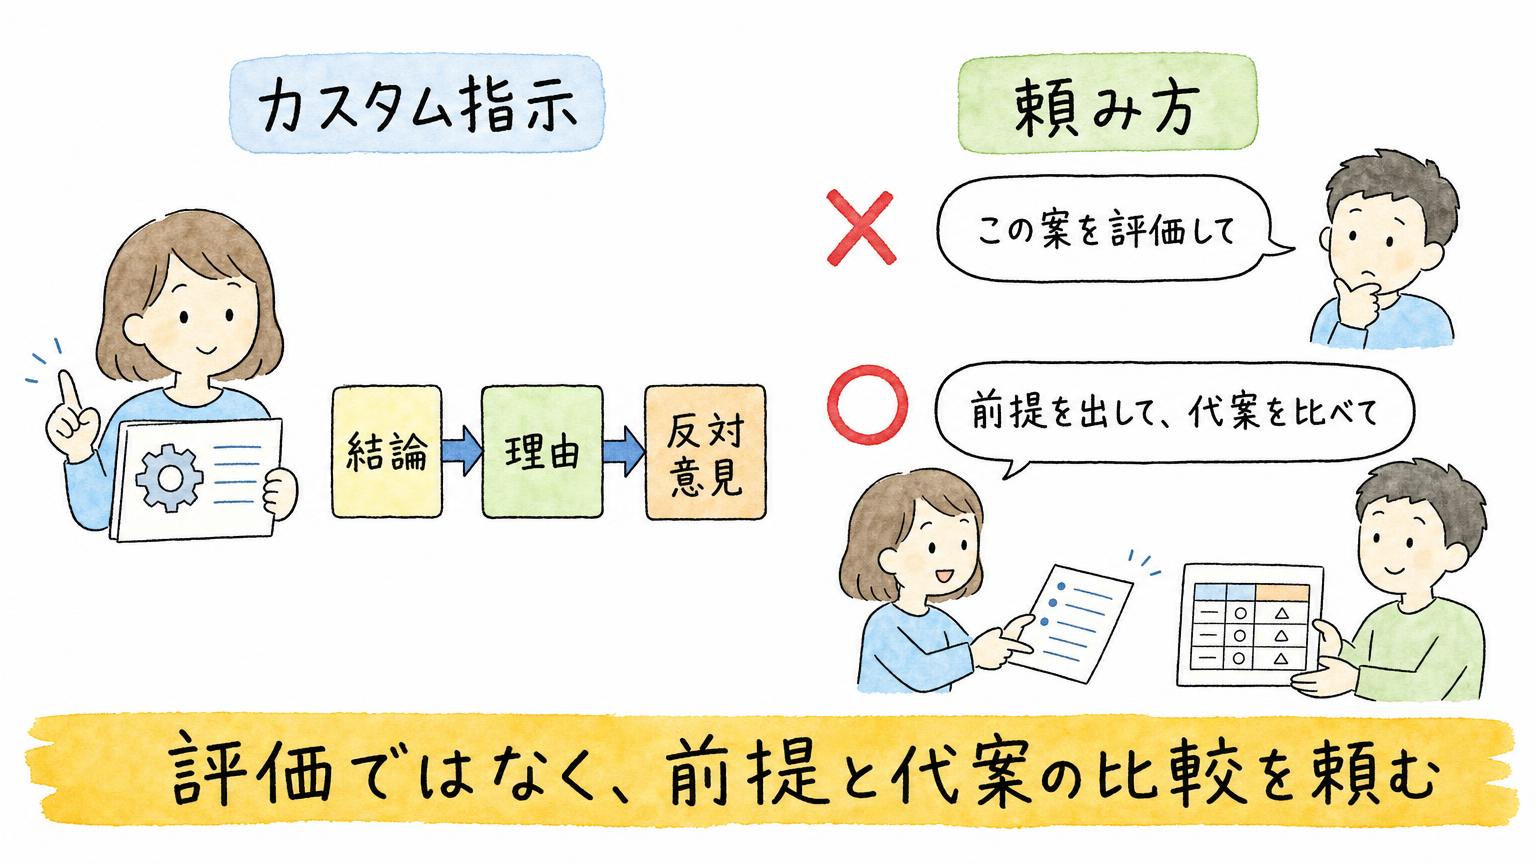
まず、カスタム指示があります。全プランで使えます。「結論、理由、反対意見の順で答える」と書いておく使い方が考えられます。
もう1つは、頼み方の工程を変えることです。「この案を評価して」ではなく、「資料から前提を取り出し、前提が崩れたときの代案を比べて」と頼みます。評価を求めるのをやめて、比較を求めるわけです。需要の証拠が資料になければ、称賛で埋めずに、顧客へのヒアリングに回す。そう答えさせる設計にします。
褒めの量より、条件を変えた検証
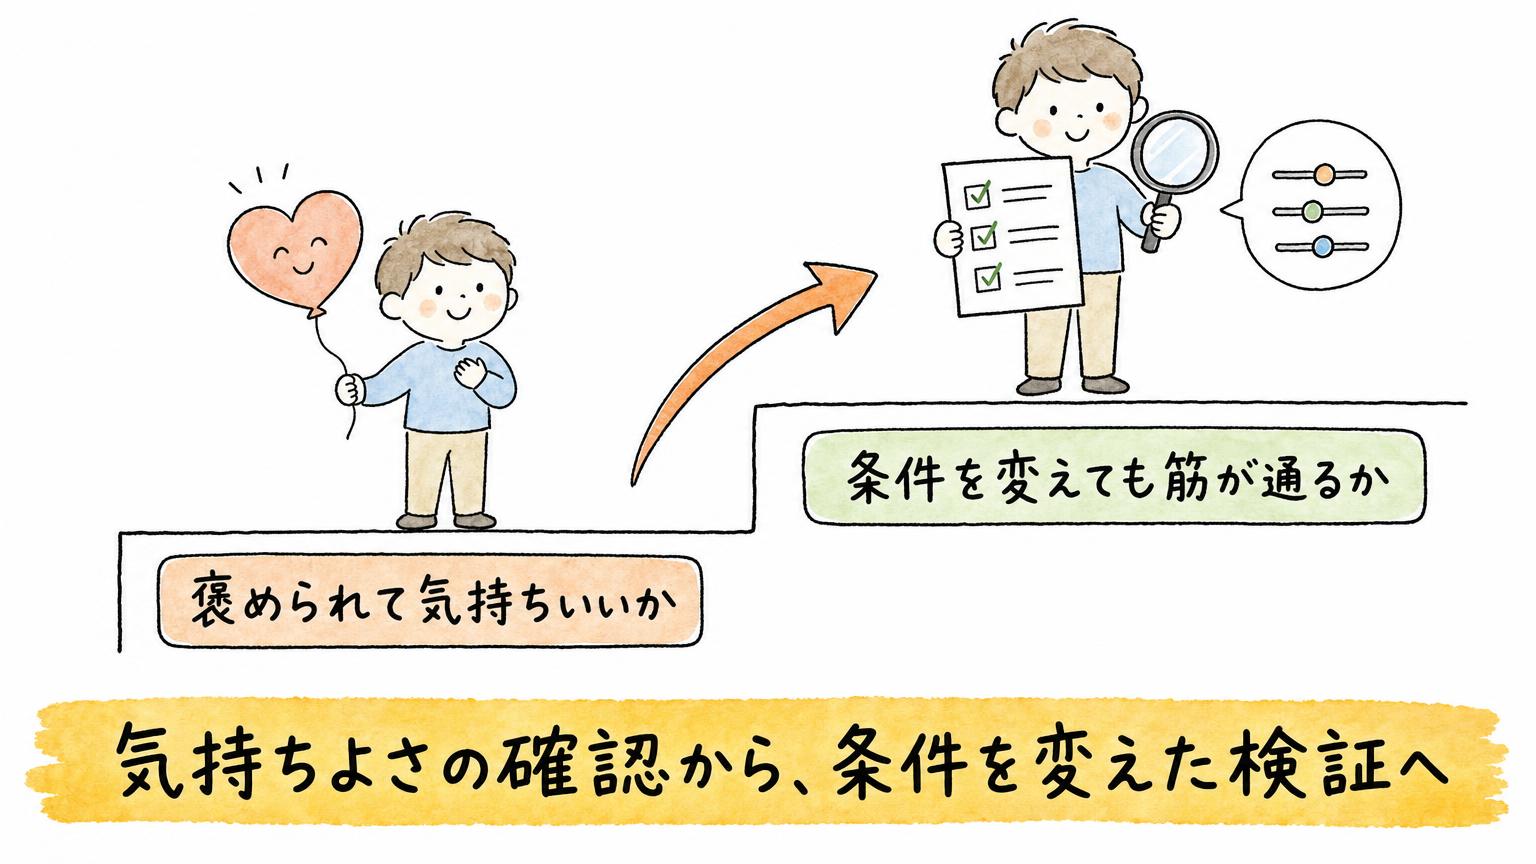
今回の更新は、AIとの付き合い方が、次の段階に入った合図だと思います。「褒められて気持ちいいか」を気にする段階から、「条件を変えても筋が通るか」を試す段階へ。AIを、合わせてくれる相手から、条件で確かめられる相手に変えていく流れです。
使う側は、賛否と条件を変えて、一度試してみてください。数分でできます。
提供する側には、迎合を測る専用の評価と、好評でも止める判断が、これからいっそう問われるでしょう。迎合しない代わりに、心地よくないやり取りへ進むのか。それとも、ある程度ユーザーに寄り添い、心地よさを重視するのか。このバランスは、今後も調整が入るかもしれません。引き続き注目していきましょう。
褒めが減ったことは、歓迎してよい変化です。そのうえで、判断の質は、自分で確かめにいく。そうすれば、壁打ちの相手として、ChatGPTはもっと頼れる存在になります。
よくある質問(FAQ)
Q1. 10月29日のChatGPTの更新は、有料プランにも影響しますか?
影響は限定的です。OpenAIのリリースノートによると、対象は無料プラン、Go、ログインなしの利用です。PlusとProは主なモデルが変わらず、GPT-6の利用上限に達したあとに切り替わるモデルだけが対象になります。
Q2. ChatGPTが褒めなくなったら、判断に使えるAIになったと言えますか?
言えません。知識量や正答率が上がったという比較値は、発表されていません。判断の質を決めるのは褒めの量ではなく、根拠に沿って賛成も反対もできるかどうかです。
Q3. AIが依頼者に迎合していないかは、どう確かめればよいですか?
同じ資料と評価基準を渡し、「進めたい」と「見送りたい」という意向だけを変えて返答を比べます。資料にない理由を足して両方に同意するなら、迎合を疑います。そのうえで条件を1つだけ変え、根拠に応じて判断が変わるかも見ます。
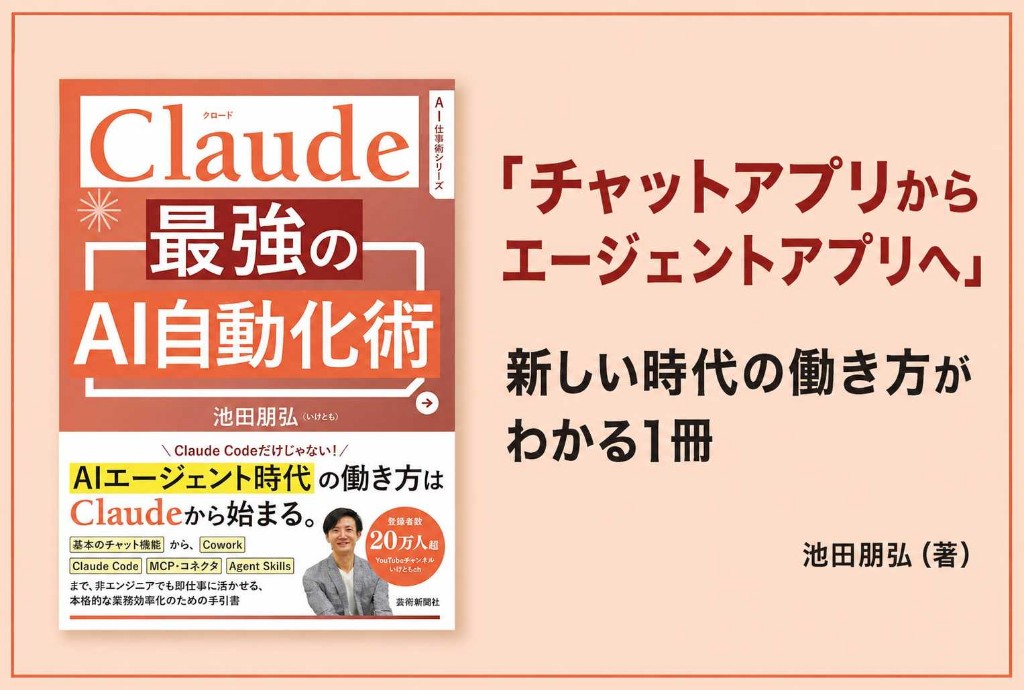
AIが先回りして考える時代を「システムゼロの時代」と名づけ、尾原さんと書いた共著『システムゼロ』が、11月10日に発売予定です。AIに迎合されて気持ちよくなる落とし穴と、その時代の生き方を扱っています。
AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」。AIの返答を、条件を変えて確かめるような実務を、持ち寄る場です:https://frontier-leaders.vercel.app/
2時間で、AI活用術を実践のハンズオンで学べます(過去回のアーカイブ):https://handson.workstyle-evolution.co.jp/
毎週のAIニュースを、動画で追えるYouTube『いけともch』:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事
人気記事RANKING
-

DeNA「AI活用100本ノック」の中身を9パターンに分類|職種別の使いどころ
-

AIビデオでキャラクターを一貫させる完全ガイド|参照画像・プロンプト・よくある失敗と対策
-

AIで作るミュージックビデオ&短編映画|HeyGenの使い方
-

ChatGPTの会話監視と警察共有の実態:OpenAIの新ポリシーで知っておくべき重要事項
-

Suno V5とSuno Studio完全ガイド:プレミアム限定の革新的音楽編集機能を徹底解説
カテゴリー
- 主要AIサービス (114)
- 画像生成AI (87)
- 動画生成AI (114)
- 音楽・音声生成AI (28)
- AI開発・効率化ツール (153)
- AIのビジネス活用 (198)
- 教育×AI (19)
- AIの知識&トレンド (233)
- いけともサブチャンネル (420)
- AIエージェント時代の働き方 (1)
タグ
Agent V3
AI字幕
AI字幕ツール
Alibaba
Amazon Seller Assistant
Amazon Seller Central
AP2
ATOS
ByteDance
CAG
Cognition AI
Comscore
cotomi Act
DAW
DevOps
Gemini Advanced
GUGA
HeyGen
HunyuanImage
HunyuanImage-2.1
IndexTTS2
JR東日本
NEC
OpenAI Platform
Oracle
Perplexity Search API
Qwen3-Next
Replit
SeeDream
SongBloom
Stargateプロジェクト
Suno Studio
Thinking Machines
インコンテキストラーニング
カスハラ
コネクタ
ステム分離
ソフトバンクグループ
データセンター
パナソニックコネクト
事故対応
動画解析AI
暗黙知
決定論性
鉄道運行管理
公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ