
OpenAI「GPT-6 Sol・Luna」のAPI料金は半額に——キャッシュ入力90%割引
- OpenAIがGPT-6 SolとLunaを発表し、API価格をGPT-5.6の期間限定価格から半額にしました。
- キャッシュ済み入力は90%割引で、SolはAutomationBenchでOpus 5を上回るスコアを約9%のコストで出しました。
- ただし半額の基準は期間限定価格で、ベンチマークの数字はOpenAI自身の測定である点に注意が必要です。
長い調べものや定型作業をAIエージェントに任せて、席を離れたとします。戻ると作業は終わっているのに、その裏で積み上がった利用料金を見て、次も同じ頼み方を続けるか迷ったことはありませんか。
「いいモデルを使いたい。でも、毎回この金額は払えない」。
その悩みに、OpenAIが正面から答えてきました。新モデル「GPT-6 Sol」と「GPT-6 Luna」は、APIの価格がGPT-5.6の期間限定価格から半額になり、性能も前世代より上がったと発表されています。
目次
最高性能はAstra、日常業務はSolとLuna
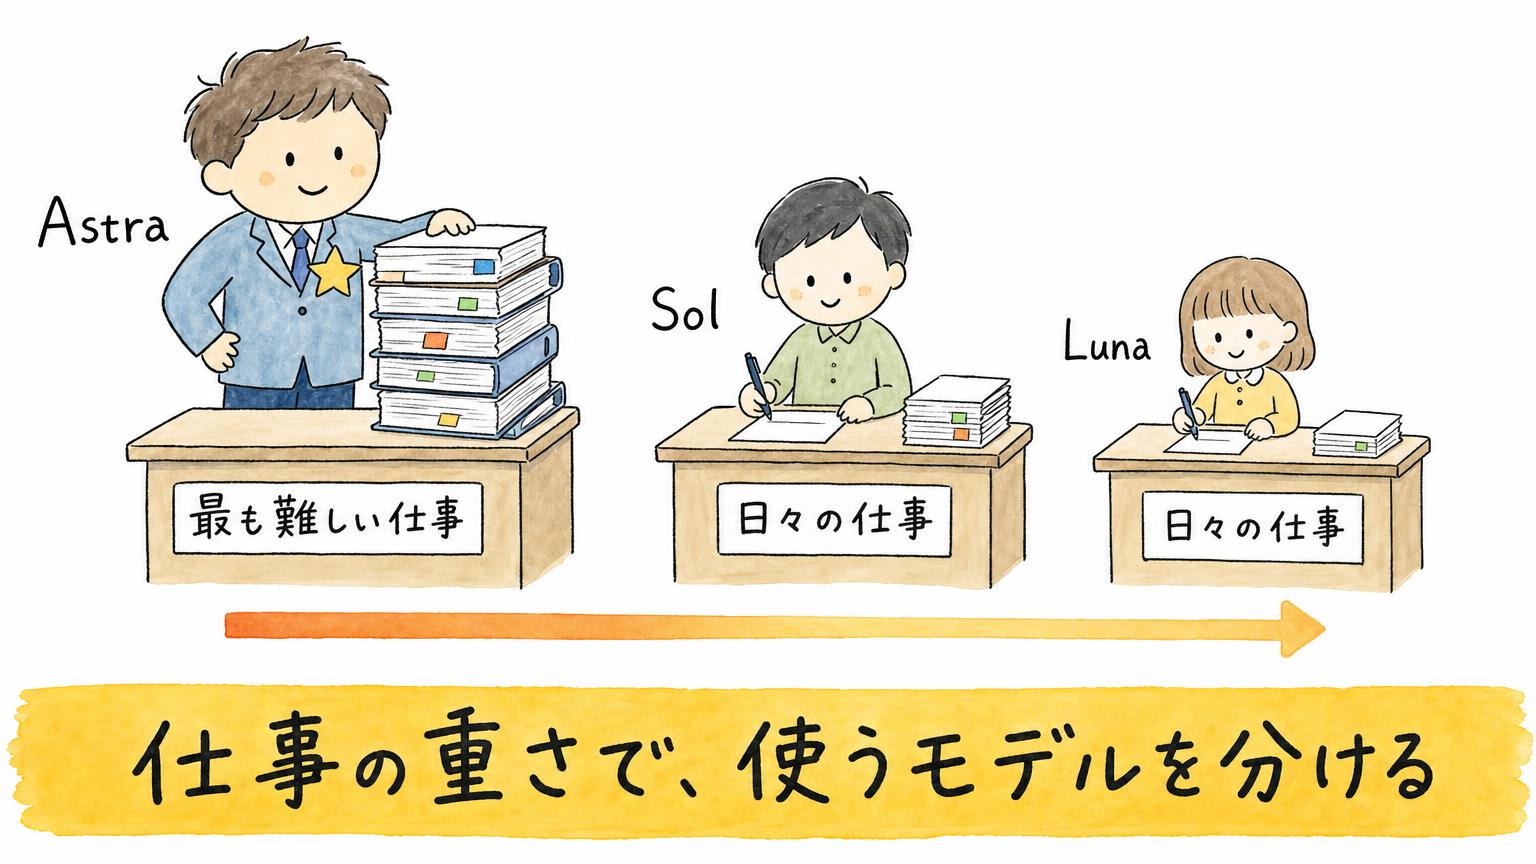
OpenAIは9月、最上位モデル「GPT-6 Astra」を発表しました。今回のSolとLunaの発表は、その続きにあたります。
OpenAIの説明はこうです。仕事には、規模もリズムも予算も違いがあります。だから、最も重要で難しい仕事にはAstraの深さを使い、日々の仕事にはコスト効率を高めたSolとLunaを使う、という分担です。
最高性能はAstra、日常業務はSolとLuna。これが、今回の発表の骨格です。
SolとLunaは、Astraと同じような手法で訓練されました。専門業務、事実性、コーディング、コンピュータ操作(画面を見てパソコンを操作する力)といった強みを、より速く安いモデルに引き継いだとされています。
事実性の社内評価では、Solの誤りは前世代のおよそ半分でした。ただし、ユーザーが誤りを指摘した会話だけを集めたテストなので、日常の誤り率そのものではありません。
使える場所は、ChatGPT WorkとCodexです(Plus・Pro・Business・Enterprise・Edu)。FreeとGoの利用者も、デスクトップアプリでLunaを使えます。APIでは「gpt-6-sol」「gpt-6-luna」の名前で提供され、発表時点では通常のチャット画面にはまだ入っていません。
▶︎ あわせて読みたい:最上位のAstraは何が変わったのか——「AI社員」に仕事を渡す段階へ
価格は半額、比べる相手は期間限定価格
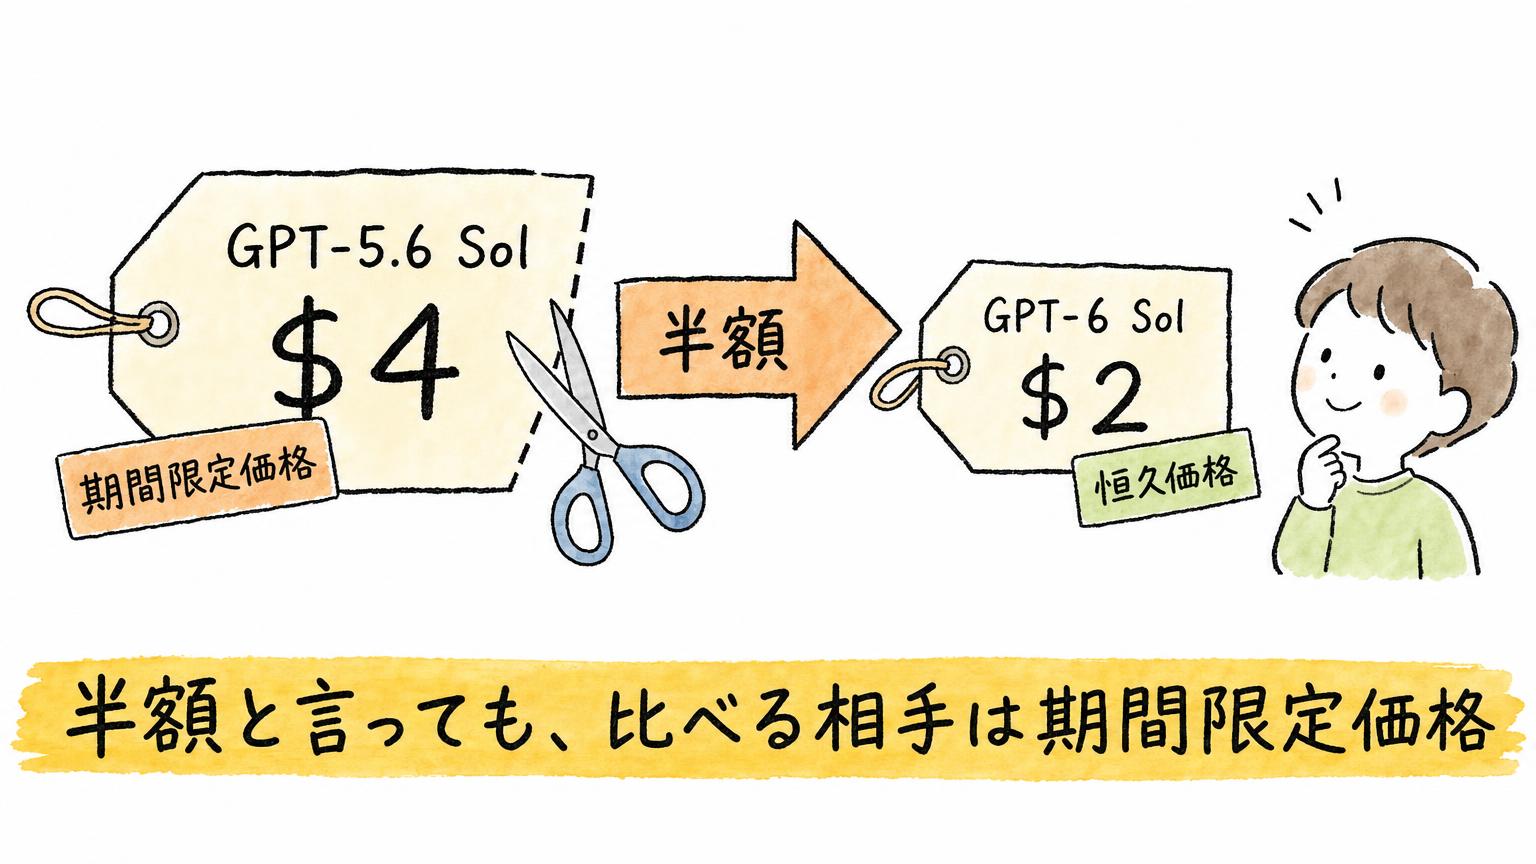
OpenAIは、SolとLunaのAPI価格を、GPT-5.6の期間限定価格(promotional pricing)と比べて50%引き下げたと説明しています。100万トークンあたりの新旧価格は次のとおりです。
GPT-6 Sol:入力 $4 → $2/出力 $20 → $10
GPT-6 Luna:入力 $0.20 → $0.10/出力 $1.20 → $0.50
半額の基準は、GPT-5.6の期間限定価格です。いわゆる通常価格との比較ではない点は、押さえておきたいところです。
一方で、新しい価格そのものは期間限定ではありません。OpenAIの広報が「GPT-6のこの価格は恒久的なもので、キャンペーン価格ではない」と説明したと、VentureBeatは伝えています。予算を組む側には、ありがたい説明です。
なお、Lunaの出力は$1.20から$0.50なので、計算上の値下がりは約58%です。
Lunaの価格は、中国勢の軽量モデルと並べても遜色ありません。DeepSeek V4.1 Flashは入力$0.30・出力$1.20(時間帯によっては半額の$0.15・$0.60)、Qwen3.8-Flashは$0.15・$0.47、GLM-5.3-Flashは$0.15・$0.50です。Lunaより安い軽量モデルも一部にはありますが、価格だけを見れば、Lunaは最安クラスに入ります。
後で見るとおり、性能もDeepSWEでOpus 5のmedium設定に並びます。Lunaは、価格あたりの性能で見て、非常にコスパの高いモデルと言えそうです。
位置づけも見ておきます。公式の料金ページでは、最上位のAstraが入力$10・出力$50です。Solはその5分の1、Lunaは100分の1にあたります。
値下げの理由について、OpenAIはキャッシュと推論の効率化で提供コストが下がり、その分を価格に反映したと説明しています。次は、そのキャッシュの仕組みを見ます。
安さを支えるのは、キャッシュの90%割引
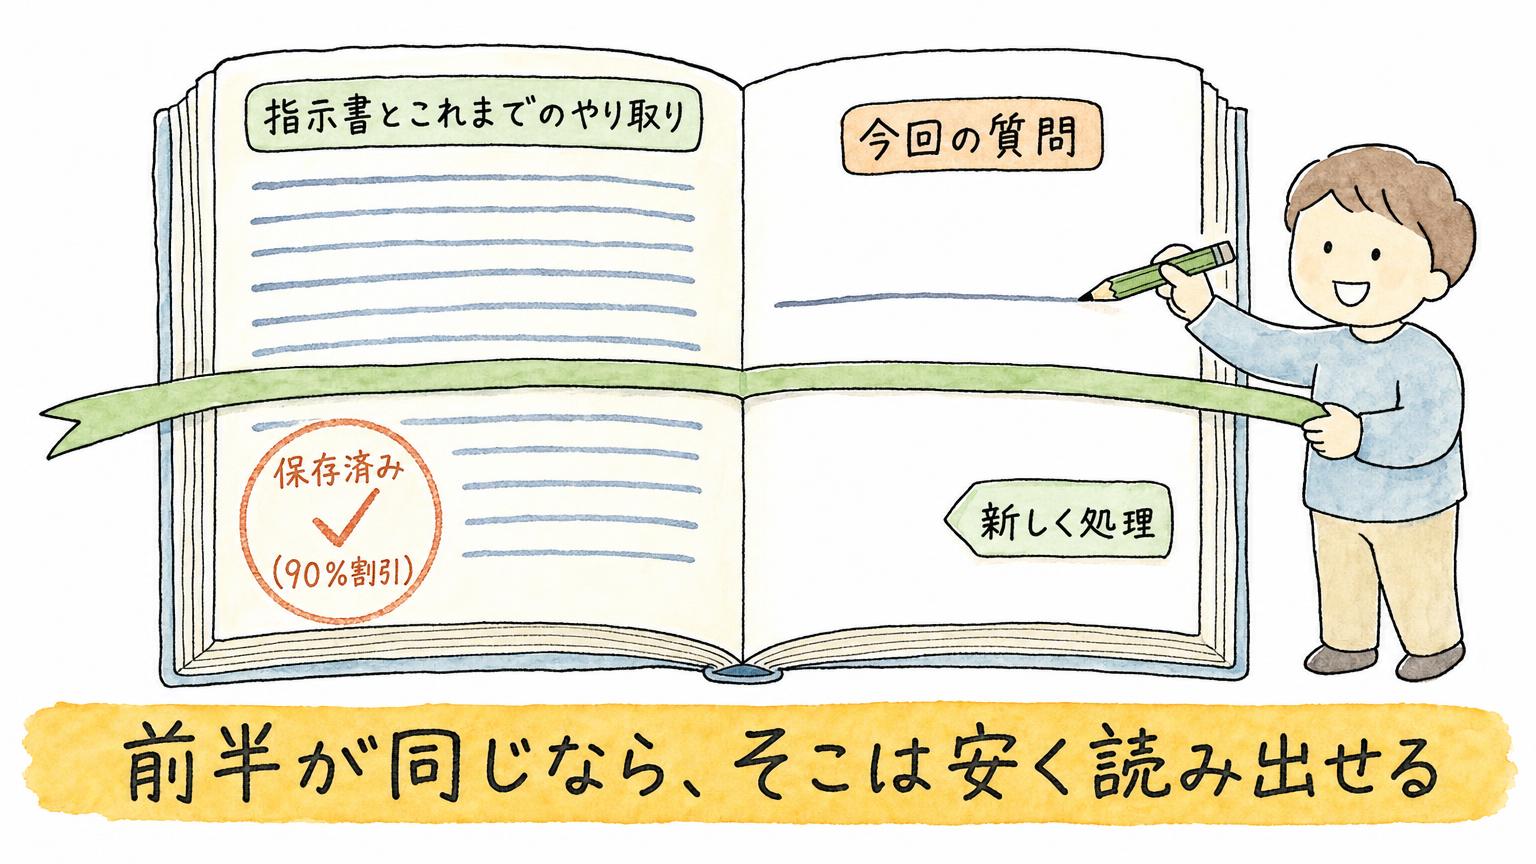
「プロンプトキャッシュ」とは、AIに送る文章(プロンプト)のうち、前回と先頭から同じ部分の処理結果を保存しておき、次から使い回す仕組みです。読みかけの本に「しおり」を挟んでおくと、次は続きから読めるのと同じです。
しおりまでが「処理済みの部分」、しおりから先が「新しく読む部分」にあたります。公式のドキュメントも、キャッシュされるのはプロンプトの先頭から変わらない部分だと説明しています。
具体例で考えます。長い指示書と、これまでのやり取りは毎回同じで、最後の質問だけが違う入力です。最後の質問だけを新しく処理し、前の部分は保存済みの結果を読み出します。
AIの答えが毎回変わっても、キャッシュには関係ありません。保存されるのは入力の処理結果であって、答えそのものではないからです。
キャッシュを効かせるコツは、プロンプトの「最初の文章」をなるべく同じにすることです。固定の部分と変動する部分を分けたうえで、固定の部分を多く、先頭に置きます。OpenAIのドキュメントも、変わらない指示や共有資料を先頭に置き、時刻やユーザー固有の内容は末尾に置くよう勧めています。
GPT-6では、キャッシュ済みの入力の読み込みが90%割引になり、キャッシュも効きやすくなったとOpenAIは説明しています。Solの入力単価$2なら、キャッシュが効いた部分は$0.20の計算です。
効きやすくなった点として、OpenAIは3つを挙げています。
① 使われ方を見える化する:キャッシュされた入力の割合を、ダッシュボードで確認できます。外れた理由は診断ツールで調べられます。
② 途中で設定を変えても、キャッシュが残る:推論の強さ(effort)を上げ下げしても、ツールのオン・オフを切り替えても、それまでの文脈が再利用されます。
③ キャッシュの区切りを選べる:「ブレークポイント」を指定して、どこまでをキャッシュの対象にするかを開発者が決められます。
GitHubの報告では、この数か月の改善によって、OpenAIのモデルへの数十億件のリクエストで、新しく処理が必要なプロンプトの割合が50%以上減りました。Copilotの応答も速くなったといいます。
同じ前提を繰り返し使うほど、キャッシュは効きます。エージェントは同じ指示書やツール定義を何十回も読み直すので、いちばん恩恵が大きい使い方です。逆に、毎回前提を書き換えると先頭が一致せず、ほとんど効きません。
性能は5つの指標で上位に並びました
安くても、弱くては意味がありません。OpenAIが示した5つのベンチマークを見ます。競合の数字は、公開されている報告から取ったものだとOpenAIは断っています。設定の「xhigh」「max」「medium」は、AIが考える強さの段階です。
①業務ワークフロー(AutomationBench)
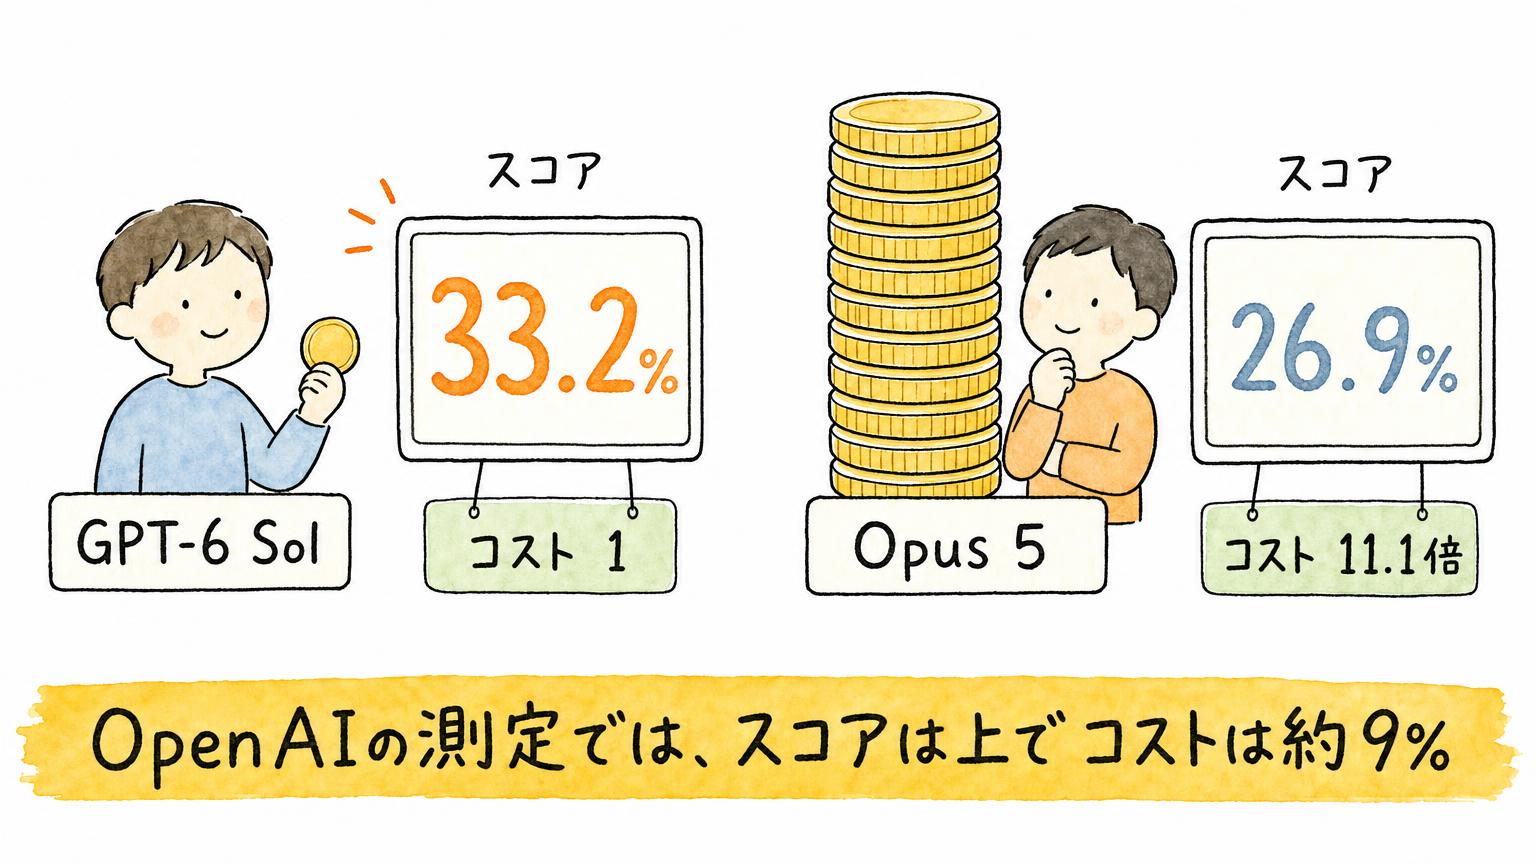
営業・マーケティング・サポート・財務・人事など、47種類のツールを使う業務をこなす力のテストです。Solは1タスク$0.27で33.2%を出し、Opus 5(max)の26.9%を上回りました。Opus 5のコストはSolの11.1倍です。これが「Opus 5の9%のコスト」の出どころです。
単価でも差があります。Solは入力$2・出力$10で、Claude Sonnet 5と同じ価格です(Sonnet 5の$2/$10は導入価格から標準価格に確定したと、Anthropicの公式ページにあります)。Opus 5は入力$5・出力$25、より新しいOpus 5.5でも入力$4・出力$20です。
Sonnetと同じ価格帯で、OpenAIの測定ではOpus 5を上回るのですから、Solのコスパはかなり高いと言えそうです。
比較の位置づけも添えます。このテストでは、最上位Astraを低設定(low)で動かした30.3%もSolが上回り、Astra(low)のコストはSolの3.9倍でした。Fable 5.1(上位モデルOpus 5への切り替え込み)は31.4%で、コストはSolの8.9倍超とされています。OpenAIによれば、切り替え分のコストは含まれておらず、実際はさらに高くなります。
②専門業務の長時間タスク(Agents’ Last Exam)
55の業種にまたがる、長い専門業務を評価するテストです。Sol(max)は56.4%で、評価内のOpus 5の最高スコアを上回り、タスクあたりのコストは60%低くなりました。Opus 5の具体的な点数は、発表文には書かれていません。
③ソフトウェア開発(DeepSWE)
実際のコードベースで、長い開発タスクを解くテストです。Sol(max)は68.8%で、Fable 5の最高スコア69.9%(xhigh)に1.1ポイント差まで迫りました。コストは約80%低い計算です。
Luna(max)も66.6%で、Opus 5・Fable 5のmedium設定と同等でした。コストはOpus 5より93%、Fable 5より96%低くなっています。
④パソコン操作(OSWorld 2.0)
長い操作を伴う、パソコン作業のテストです。Sol(xhigh)は60.5%で、Opus 5(medium)の60.3%とほぼ同じです。コストは約80%低くなりました。Luna(max)は、GPT-5.6 Sol(medium)を上回り、コストは10分の1です。
⑤マージできるコード(FrontierCode)
コードが正しいかだけでなく、テストの質や変更範囲の絞り方など、そのまま取り込める品質かを見るテストです。SolはGPT-5.6 Solから大きく伸び、Fable 5.1(xhigh)に並ぶとされています。コストははるかに低いものの、具体的な点数は発表文に載っていません。
5つを並べると、共通点が見えてきます。数字が示されたものでは、Solは比べた相手と同じ水準のスコアを、6割から9割低いコストで出しています。Lunaはさらに安く、DeepSWEではOpus 5のmedium設定に並びました。
もちろん、これはOpenAI自身の測定で、比べる設定もモデルごとに違います。それでも、発表された範囲では、性能あたりのコストなら、Solは最有力候補です。「コスパ最強モデル」になりそうな気配は、十分にあります。
明日から試す3つのこと
OpenAIの社内では、コーディングエージェントの1日あたりの利用量が、API価格に換算すると、研究者の中央値で600ドル超、上位10%で7,000ドルを超えたといいます。長く任せるほど、単価の差が効いてきます。
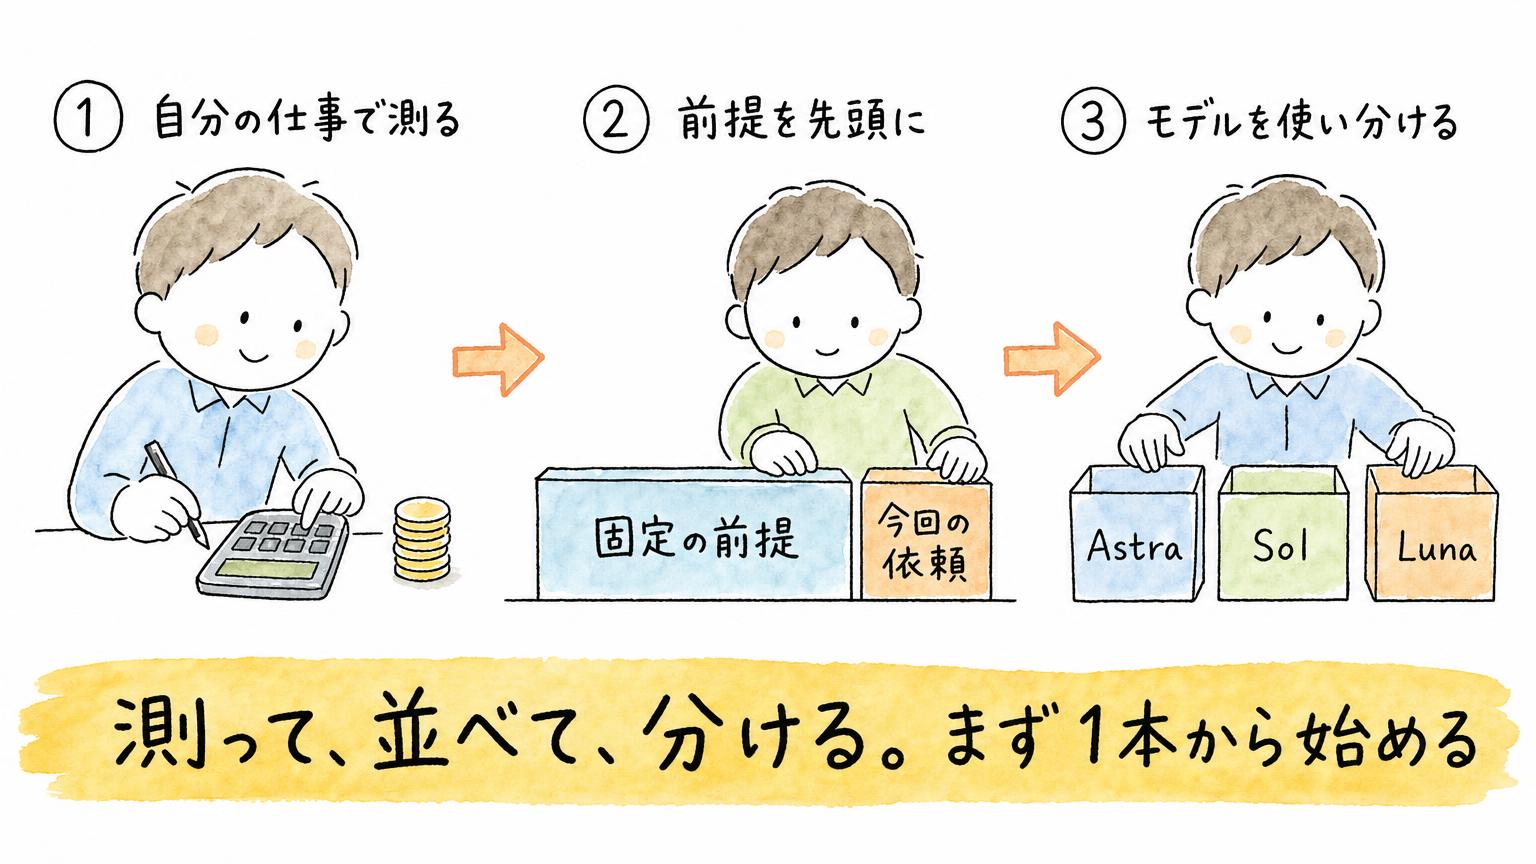
①代表タスクを1本選び、SolとLunaで「1回あたりのコスト」を測る
ベンチマークの数字は、他人の仕事の結果です。自分の仕事での品質とコストは、自分で測るのが確実です。Astraと並べて測れば、使い分けの線も引けます。
②プロンプトを「変わらない前提を先頭、毎回変わる依頼を末尾」に組み替える
長い指示書、ツールの定義、過去のやり取りを前に置き、今回の依頼を最後に置きます。組み替えたら、効き具合を診断ツールで確かめられます。
③使い分けの型を先に決める
たとえば、いちばん難しい判断や最終確認はAstra、日々の反復業務はSol、大量の軽い処理はLuna、といった分け方です。型があれば、モデルが変わっても迷いません。
単価が下がると、同じ予算で試せる回数が増えます。判断の中心は、「導入するか」から「どこまで任せるか」へ移っていくでしょう。
Astraで最高の結果を狙い、日々の仕事はSolとLunaへ。その分担が、AIエージェントを「毎日使う道具」にする現実的な形になりそうです。
▶︎ あわせて読みたい:AIエージェントを1回のAPI呼び出しで動かす——Agents APIで日本企業が確認すべき3つのこと
よくある質問(FAQ)
Q1. GPT-6 SolとLunaのAPI料金はいくらですか?
100万トークンあたり、Solは入力$2・出力$10、Lunaは入力$0.10・出力$0.50です。いずれもGPT-5.6の期間限定価格(Solは$4・$20、Lunaは$0.20・$1.20)から半額とOpenAIは説明しています(Lunaの出力は$1.20から$0.50なので、計算上は約58%の値下がりです)。半額の基準は通常価格ではなく期間限定価格ですが、新しい価格そのものは恒久的だと、OpenAIの広報が説明したと報じられています。
Q2. プロンプトキャッシュとは何で、どれくらい安くなりますか?
AIに送る文章のうち、前回と先頭から同じ部分の処理結果を保存して使い回す仕組みです。GPT-6ではキャッシュ済み入力の読み込みが90%割引になり、Solの入力単価$2なら、キャッシュが効いた部分は$0.20の計算です。変わらない指示や資料を先頭に、毎回変わる依頼を末尾に置くと効きやすくなります。
Q3. SolとLunaは、Opus 5より性能が高いのですか?
OpenAIの測定では、業務ワークフローのテスト(AutomationBench)で、Solが1タスク$0.27で33.2%を出し、Opus 5(max)の26.9%を上回りました。Opus 5のコストはSolの11.1倍です。ソフトウェア開発のテスト(DeepSWE)では、Luna(max)の66.6%がOpus 5・Fable 5のmedium設定と同等でした。ただしOpenAI自身の測定で、比べる設定もモデルごとに違います。
GPT-6やClaudeなど、最新のAIニュースを毎日動画で解説しています。YouTube『いけともch』:https://www.youtube.com/@iketomo-ch
ChatGPT Workで仕事を自動化する手順は、手を動かして学べるハンズオン(過去回のアーカイブ)があります:https://handson.workstyle-evolution.co.jp/
■合わせて読みたい
■関連記事
公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ