
Meta「Muse Wonder」とClaude・GPTを5項目で比較、強いのは長期開発と記憶の2つ
Meta「Muse Wonder」とClaude・GPTを5項目で比較、強いのは長期開発と記憶の2つ
- Metaが10月12日に「Muse Wonder」と上位版Fullを公開し、総合指数でGPT-6 Astraを上回りました。
- Claude・GPT-6との比較で強いのは、長期開発と記憶の2つです。
- 総合とプログラム再現・端末・PC操作はClaude Opus 5.5が上で、記憶の指標はMeta社内評価です。
10月12日、Metaが「Muse Wonder」と上位版の「Muse Wonder Full」を公開しました。最先端モデルの競争で後れを取っていたMetaが、総合指数でGPT-6 AstraやClaude Fable 5.1を上回り、一角に食い込んできた形です。
今回Metaが前面に出したのは、回答の賢さではなく、会話をまたいで覚える「記憶」、行き詰まっても進む「継続」、失敗から立て直す「回復」です。
では、Claude・GPT-6と比べてどこが強いのか。結論から言うと、はっきり強いのは「長期開発」と「記憶」の2つで、プログラム再現・端末・PC操作と総合ではClaude Opus 5.5が上でした。
公開された2モデルの入口と価格
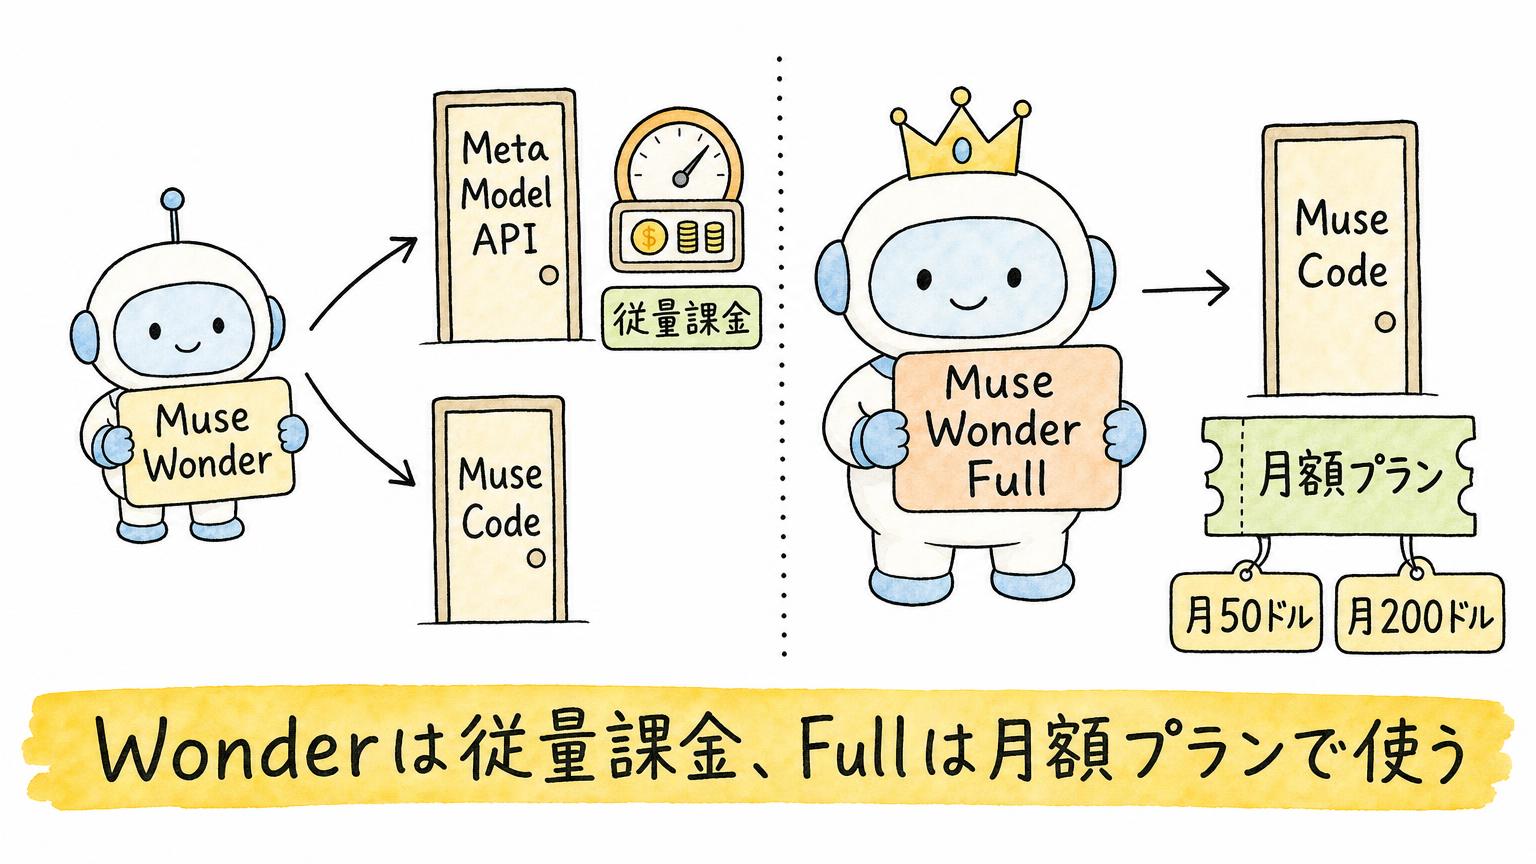
Muse Wonderは、Meta Model APIとMuse Codeの両方で使えます。Muse Wonder Fullは、Muse Codeの購読者向けです。月50ドルのPower Usageか、月200ドルのMaximum Usageに含まれ、API経由の従量課金はありません。
APIの料金は、100万トークン当たり入力4ドル、キャッシュ入力0.20ドル、出力20ドルです。出力は入力の5倍の単価なので、長い回答や繰り返しの生成が増えるほど、費用は出力側から膨らみます。
入力はテキスト・画像・動画・音声、出力はテキストで、推論時のコンテキスト長は100万トークンです。Metaの発表では、一般向けのMuseへの搭載は「近く」とされ、最初は購読者から広げる予定です。
▶︎ あわせて読みたい:MongoDB元CEOが率いるMetaの企業向けAI事業、その狙いは
Active Memory:文脈窓との違い
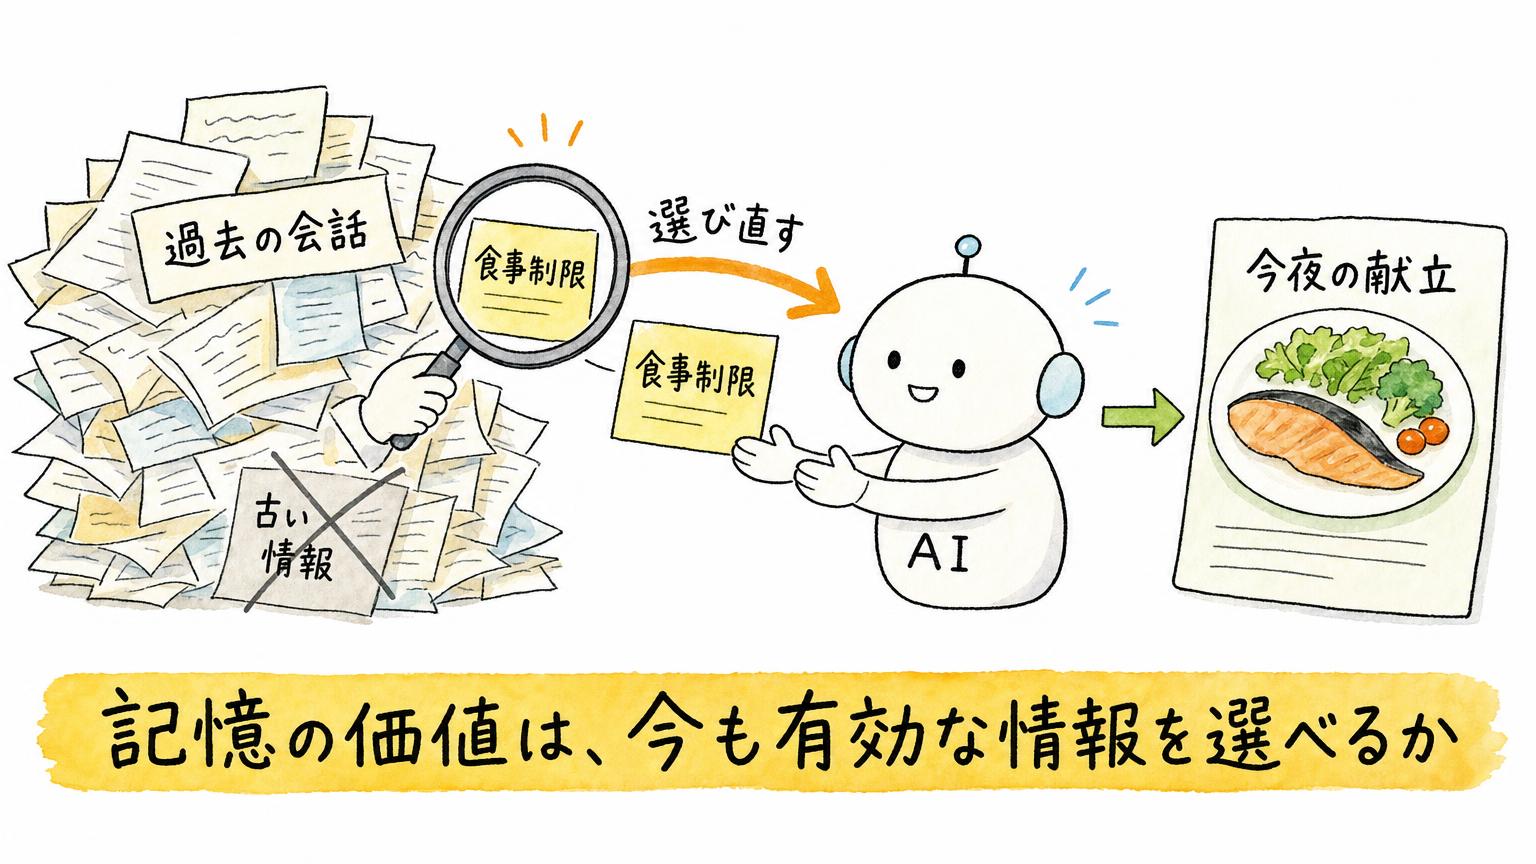
100万トークンの文脈窓は、一度に読める量の上限です。Active Memoryは、会話をまたいで大切なことを持ち運び、いまの作業に関係するものを取り出す力を指します。
たとえば、食事制限を伝えたのが何十回も前の会話だったとします。献立を頼んだとき、その制限を思い出して反映できなければ、容量が大きくても仕事にはつながりません。記憶の価値は、保存量ではなく、どの情報がいまも有効かを選べるかで決まります。
この力を測るのが、Meta社内のベンチマーク「MemoryBench」です。64K〜100Kトークンの複数の会話に、妨害用の会話と、前の内容と矛盾したり後から更新したりする情報を混ぜて、重要な情報を思い出せるかを問います。
Active Focus:止まってからの立て直し
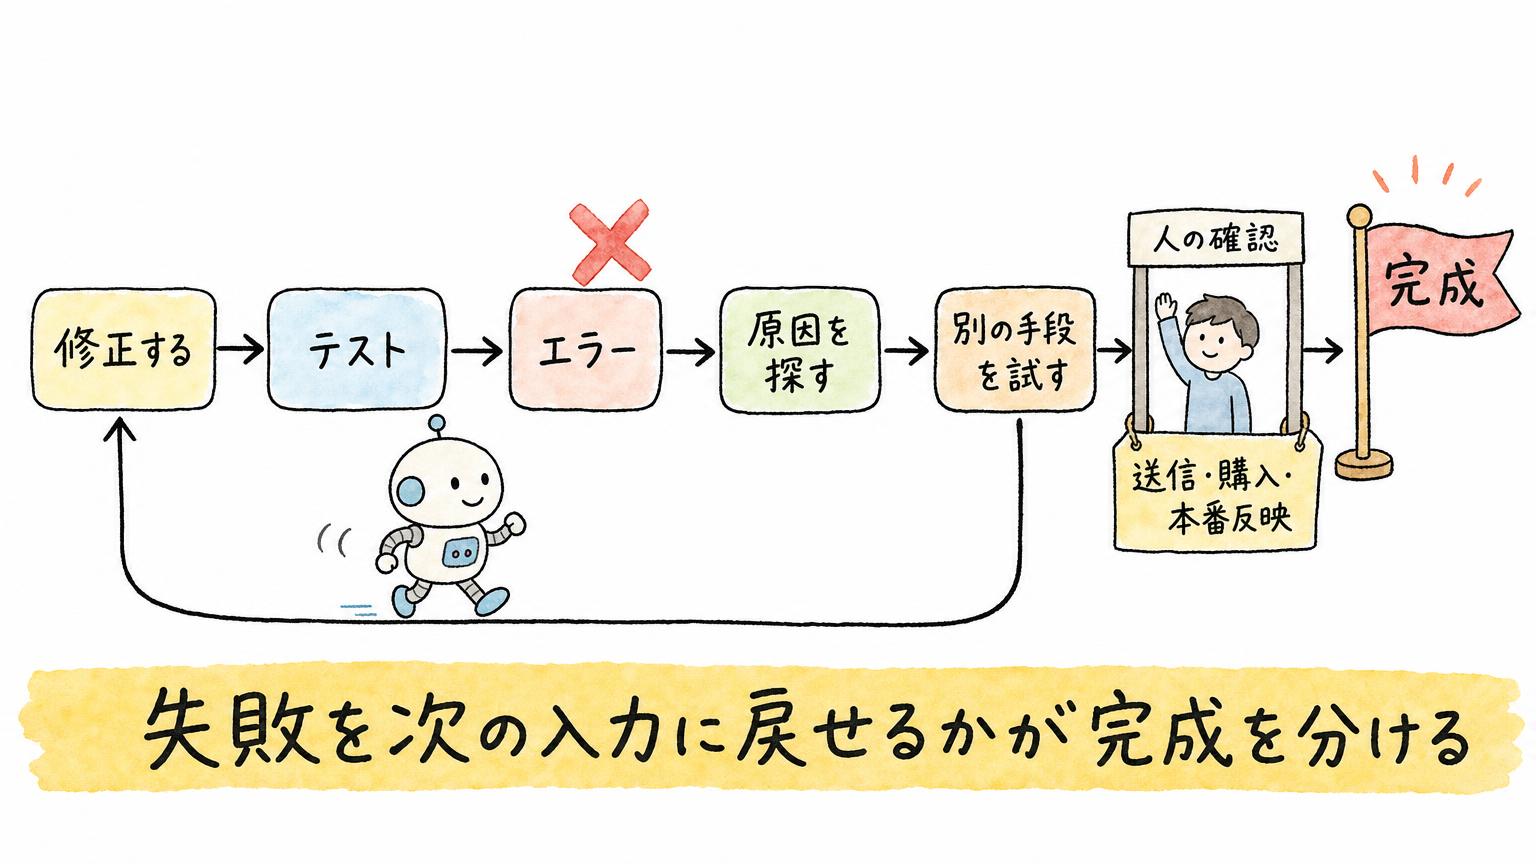
Active Focusは、難しい仕事でも目標に向かって進み続ける力です。行き詰まったら別の手段を試し、障害を乗り越え、新しい情報に合わせて進め方を変えます。
コード修正で考えると分かりやすくなります。要件を読み、複数のファイルを直し、テストを走らせ、失敗したら原因を見つけて直し直す。最初の案が正しいかより、失敗を次の入力に戻せるかが、完成までたどり着けるかを分けます。
一方で、重要な操作の前には立ち止まって確認する設計でもあります。モデルカードも、現実の操作ができる場面では、不可逆な操作に人の確認を入れるよう勧めています。
測る指標は2つあります。住宅・旅行・IT・金融などの個人向けタスクで、障害に粘り強く対処できるかを見る社内のFocusBenchと、長期のソフトウェア案件を最後のテストで採点するSWE-Marathonです。未知の多段の課題で誤ることは、モデルカードも既知の制約として挙げています。
Sparkに残った宿題
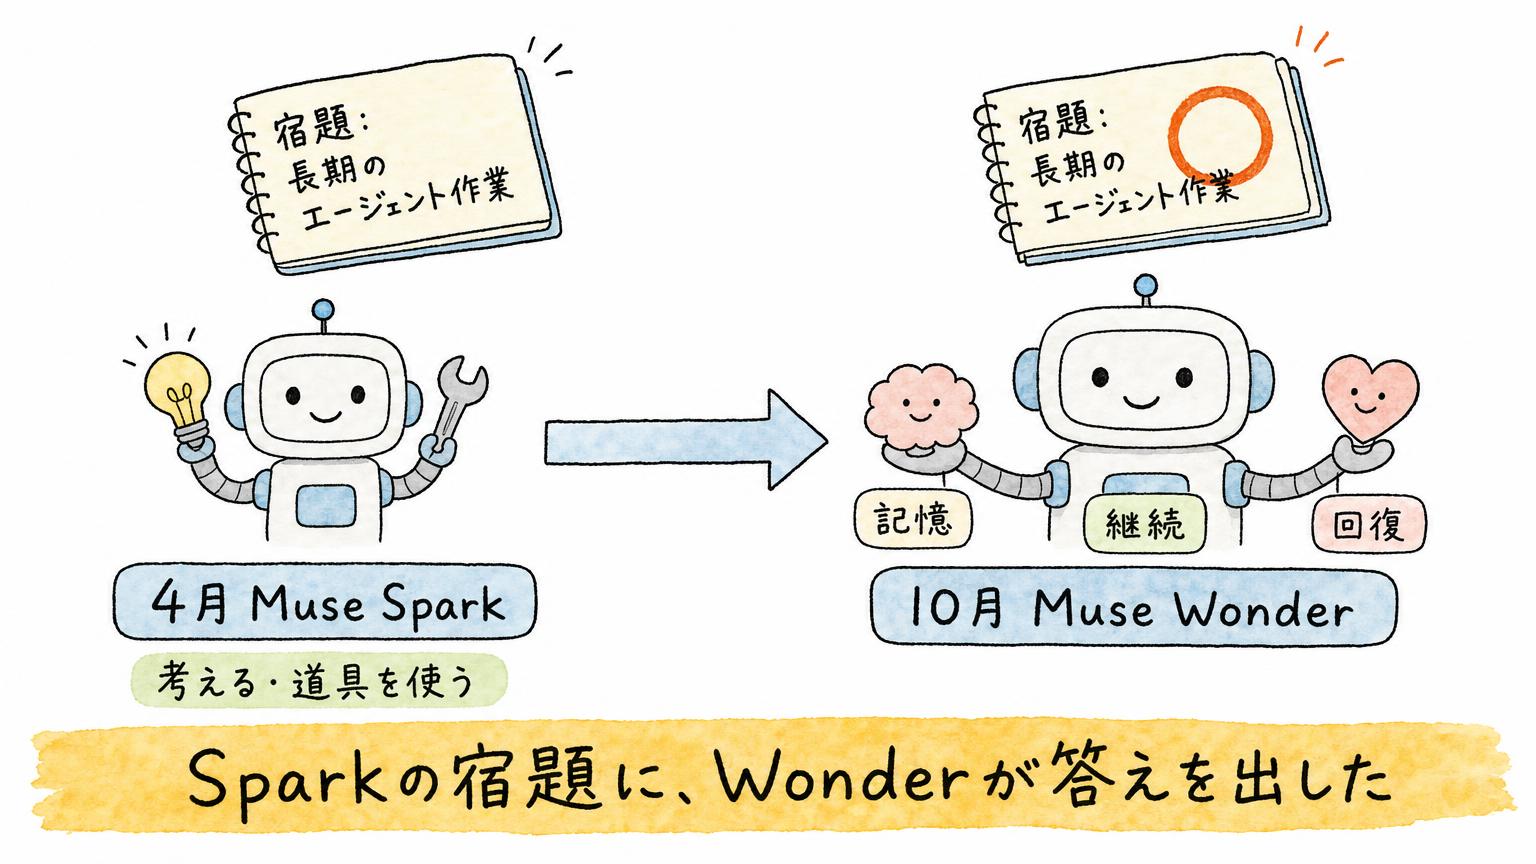
4月に発表されたMuse Sparkは、Meta Superintelligence Labsが開発したモデルです。そのときMetaは、長期のエージェント作業とコーディングを、性能の足りていない領域として自ら挙げていました。
つまり、難しい一問に答える力はあっても、状態を保ち、試行錯誤し、成果物を完成させる工程は宿題として残っていたわけです。Wonderが記憶と継続と回復を前面に出したのは、この宿題への答えだと読めます。
Metaの技術記事は、Wonder Fullが未知の課題で、Muse Spark 1.3の伸び方から予想される水準をさらに上回ったと説明しています。理由は、より大きく強いベースモデルを使うことで、事後学習の効果が学習していない課題にも移りやすくなったためとのことです。
Claude・GPT-6と5つの視点で比較
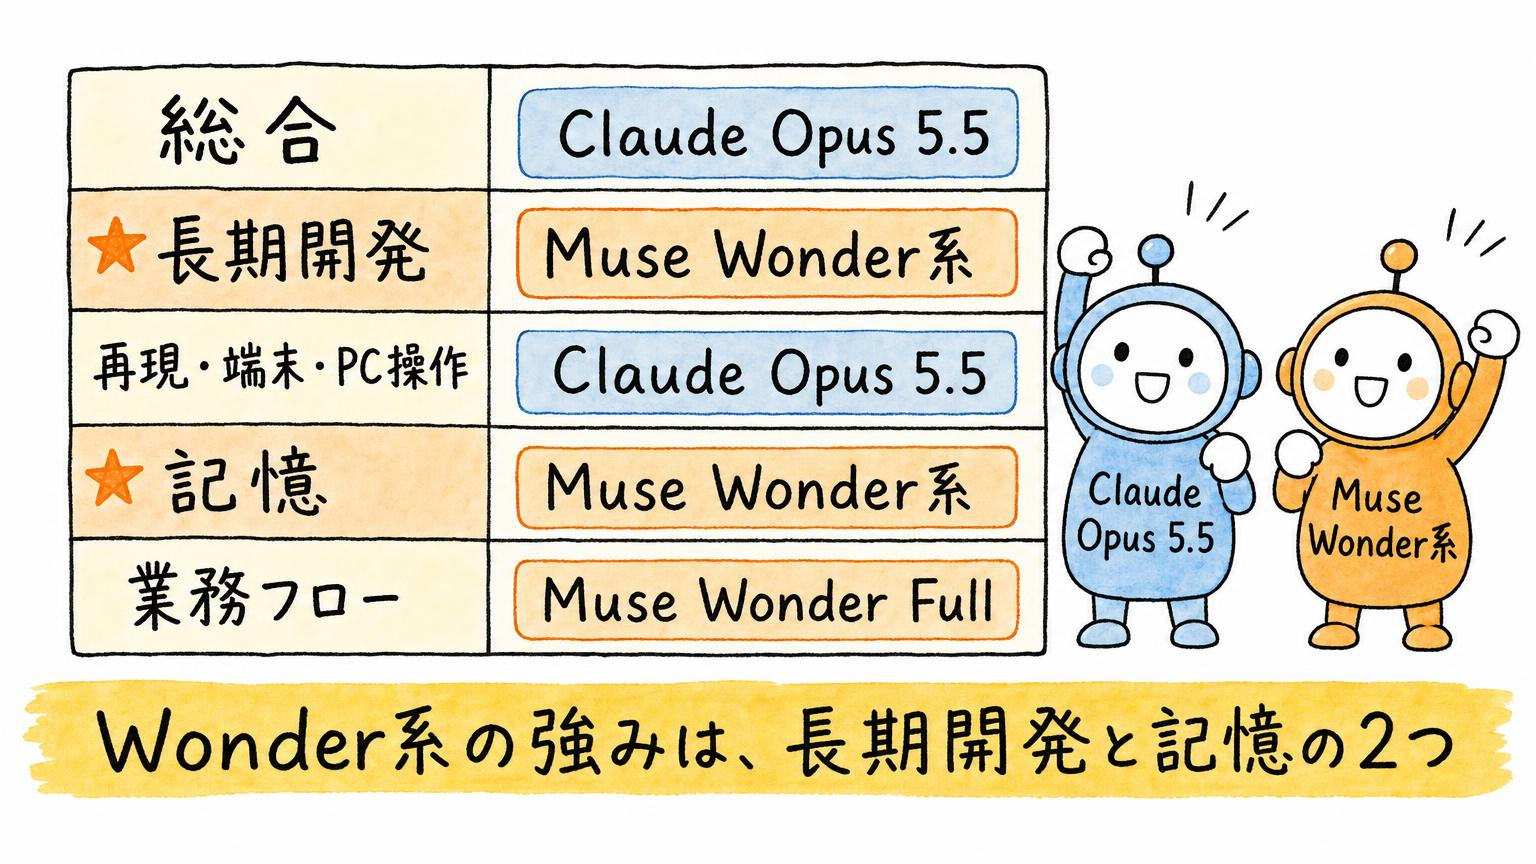
ここからが本題の比較です。モデルカードの表は、全モデルを最大の推論努力で動かした結果で、比べる相手はClaude Opus 5.5、Claude Fable 5.1、GPT-6 Astraです。数字はすべてMetaの公開値です。
① 総合:首位はClaude Opus 5.5
総合指数(Artificial Analysis Index)は、Opus 5.5が58、Wonder Fullが56、GPT-6 AstraとFable 5.1が53、通常版のWonderが52です。Fullは2位で、GPT-6 Astraを上回ります。
② 長期開発:Wonder系が上位を占める
DeepSWE 1.1は、Fullが79.0%、Wonderが78.8%で、Opus 5.5の74.2%、GPT-6 Astraの74.1%を上回ります。SWE-Marathonでも、Fullが57.5%でGPT-6 Astraの42.5%に約15ポイント差をつけました。
ただしSWE-Marathonは、競合側がCodexやClaude Codeでの値で、同じ環境で揃えた比較ではありません。Fullだけがxhighの推論設定です。
③ プログラム再現・端末・PC操作:Opus 5.5が上
プログラムを再現するProgramBenchは、Opus 5.5が70.5%、Fullが59.0%と、10ポイント以上の差があります。端末操作のTerminal-Bench 4.0はOpus 5.5が59.6%、GPT-6 Astraが59.1%、Fullが57.1%です。PC画面の操作を測るOSWorld V2.1も、Opus 5.5の81.8に対してFullは78.4でした。
長期開発での強さを、あらゆるコーディングや操作に広げることはできません。
④ 記憶:通常版Wonderが最も高い
MemoryBenchは、通常版Wonderが85.6、Fullが85.5で、Opus 5.5の81.5、GPT-6 Astraの81.4を約4ポイント上回ります。この指標では、FullとWonderはほぼ同じです。
これはMeta社内の評価で、64K〜100Kトークンの会話での成績です。数日間にわたって確実に覚えて働けることまでは示していません。
⑤ 業務フロー完遂:Fullは首位、通常版は届かない
業務の流れを最後まで終えるAutomationBenchは、Fullが45.4%で首位、GPT-6 Astraが41.6%、Opus 5.5が41.2%、通常版のWonderが39.1%です。同じWonder系でも、Fullの強さを通常版の性能として読むことはできません。
まとめると、Wonder系の強みは長期開発と記憶の2つです。プログラム再現・端末・PC操作と総合はOpus 5.5が上で、業務フロー完遂はFullだけが首位でした。使うモデルの列を分けて見る必要があります。
導入前に設計する3つ
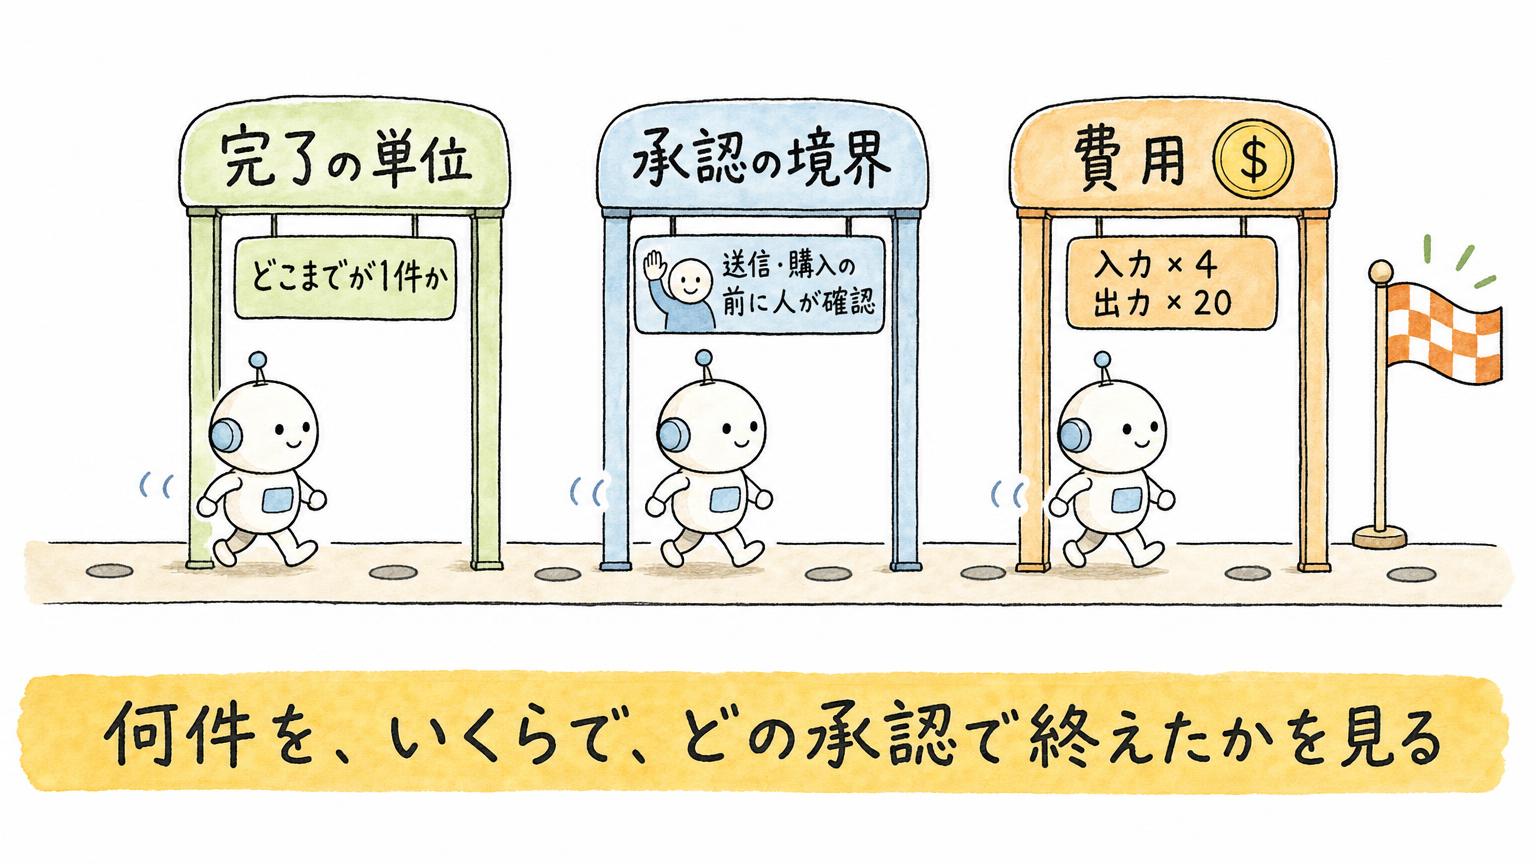
モデルの順位は、入口にすぎません。自分の仕事で結果を出すには、次の3つを先に決める必要があります。
① 完了の単位
入力、使える道具、途中の状態、成果物、合格条件を1件分として決めます。たとえばコード修正なら、課題への回答ではなく、リポジトリを読み、変更し、テストを通し、差分を出すところまでが1件です。モデルカードも、性能がプロンプトやツール、エージェントの実行環境で変わると明記しています。
② 承認の境界
下書きやテストの再実行は自動で回し、送信・購入・本番への反映の直前で人が確認する。これが基本の形です。権限や記録といった制御は、モデルの外に置く必要があります。モデルカードも、より広いAIシステムの一部として使うことを勧めています。
▶︎ あわせて読みたい:AmazonがMuseを締め出した理由は安全性ではなく「買い物の窓口」だった
③ 費用
たとえば、1件が新規入力10万トークン、出力1万トークンで、100件を1回ずつ回すとします。計算は100×(0.1×4ドル+0.01×20ドル)で、約60ドルです。検索や外部ツールの費用、再試行、待ち時間は含みません。Fullは月額プランなので、同じ土俵では比べられません。
自律実行を増やせるのは、成果をテストや差分で確かめられ、途中の操作を戻せ、同じ型の仕事が繰り返される場合です。正解が曖昧で、外部への影響が大きく、失敗に後から気づく仕事は、人中心に戻します。
導入の判断は、「何問正解したか」から「何件を、いくらで、どの承認を経て終えたか」へ移ります。
よくある質問(FAQ)
Q1. Muse Wonderの料金はいくらですか?
APIは100万トークン当たり入力4ドル、キャッシュ入力0.20ドル、出力20ドルです。出力は入力の5倍の単価です。上位版のMuse Wonder Fullは、Muse Codeの月50ドルのPower Usageか月200ドルのMaximum Usageに含まれ、API経由の従量課金はありません。
Q2. Muse WonderはClaudeやGPT-6より強いのですか?
長期開発と記憶では上回りますが、総合ではClaude Opus 5.5が首位です。プログラム再現・端末・PC操作もOpus 5.5が上でした。業務フロー完遂は、Muse Wonder Fullだけが首位です。数字はすべてMetaの公開値で、環境を揃えた第三者比較ではありません。
Q3. 導入前に何を決めておくべきですか?
完了の単位、承認の境界、費用の3つです。1件の仕事をどこまでと定義し、送信・購入・本番への反映の直前に人が確認する形にし、入力と出力のトークン単価から件数当たりの費用を見積もります。
エージェントにどこまで任せ、どこで線を引くか。AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」で、実務を持ち寄りながら探っています:https://frontier-leaders.vercel.app/
2時間で、エージェントアプリの活用を実践のハンズオンで学べます(過去回のアーカイブ):https://handson.workstyle-evolution.co.jp/
新しいモデルの発表も、YouTube『いけともch』で解説しています:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事
公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ