Gemini 4 Carbonは何に向く?Fable 5.2に近い品質を約6分の1の費用で出す、資料照合の強み
Gemini 4 Carbonは何に向く?Fable 5.2に近い品質を約6分の1の費用で出す、資料照合の強み
- Gemini 4 Carbonは、図表入りの資料から成果物を作る評価MKAで、Fable 5.2に近い品質を約6分の1の費用で出しました
- 長い資料のつながりを追う評価GraphWalksでも、前の版のArgonから10点以上伸びています
- 品質差は統計的に有意ではなく、費用に人の確認時間は含まれないため、合格1件あたりの総費用で比べるのが確実です
11月10日、Googleが最上位AI「Gemini 4 Carbon(ジェミニ4カーボン)」の提供を広げました。対象は有料の開発者・企業と最上位プランの加入者です。図表入りの資料から成果物を作る評価では、「Claude Fable 5.2(フェイブル)」に近い品質を約6分の1の費用で出しました。
前回取り上げたFable 5.2と並べると、Carbonの得意な仕事が見えてきます。Fable 5.2に近い精度を、はるかに安く出せること。そして、資料どうしを照合して確かめる力です。 コスパが要り、確認も要る仕事に向くモデルと言えます。この記事は、精度・コスパ・照合の3つの見出しで整理します。
Argon(アルゴン)と同じ単価の最上位モデル
Carbonは、Googleが「最強」と呼ぶモデルです。Googleは、能力を伸ばしながら、安全性と信頼性を損なわないことを目標に掲げています。
APIの単価は、前の版のArgonと同じです。導入価格は12月から2倍になりますが、Argonも同じく上がるため、両者の価格差は生まれません。そのうえで、長い資料をたどる評価や誠実性の評価などで、Argonより成績が伸びています。
ただし、Googleは大半の仕事にはArgonを勧めています。Carbonは、Argonより多くのトークンを使い、探索と検証を重ねる、難しい仕事向けのモデルという位置づけです。
使えるのは、有料のAPIと、最上位プランの加入者向けのGeminiアプリなどです。
特徴1 精度:Fable 5.2に近い品質
精度を比べる物差しとして、ここでは「MKA(エムケーエー)」を使います。Googleが評価機関と共同で公開した、図表入りの資料から成果物を作る評価です。
10の分野の専門家と作った200の課題で、複数の資料を読み込んで仕上げる、手間のかかる仕事が並びます。
たとえば人員配置の課題では、人員のCSV、部門間の人の流れを示す図、配置ルールのPDF、Excelテンプレートが渡されます。AIはこれらを読み合わせ、指定の書式でExcelを納品します。
結果は次のとおりです。「難項目の品質」は、旧世代のモデルが十分にこなせなかった難しい採点項目を、どれだけ満たしたかの割合です。★は、品質は最高値、費用は最小値に付けています。
- Gemini 4 Carbon:難項目の品質 54.34%、平均API費用/課題 ★5.63ドル
- Claude Fable 5.2:難項目の品質 ★56.56%、平均API費用/課題 35.28ドル
- GPT-6 Astra:難項目の品質 50.24%、平均API費用/課題 6.03ドル
難項目の得点差は約2ポイントです。Googleの技術報告でも、この実験では統計的に意味のある差は出ていません。
Carbonが上回る評価もあります。Anthropic自身の比較表では、業務の流れを自動で処理する評価で、Carbonが約54%、Fable 5.2が約51%でした。
反対に、同じ表のコード修正の評価では、Fable 5.2が約49%、Carbonが約41%でFableが上です。比べた思考の設定は両者で違います。
▶︎ あわせて読みたい:Fable 5.2で「丸投げ」の単位が変わった──研修一式を約6時間で仕上げた実例と、公式の2つの数字
特徴2 コスパ:課題あたりの費用は約6分の1
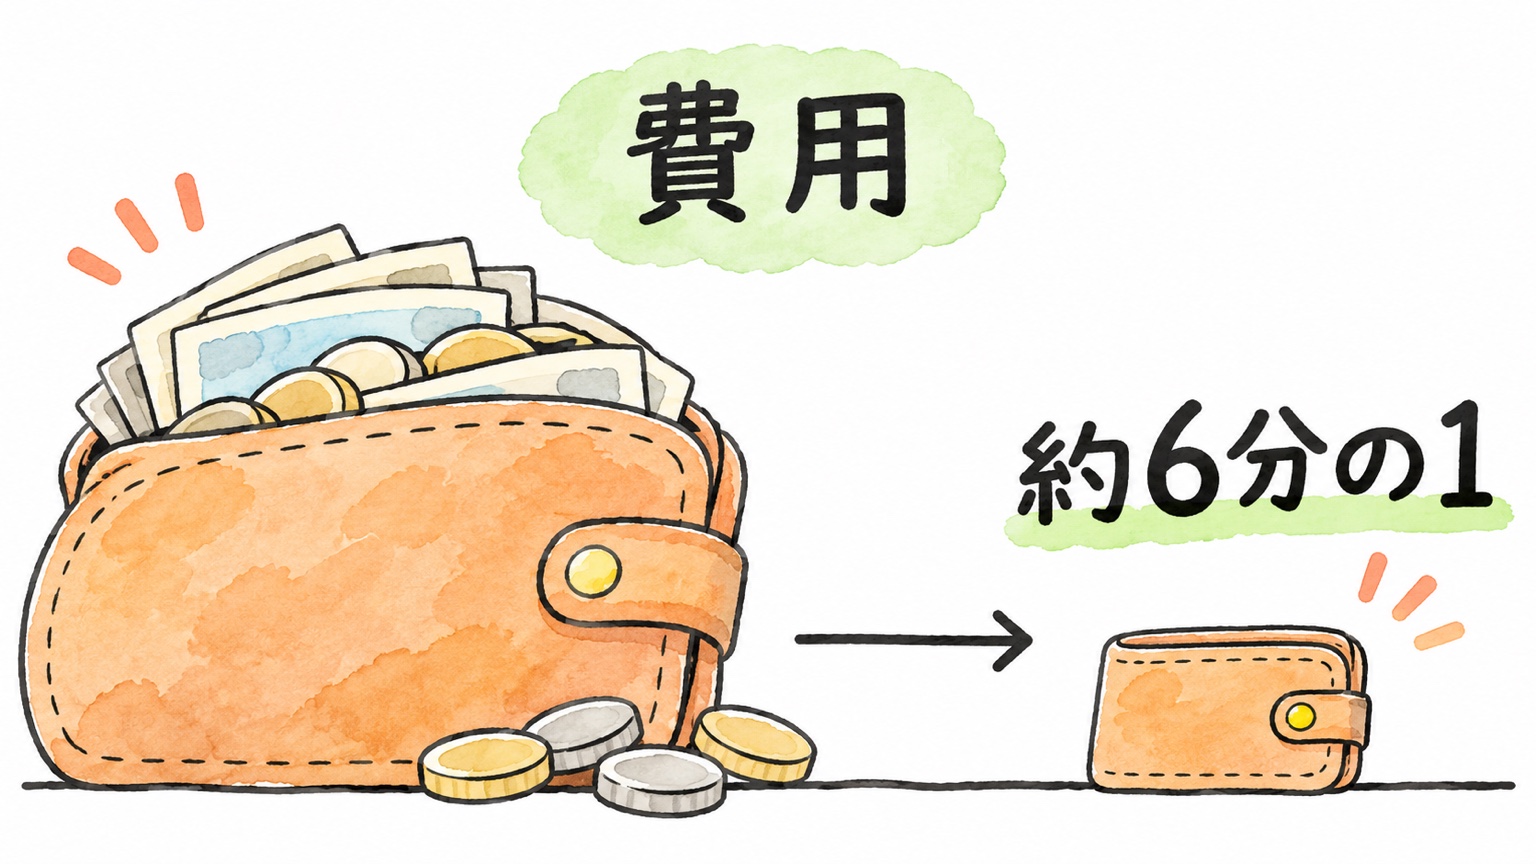
差がはっきり出るのは費用です。MKAの1課題あたりの平均API費用は、Carbonが約6ドル、Fable 5.2が約35ドル。約6分の1の費用で、ほぼ同じ品質に届いています。
やり取りの回数も、Carbonは平均約47回で、Fable 5.2の約3分の1でした。
ほかの評価でも、向きは同じです。
- コード編集ツールの評価:正答率はともに約60%。1課題の費用は、Carbonが約9ドル、Fable 5.2の最大設定が約33ドル
- 業務の自動化の評価(Zapier):Carbonの費用は、Fable 5.2の半分以下。ただし費用の算出基準は、両者で完全には同じではありません
Fable 5.2のAPI単価は入力8ドル・出力40ドルで、12月からのCarbonの2倍です。単価の差より、仕事1件で使う量の差が大きく効いています。
読むときの条件が1つあります。ここでの費用は、APIの使用量から計算した課題あたりの平均で、人が確かめて直す時間は入っていません。
また、Fable 5.2は思考の設定を下げると安くなります。どの設定なら必要な品質に届くかまで含めて、比べる必要があります。
特徴3 照合:資料どうしの関係を追って確かめる力
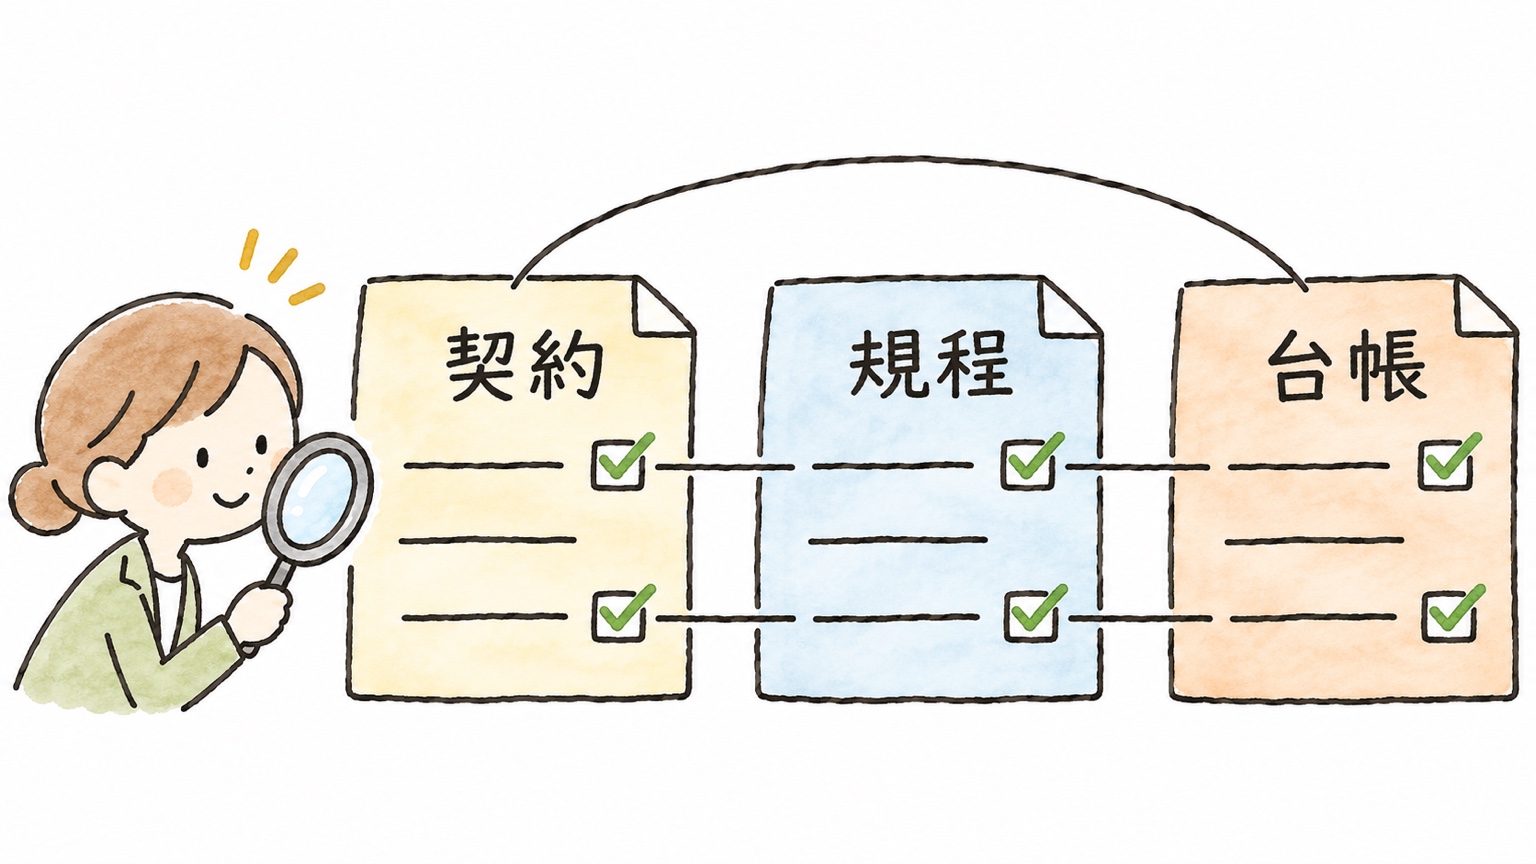
3つ目の特徴は、資料どうしの関係をたどり、食い違いなく確かめる力です。
さきほどの人員配置の課題を、もう一度見てみます。AIは、帯のように絡み合った図から部門間の人の流れを追い、人員の数字や配置ルールと照らし合わせます。
見栄えだけでは点が取れない、照合の課題です。 公開されている課題の資料と採点例は、こちらのページにまとめました。
長い資料の中で関係を追う力は、OpenAIが公開した「GraphWalks(グラフウォークス)」という評価で測れます。点どうしのつながりを大量のテキストで渡し、指定した点から何段階か先にある点を、すべて答えさせる評価です。問題の例は、こちらのページにもまとめました。
点数は、必要な点を取りこぼしても、余計な点を混ぜても下がる仕組みです。Googleの比較表にある、とても長い入力(25万〜100万トークン)でのGraphWalksの結果は次のとおりでした。
- Gemini 4 Carbon:約96
- Gemini 4 Argon:約84
- GPT-6 Astra:約72
この表にFable 5.2の値はなく、旧版のFable 5.1が約65でした。Carbonは前の版のArgonから10点以上伸び、長い資料の中でつながりを見失わない力がはっきり上がっています。
ただし、これは関係がはっきり書かれた一覧をたどる力です。契約書の例外条項や、議事録の中の因果関係のように、自然な文章から関係を読み取る力は別に考える必要があります。関係を取り出す工程と、取り出した関係をたどる工程を、分けて見るとよいでしょう。
確かめる姿勢を示す評価もあります。Googleの誠実性の評価では、欠けた実験データを勝手に補わず、方法の問題を指摘する力がArgonから大きく上がりました。一方で、知識問題の評価では誤答が増えた設定もあるため、重要な数字は最後に人が原文で確かめましょう。
会社の仕事なら、契約・規程・管理台帳の突き合わせや、システム移行での依存関係の確認に当たります。Googleも、複数のシステムにまたがる障害の原因調査を、得意な仕事に挙げています。
Carbonに向く仕事と、Fable 5.2を試す場面
3つの特徴を合わせると、Carbonが向くのは、コスパが要り、しっかり確認することも求められる仕事です。
- 複数資料の突き合わせとレビュー:契約と規程、台帳どうしの整合を見る
- 決めた書式で繰り返し作る報告・集計:図表とルールを照合し、同じ形の資料を作る
- テストで確かめられる移行や原因調査:結果を機械で確かめられる仕事
最後の点には実例があります。Googleの発表に載った利用企業HubXのエンジニアは、1万4,000件のテストを持つコードで実際の不具合16件を直させたと述べています。解決率は94%でした。修正で別の機能を壊すこともなかったそうです。テストが薄い古いシステムに、そのまま当てはまる数字ではありません。
一方で、Carbonの結果が完成条件に届かない仕事は、Fable 5.2にも同じ条件で作らせてみる価値があります。そのとき見るのは、追加の費用で、どの手直しが減ったかです。
なお、「Carbonは地道な作業向け、Fable 5.2は創造的な仕事向け」と単純に分ける根拠は、今回の評価からは出てきません。MKAの品質の差も小さく、Carbonを定型の処理だけに限る必要はないでしょう。
「どれが賢いか」から「どの仕事に、いくらで」へ
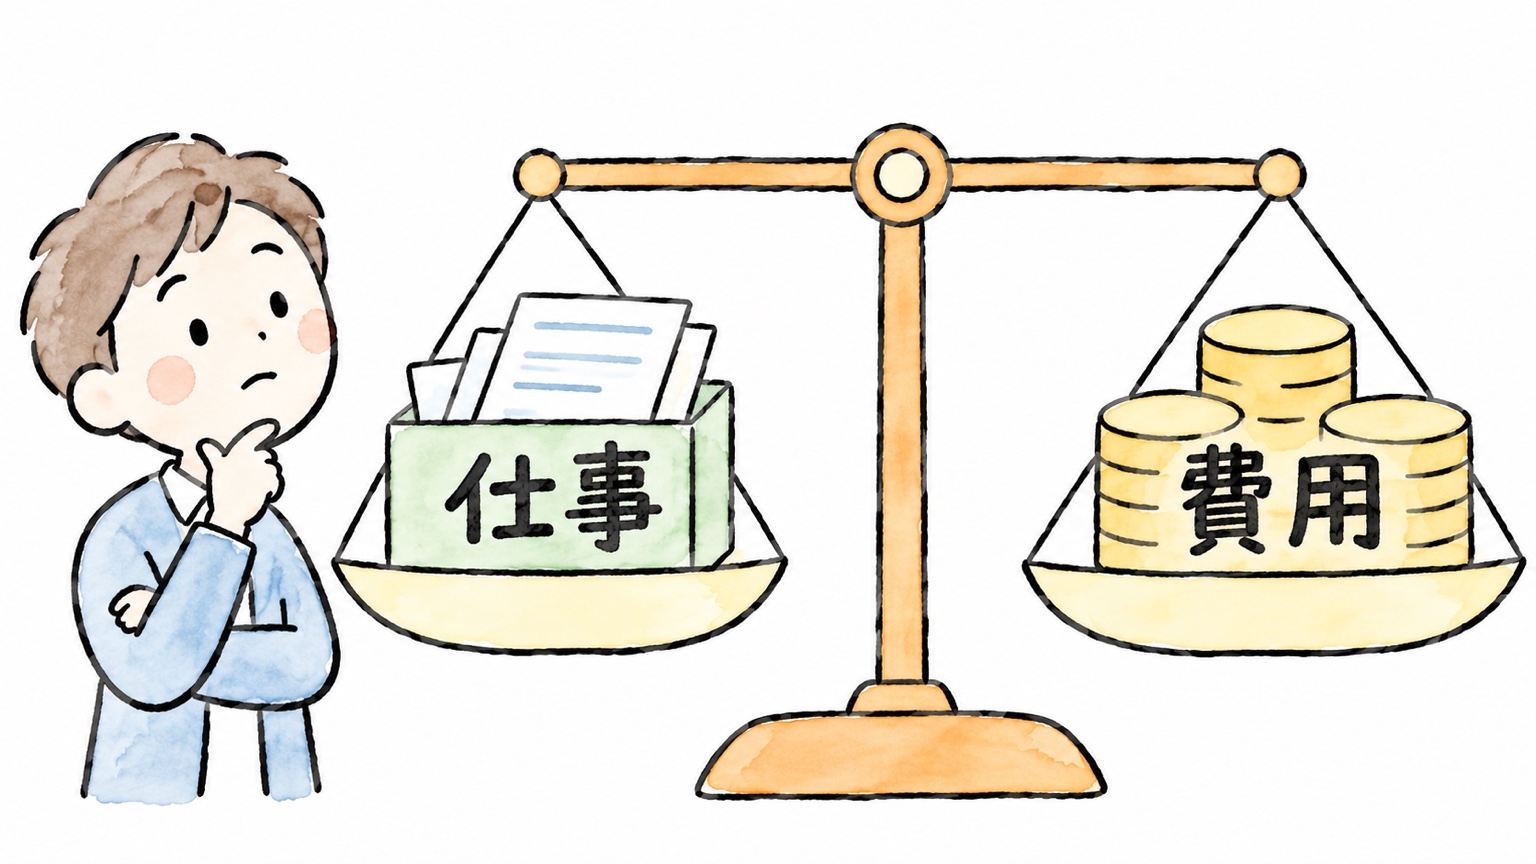
僕の見立てですが、モデル選びは「どれが賢いか」から、「必要な品質をいくらで得るか」へ移っています。MKAのように品質が近いなら、費用の差が効いてきます。Carbonで完成条件に届かない仕事は、Fable 5.2も試せばよいでしょう。
試すときの単位は、トークン単価ではありません。同じ完成条件で両モデルを試し、失敗や再実行を含むAPI費用に、人の確認・修正にかかった人件費を足し、合格した件数で割ります。合格した成果物1件あたりの総費用で比べるのが確実です。
前回、Fable 5.2に研修の材料一式を任せたときも、85点を90点以上にする最後の確認は人の仕事でした。どのモデルを選んでも、最終判断を人が持つことは変わりません。
MKAが示したのは、近い品質の成果物を低いAPI費用で作れることです。資料を突き合わせる仕事でこの差を活かし、判断に使える時間を増やしていきましょう。
よくある質問(FAQ)
Q1. Gemini 4 Carbonは、どんな仕事が得意なのか
Fable 5.2に近い精度を安く出せることと、資料どうしを照合して確かめる力が特徴です。契約・規程・管理台帳の突き合わせや、テストで確かめられる移行・原因調査のように、コスパと確認の両方が要る仕事に向きます。
Q2. Gemini 4 CarbonとFable 5.2の費用は、どのくらい違うのか
MKAの1課題あたりの平均API費用は、Carbonが約6ドル、Fable 5.2が約35ドルで、約6分の1です。ただしこの費用はAPIの使用量から計算した平均で、人が確かめて直す時間は入っていません。
Q3. Carbonで完成条件に届かない仕事は、どうすればよいのか
Fable 5.2にも同じ完成条件で作らせてみる価値があります。見るのは、追加の費用でどの手直しが減ったかです。両モデルを、失敗や再実行を含むAPI費用に人の確認・修正の人件費を足し、合格した件数で割った「合格1件あたりの総費用」で比べます。
資料の照合や確認を、どこまでAIに任せ、どこを人が見るか。AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」で、実務を持ち寄りながら探っています:https://frontier-leaders.vercel.app/
2時間で、AI活用術を実践のハンズオンで学べます。Excelの面倒作業を「1クリック化」する回など、過去回はアーカイブで受講できます:https://handson.workstyle-evolution.co.jp/
毎週のAIニュースと新しいモデルの比較を、動画で追えるYouTube『いけともch』:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事
人気記事RANKING
-

Gemini 4 Carbonは何に向く?Fable 5.2に近い品質を約6分の1の費用で出す、資料照合の強み
-

AIで写真を編集する方法|FLUX.1 Kontextの実践プロンプト10種と失敗5例
-

FaceFusionでフェイススワップを完全マスター|初心者からプロまで使える詳細ガイド
-

PwC予測:2035年のAI進化で企業組織が根本変革へ
-

ComfyUI完全ガイド – プロダクションレベルのパイプラインを作るテクニック
カテゴリー
- 主要AIサービス (114)
- 画像生成AI (87)
- 動画生成AI (114)
- 音楽・音声生成AI (28)
- AI開発・効率化ツール (153)
- AIのビジネス活用 (198)
- 教育×AI (19)
- AIの知識&トレンド (239)
- いけともサブチャンネル (420)
- AIエージェント時代の働き方 (1)
タグ
Agent V3
AI字幕
AI字幕ツール
Alibaba
Amazon Seller Assistant
Amazon Seller Central
AP2
ATOS
ByteDance
CAG
Cognition AI
Comscore
cotomi Act
DAW
DevOps
Gemini Advanced
GUGA
HeyGen
HunyuanImage
HunyuanImage-2.1
IndexTTS2
JR東日本
NEC
OpenAI Platform
Oracle
Perplexity Search API
Qwen3-Next
Replit
SeeDream
SongBloom
Stargateプロジェクト
Suno Studio
Thinking Machines
インコンテキストラーニング
カスハラ
コネクタ
ステム分離
ソフトバンクグループ
データセンター
パナソニックコネクト
事故対応
動画解析AI
暗黙知
決定論性
鉄道運行管理
公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ