
Gemini音声読み上げで自分の声を複製|1分約1.35セント、ElevenLabsとの違い
Gemini音声読み上げで自分の声を複製|1分約1.35セント、ElevenLabsとの違い
- Googleが2026年9月23日、声の設計・複製・演技指定ができる音声生成モデルを発表しました
- 約30秒の録音と本人の同意録音で声を複製でき、料金はFlashで1分約1.35セントです
- 本人の声を使うなら候補は絞られます。日本語ランキングは既製の声どうしの比較です
書き上げた記事や研修の資料を、自分の声の「読み上げ版」でも届けられたら。そう考えたことはありませんか。
録り直す時間はない。でも機械っぽい読み上げでは、自分の発信として出しにくい。
2026年9月23日、Googleが音声生成モデル「Gemini 3.8 Flash TTS」と「Flash-Lite TTS」を発表しました。自分の声の複製や新しい声の設計もできるこのモデルを、ElevenLabsやOpenAIと比べながら整理します。
目次
Flashは制作向け、Liteは量産向け
発表したのは、GoogleのGemini Audioチームです。公式ブログは、プロダクト担当のLeland Rechisさんと、チームを代表する研究責任者のAlan Cowenさんの連名で公開されました。
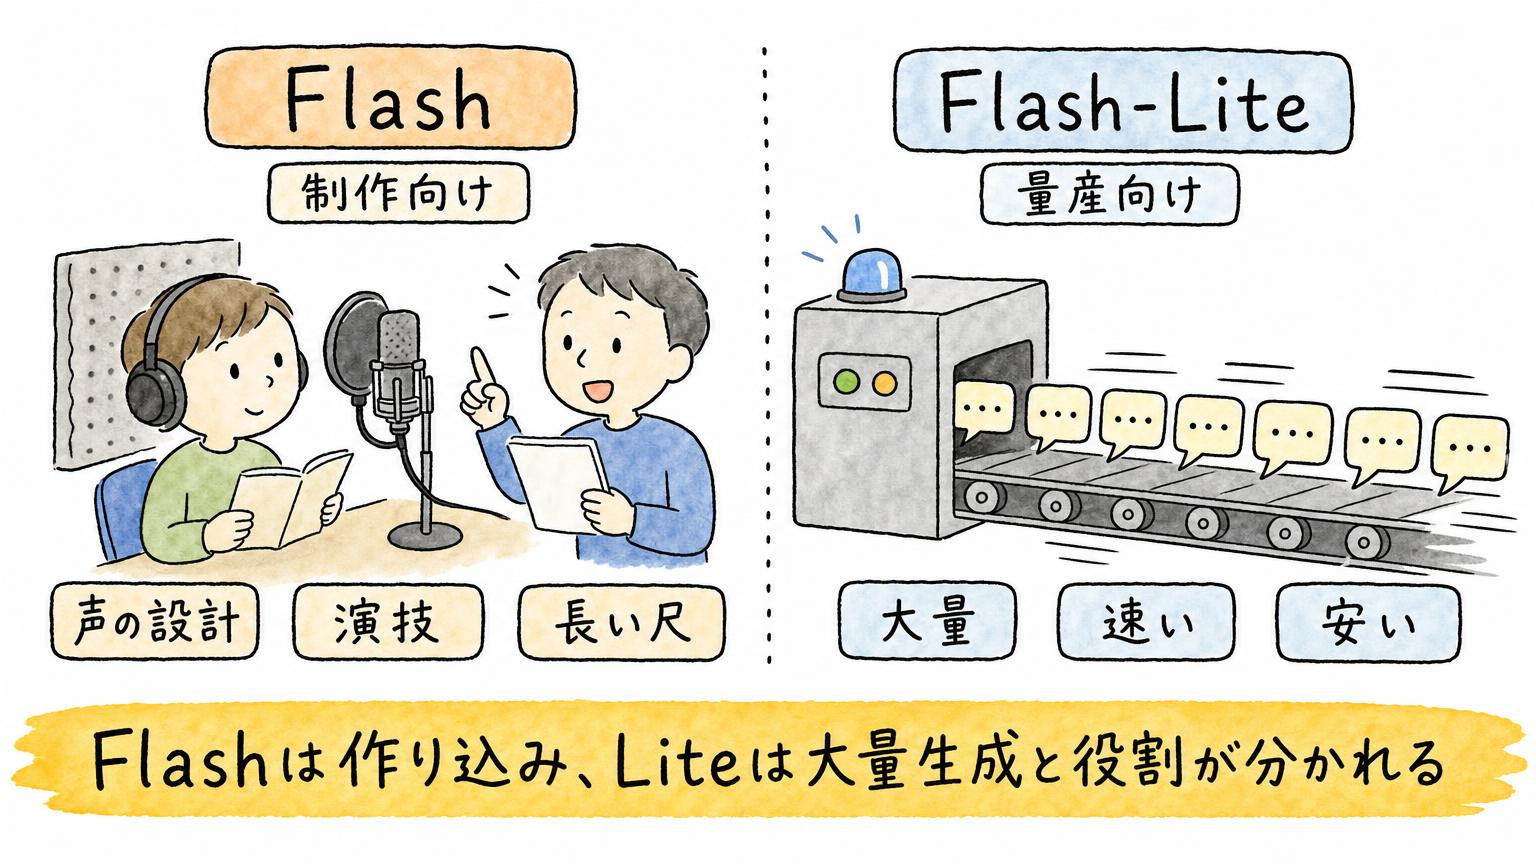
2つのモデルは役割がはっきり分かれています。Flash TTSは、声を一から設計し、台詞ごとに演技をつけ、長い尺でも声を崩さないことを狙った制作向けのモデルです。
Flash-Lite TTSは、大量の音声を低い遅延とコストで作る量産向けです。
これまでのTTS(テキスト読み上げ)が原稿を読むだけの「読み上げ機」だとすると、Flash TTSは声優を選び、演出をつけて収録する「収録スタジオ」に近い発想です。読み上げから、演出へ。今回の発表の軸はここにあります。
▶︎ あわせて読みたい:同じGemini Audioチームの「話しながら裏で作業する」音声AI
声は「選ぶ」から「作る」へ
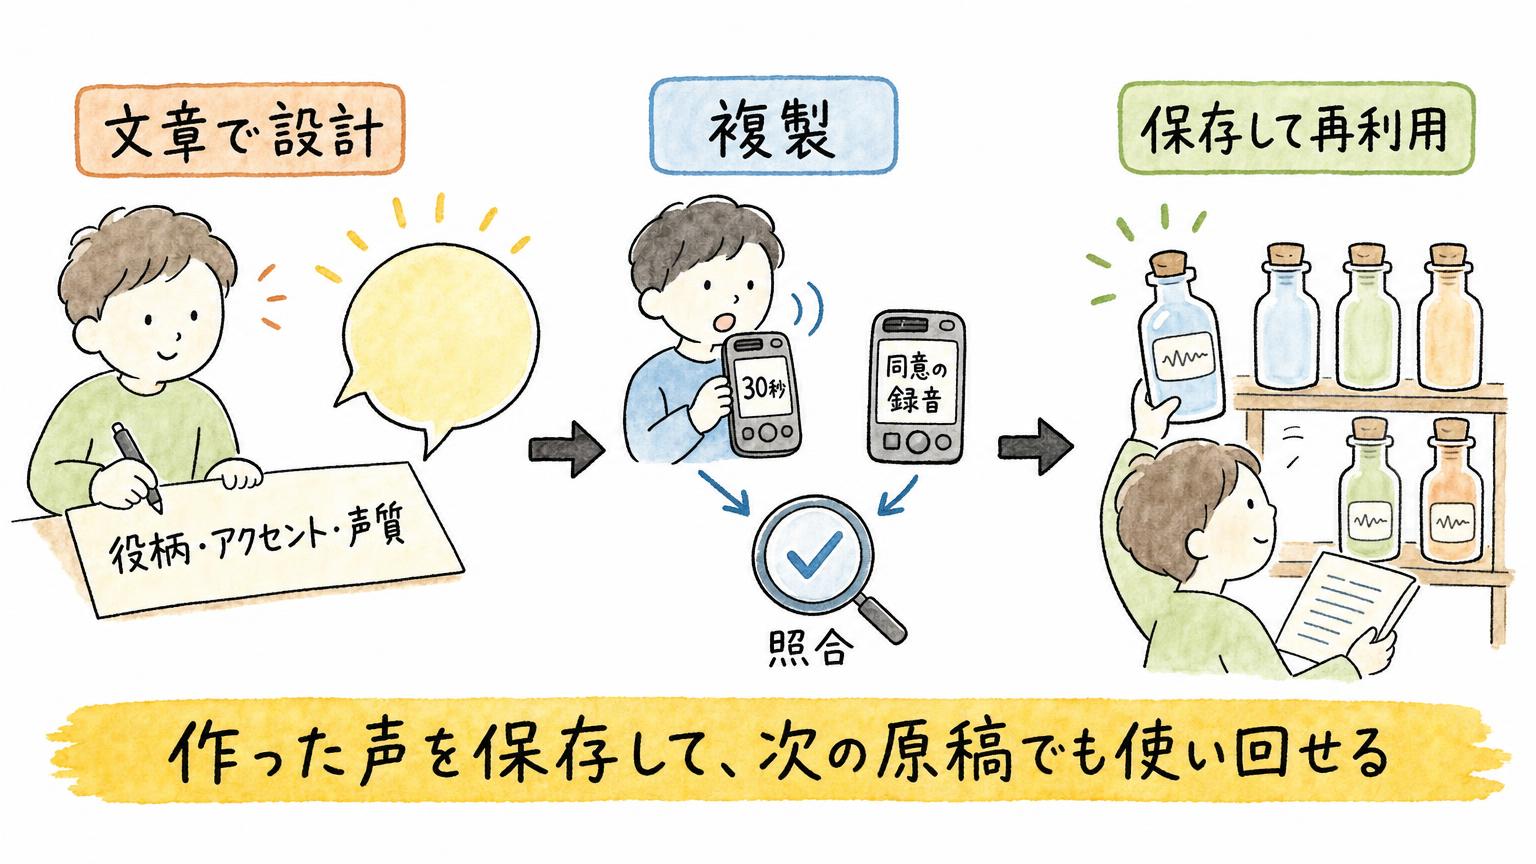
これまでのTTSは、用意された声の一覧から近いものを選ぶのが基本でした。Flash TTSでは、役柄やアクセント、声質を文章で書くと、それに合う新しい声を設計できます。既製の声も2,000以上から選べるとGoogleは説明しています。
もうひとつが声の複製です。本人、または利用する権利のある声を約30秒録音して渡すと、その声を再現します。
ここで大事なのが同意の仕組みです。声を作る前に、声の持ち主本人による同意の録音を出す必要があり、それが参照音声の話者と一致するかを照合します。他人の声を勝手に複製しにくくするための設計です。
作った声は保存して、次の原稿でもそのまま使えます。スタジオで言えば、専属の声優を1人抱えるようなものです。声が、使い回せる資産になります。
台本に「ト書き」を書き込める
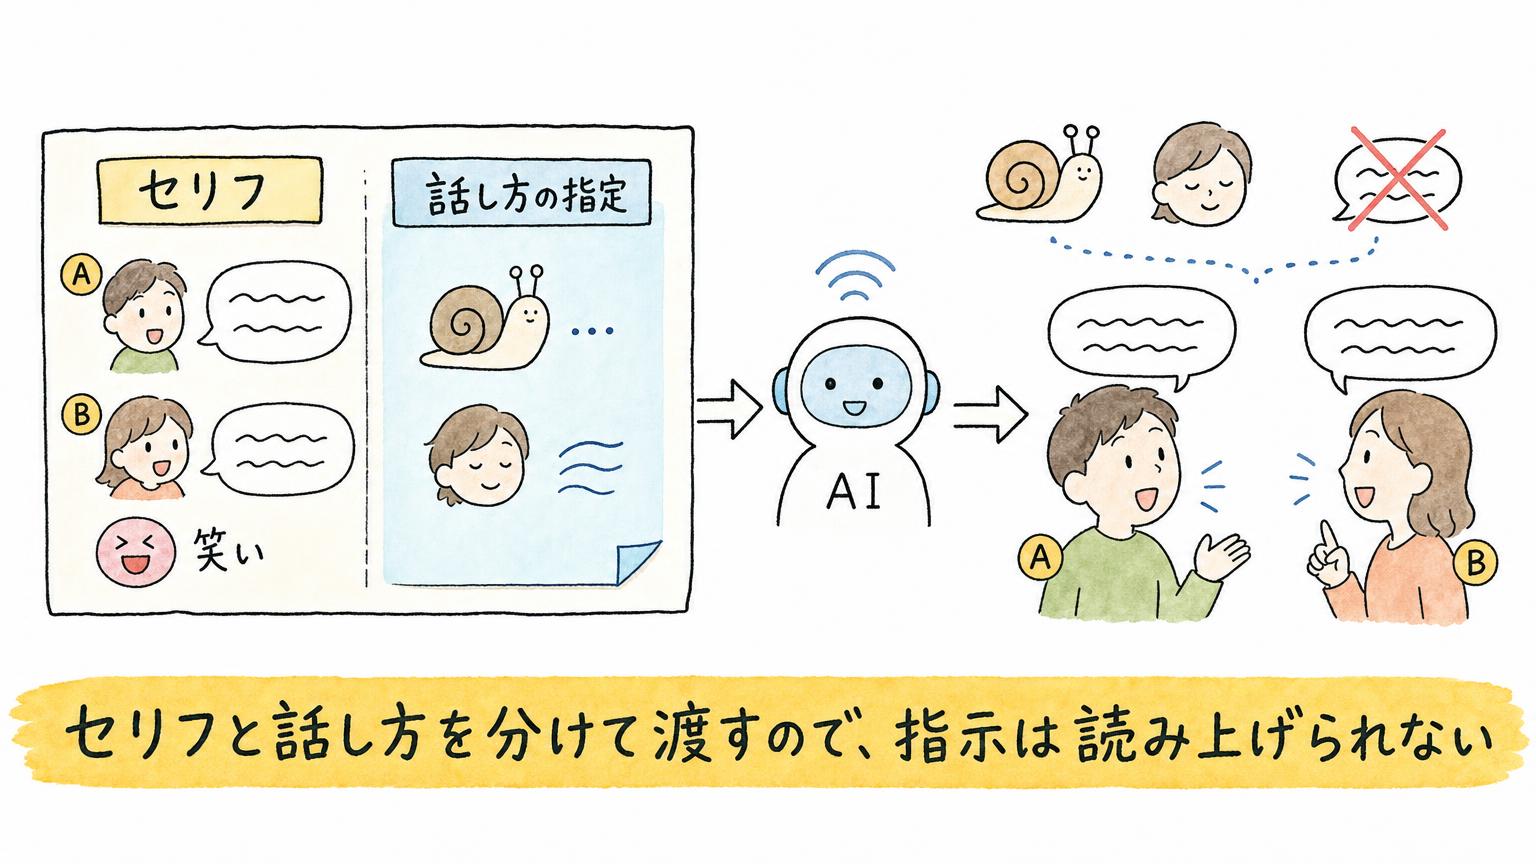
Flash TTSのもうひとつの特徴は、原稿の読み方を細かく指定できることです。
仕組みはシンプルで、台詞の本文と、話し方の指定を分けて渡します。本文はそのまま読む対象として扱われ、感情やペースのような継続的な指定は、speech_metadataという別の欄に置きます。
演劇の台本でいえば、本文がセリフ、話し方の指定が「ト書き」です。セリフとト書きを分けて渡すので、指示の文言まで読み上げてしまう事故を避けやすくなります。
本文の中には、笑いやため息といった短い発声も入れられます。話者を2人立てて、掛け合いを1本の台本として指定することもできます。
Googleは、何時間も続く音声でも声質と話者のブレを抑える設計だとしています。長尺で声が揺れないかどうかは、講座や記事を音声化するときに最初に気になる点です。
日本語は両モデルが対応、1分あたり約1.35セント
日本語はFlashとFlash-Liteの両方が対応しています。対応言語はFlashが130以上、Flash-Liteが100以上です。
開発者はGemini APIとGoogle AI Studioから試せます。一般の利用者向けには、FlashがGemini Notebookに、Flash-LiteがGoogle Vidsに入るとGoogleは発表しました。企業向けのGemini EnterpriseでのAPI提供は、今後の予定とされています。
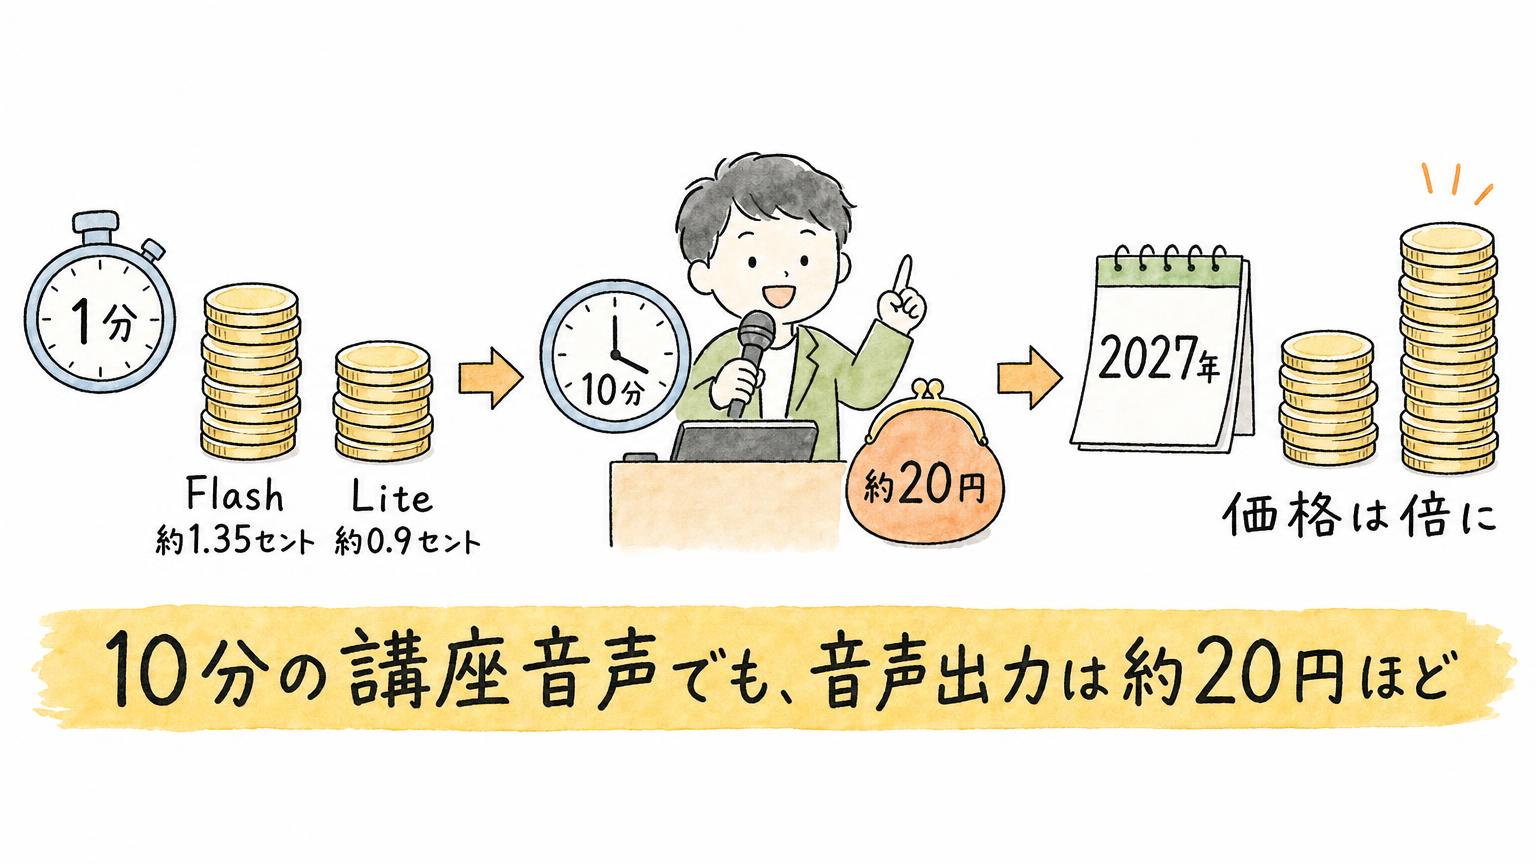
料金表では、標準APIの音声出力が100万トークンあたりFlashで9ドル、Liteで6ドルです(2026年末まで)。音声1秒は25トークンと換算されるので、1分あたりに直すとFlashが約1.35セント、Liteが約0.9セントになります。
入力テキストは別料金で、100万トークンあたり0.5ドルです。2027年1月からは、音声もテキストも価格が倍になります。それでも10分の講座音声で、音声出力だけならFlashで約0.135ドル、1ドル150円換算で20円ほどです。
生成された音声には、Googleが生成物に埋め込む電子透かし「SynthID」が入ります。
▶︎ あわせて読みたい:Gemini Notebookが音声で「対話」できるようになった話
知りたい箇所だけ、その場で音声にする
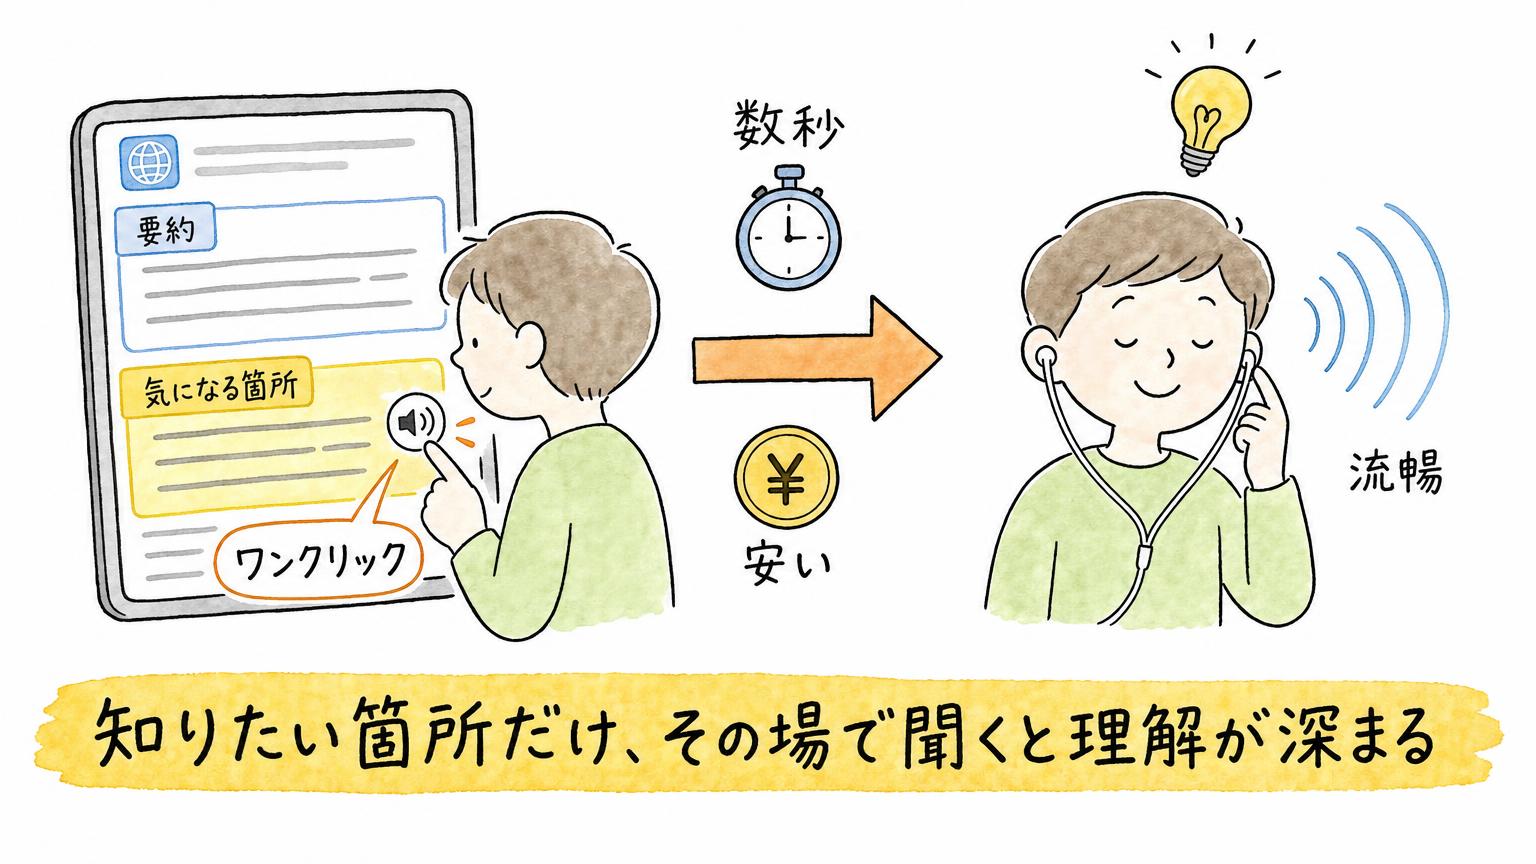
僕自身は、こんなトライをしました。自分で作っているニュースアプリで、要約やニュース原稿の気になる箇所だけを、ワンクリックでその場で音声にできるようにしたのです。
ボタンを押すと、本当に数秒で音声ができあがります。コストも非常に安く、しかも読み上げがとても流暢です。
その場で耳から聞くと、文字だけで読むよりもニュースの理解が深まります。記事を丸ごと音声版にするのではなく、知りたいところだけを、その場で聞く。音声生成には、こういう使い方も出てきています。
大量生成と低い遅延・コストを狙ったFlash-Liteのようなモデルは、まさにこの「その場で声にする」使い方と相性がよいはずです。
ElevenLabs・OpenAIとは「本人の声」で分かれる
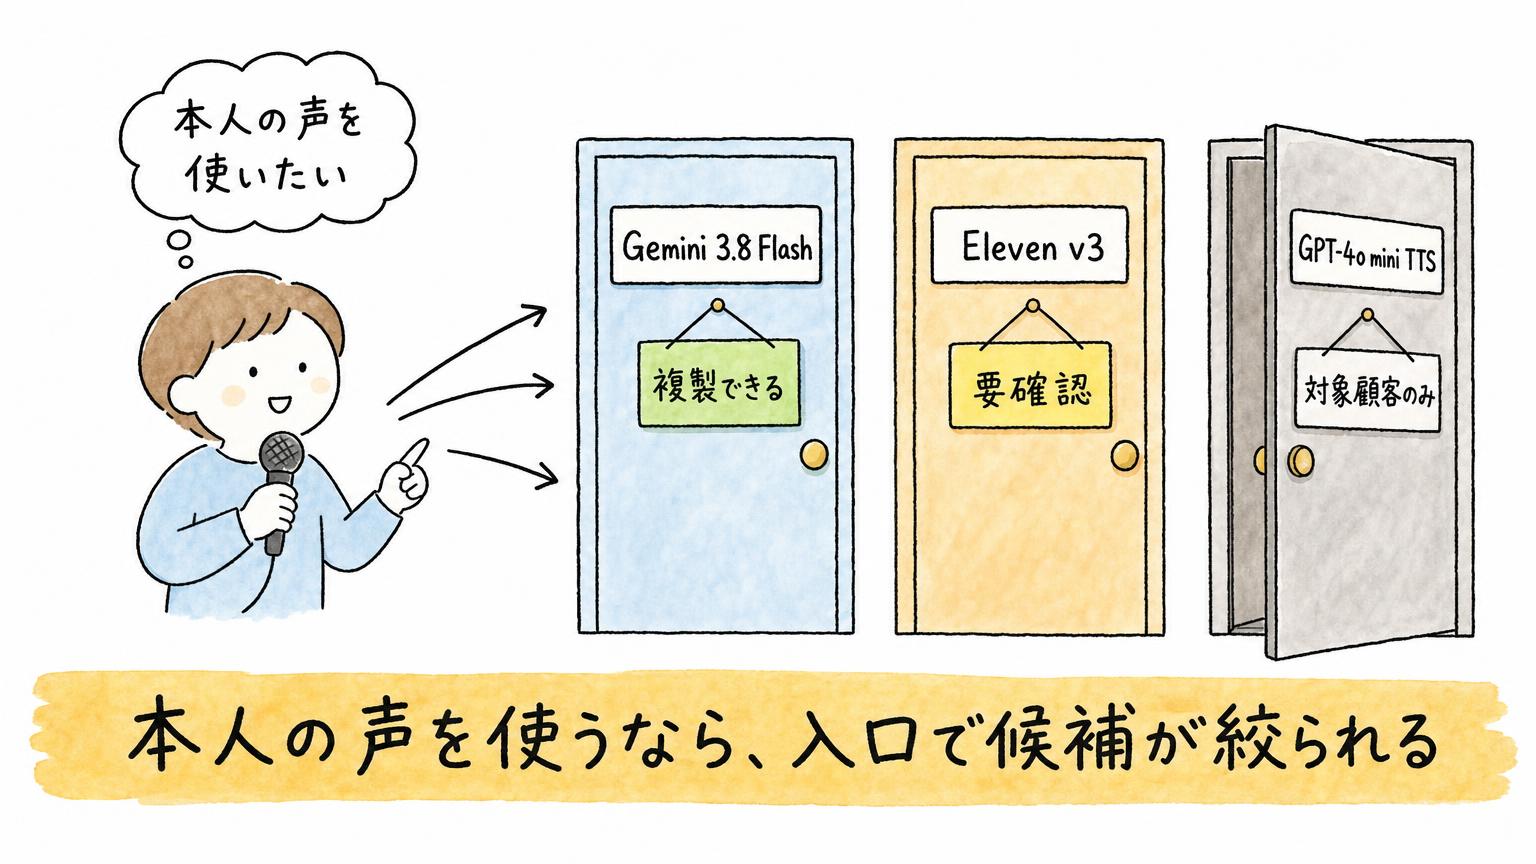
比較するのは、音声制作で定番のElevenLabs「Eleven v3」と、OpenAIの「GPT-4o mini TTS」です。3つを一言でまとめると、次のようになります。
- Gemini 3.8 Flash TTS:声の設計・複製、演技指定、長尺の安定を一続きで提供
- Eleven v3:声の設計、感情タグ、複数話者に対応。1万を超える声のライブラリが厚い
- GPT-4o mini TTS:既製の声への指示とストリーミングが手軽。本人の声は対象顧客のみ
Eleven v3は、演技の面ではGemini 3.8 Flashとよく似ています。ElevenLabsのドキュメントでは、日本語を含む70以上の言語に対応し、笑いやささやきを指示するタグ、複数話者の会話にも対応しています。
一方で声の複製は、ElevenLabsのドキュメント上、対応モデルとして挙がっているのがv2系です。Eleven v3で本人の声をそのまま使えるかは、実際に試して確かめる必要があります。
GPT-4o mini TTSは、用意された声に文章で話し方を指示する使い方が手軽です。アクセントや感情、話す速さを指定でき、生成しながらストリーミング再生もできます。
ただし、本人の声を再現するカスタム音声は、対象となる顧客に限られます。利用資格を得たうえで、声の持ち主の同意録音と参照音声を提出する流れです。
つまり、自分の声で作るなら、入口で選択肢が絞られます。既製の声で十分なら3つとも候補ですが、本人の声が必須なら、まずGeminiとElevenLabsを試すのが現実的です。
日本語評価はFlashが最上位、ただし数字の読み方に注意
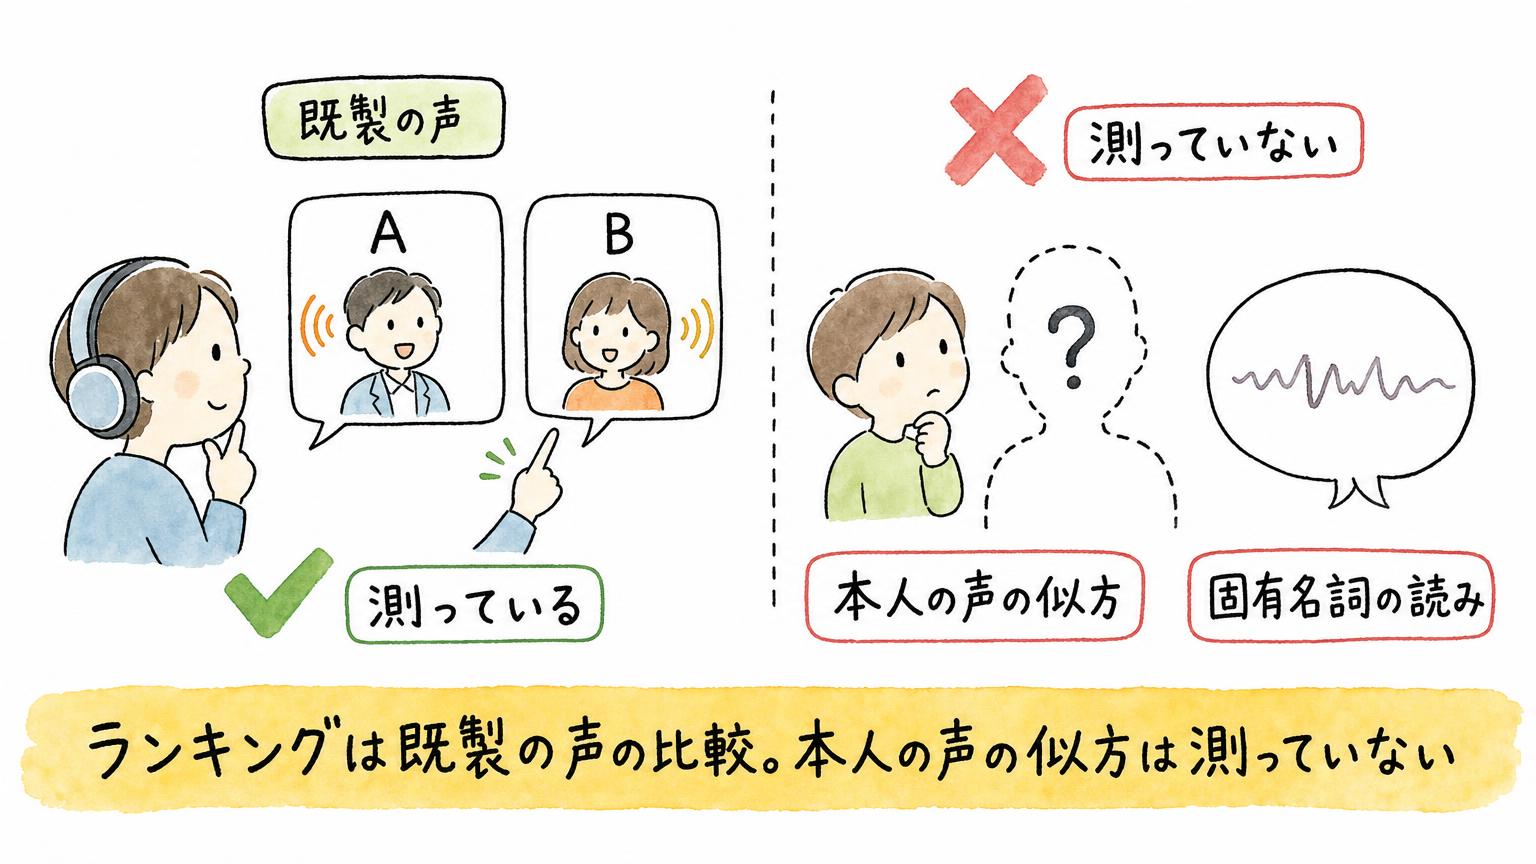
音声の聴き比べサイト「Voice Arena」には、日本語の「コンテンツ制作・教育」部門のランキングがあります。人が2つの音声を聴き比べて良いほうを選び、その投票をチェスのレーティングと同じ考え方で点数にしたものです。
表示値は次のとおりです。
- Gemini 3.8 Flash TTS:1220±43
- Gemini 3.8 Flash-Lite TTS:1173±49
- Eleven v3:1023±23
- GPT-4o mini TTS:965±22
比べた3社の中ではFlashが最上位で、Eleven v3とは約200点の差があります。評価方法の説明によると、200点差は直接比べたときに上位が約76%の確率で選ばれる開きです。
ただ、部門全体では1位から3位までが、統計的には同じ順位のグループとして表示されています。FlashとLite、3位の前世代Gemini 3.1 Flash TTSとの差は、優劣とまでは言えません。
もうひとつ、この評価は各社の既製の声だけで行われ、声の複製は対象外です。本人の声がどれだけ似るかや、AI関連の固有名詞を正しく読めるかは測っていません。
料金も単位がそろっていません。Googleは音声トークンで、Eleven v3のAPIは1,000文字あたり0.10ドルで課金します。日本語の文字数と音声の長さは単純には換算できないので、同じ原稿を実際に生成して、出てきた費用で比べるのが確実です。
自分の声で音声化するなら、4つの原稿で試す
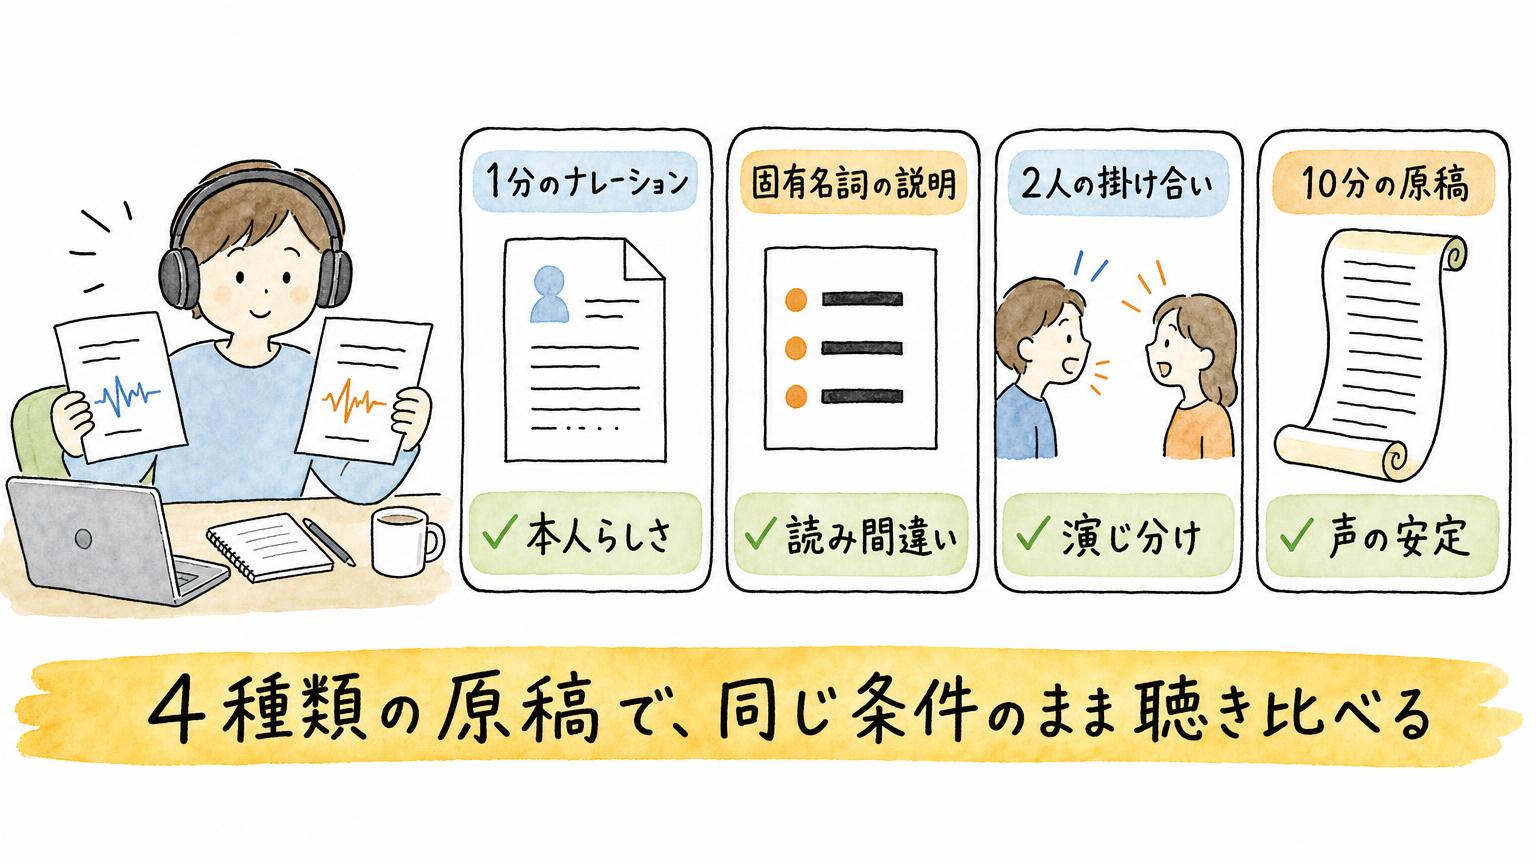
記事や講座を本人の声で音声化したいなら、まずGemini 3.8 FlashとElevenLabsに、同じ本人の音声と同じ日本語原稿を渡して聴き比べるのが近道です。
試す原稿は4種類あると、違いが見えやすくなります。
- 1分ほどの通常のナレーション
- 固有名詞やAI用語が多い説明
- 2人の掛け合い
- 10分程度の長い原稿
1で「本人らしさ」、2で「読み間違い」、3で「演じ分け」、4で「声の安定」を見ます。GPT-4o mini TTSは既製の声での読み上げとして比べ、カスタム音声を使える契約なら本人の声も加えます。
判断は、1回あたりの料金だけでなく、読み間違いを直して作り直す回数と編集時間まで含めた「完成までのコスト」で比べます。安いモデルでも、固有名詞のたびに直していては結局高くつきます。
組織で使う場合は、論点がもうひとつ増えます。研修や社内教材を講師の声で量産できる一方で、誰の声を、誰の同意で、どこまで使うかを管理する仕事が新しく生まれます。
同意録音を前提にしたGoogleとOpenAIの設計は、この管理を使う側にも求めていると読めます。
よくある質問(FAQ)
Q1. Gemini 3.8 Flash TTSで自分の声を複製するには何が必要ですか?
本人、または利用する権利のある声を約30秒録音した参照音声と、声の持ち主本人による同意の録音が必要です。
同意の録音が参照音声の話者と一致するかが照合されるので、他人の声を勝手に複製しにくい設計です。作った声は保存して、次の原稿でも使い回せます。
Q2. Gemini TTSの料金は1分あたりいくらですか?
標準APIの音声出力は100万トークンあたりFlashで9ドル、Flash-Liteで6ドルです(2026年末まで)。音声1秒は25トークンなので、1分あたりFlashが約1.35セント、Liteが約0.9セントになります。
入力テキストは別料金で100万トークンあたり0.5ドルです。2027年1月からは音声もテキストも価格が倍になります。
Q3. ElevenLabsやOpenAIの音声読み上げとは、どう使い分ければよいですか?
既製の声で十分なら、Gemini 3.8 Flash TTS、Eleven v3、GPT-4o mini TTSの3つとも候補です。本人の声が必須なら、まずGeminiとElevenLabsを試すのが現実的です。OpenAIのカスタム音声は対象顧客に限られます。
比べるときは、通常のナレーション・固有名詞の多い説明・2人の掛け合い・10分程度の長い原稿の4種類を同じ条件で生成し、作り直しの回数まで含めた完成までのコストで判断します。
音声生成のような新しいAIを、自分の仕事や発信にどう組み込むか。AIを徹底的に使いこなすためだけのコミュニティ「フロンティア・リーダーズ」で、実務を持ち寄りながら試しています:https://frontier-leaders.vercel.app/
ニュースアプリに音声ボタンを付けたように、自分専用の道具を2時間で作るハンズオンがあります。「AIで2時間でツールを作る会」などの過去回をアーカイブで受講できます:https://handson.workstyle-evolution.co.jp/
最新のAIニュースは、YouTube『いけともch』でほぼ毎日解説しています:https://www.youtube.com/@iketomo-ch
■合わせて読みたい
■関連記事

公式LINEで最新ニュースをゲット


最新のAIニュースを
毎週お届け
生成AIの業務別の
ビジネス活用シーン
がわかるAIチャット
過去のAIニュースから
事実を確認できる
何でもAI相談チャット
ニュース動画の
アーカイブ